
可观测性与稳定性 / 系统课时
加入 CPU 和内存告警
加入 CPU 和内存告警
这一节在服务器总览指标之上增加两条真正可用的资源告警:CPU 高负载与内存高占用。重点不是把阈值设得越敏感越好,而是让条件持续一段时间后再触发,从而过滤正常的瞬时峰值。
学习目标
- 用 PromQL 为每台服务器分别计算 CPU 与内存使用率。
- 在 Grafana Alerting 中设置阈值、评估间隔和 Pending period。
- 通过状态预览验证告警会经历正常、等待触发和恢复过程,而不是因瞬时抖动反复通知。
先定义可告警的指标
告警查询不要依赖 Dashboard 的 ${instance} 变量,因为告警规则需要独立评估。让查询按 instance 保留标签,Grafana 才能针对每台服务器分别创建告警实例。
CPU 使用率使用最近 5 分钟的 idle 比例反推。以下 PromQL 可直接在 Prometheus 或 Grafana 查询编辑器执行。
100 * (
  1 - avg by (instance) (
    rate(node_cpu_seconds_total{job="node", mode="idle"}[5m])
  )
)
预期结果
{instance="<HOST>:<PORT>"} <CPU_PERCENT>内存使用率优先使用 MemAvailable,因为它比“总内存减空闲内存”更贴近 Linux 当前还能提供给应用的可用内存。
100 * (
  1 -
  node_memory_MemAvailable_bytes{job="node"}
  /
  node_memory_MemTotal_bytes{job="node"}
)
预期结果
{instance="<HOST>:<PORT>", job="node"} <MEMORY_PERCENT><CPU_PERCENT> 与 <MEMORY_PERCENT> 都会随机器实时状态变化。如果实际抓取任务不是 job="node",应先按 Prometheus 中真实的标签修改查询,再创建告警。
设置阈值和持续时间
可以把 CPU > 85%、内存 > 90% 作为实验环境的起始阈值,而不是直接视为生产标准。创建 Grafana-managed alert rule 时,对查询结果做 Reduce,选择 Last,然后再用 Threshold 表达式判断是否超过阈值。
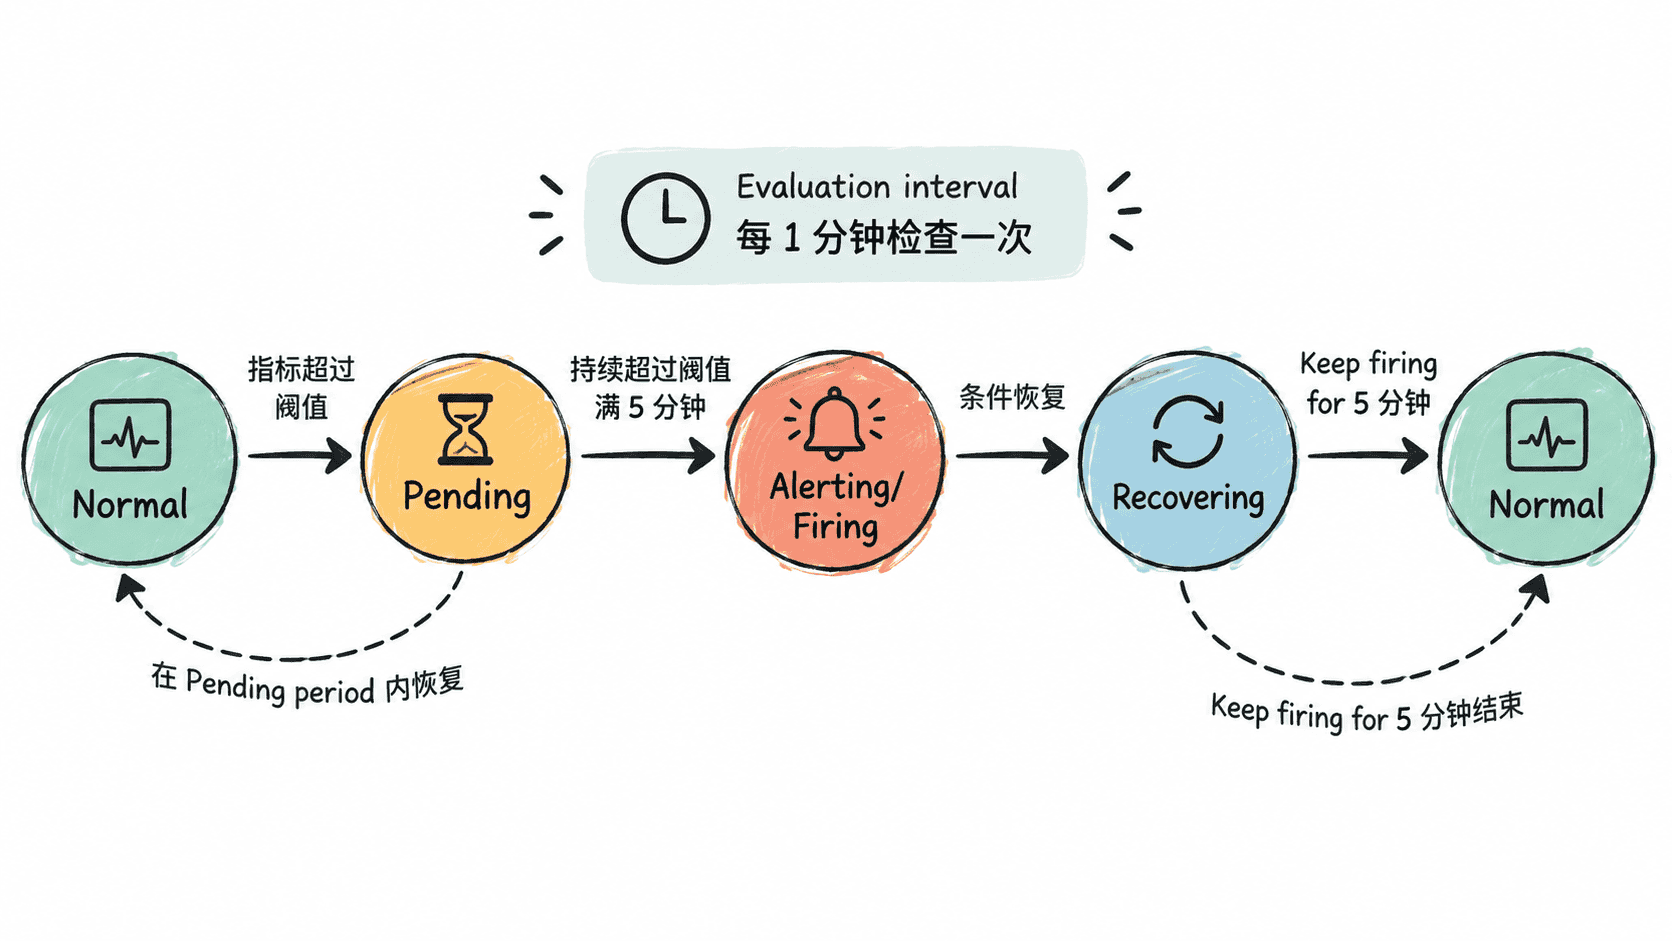
评估间隔可先设为 1 分钟,Pending period 设为 5 分钟。这样条件第一次超过阈值时只进入 Pending;只有连续满足约 5 分钟后才进入 Alerting/Firing。对于短暂尖峰,这个持续时间能避免立即通知。
如果环境容易在阈值附近来回抖动,还可以设置 Keep firing for,例如 5 分钟。条件恢复后先进入 Recovering,持续时间结束再回到 Normal,可以减少“触发—恢复—再次触发”的通知抖动。
创建两条规则
在 Grafana 的 Alerting 中分别创建 CPUHigh 与 MemoryHigh。两条规则都选择 Prometheus 数据源,并保留查询中的 instance 标签。规则的初始配置可以按下表设置,再根据真实业务基线调整。
| 规则 | 查询 | 阈值 | 评估间隔 | Pending period | Keep firing for |
|---|---|---|---|---|---|
| CPUHigh | CPU 使用率 PromQL | > 85% | 1m | 5m | 5m |
| MemoryHigh | 内存使用率 PromQL | > 90% | 1m | 5m | 5m |
通知标签建议至少增加 severity 和能够定位主机的 instance。如果已经配置 Contact point 和 Notification policy,规则进入 Alerting/Firing 后才会按策略发送通知;如果尚未配置通知通道,也可以先只验证规则状态,避免把规则调试和消息投递问题混在一起。
验证不是只看“能保存”
保存前先使用规则预览检查查询结果和阈值判断。如果当前机器负载较低,可以在测试环境临时把阈值调到略低于当前值,并把 Pending period 缩短用于验证;确认状态转换正常后,再恢复正式阈值和持续时间。
正确的现象是:第一次超过阈值后进入 Pending;在 Pending period 内恢复则回到 Normal,不发送正式告警;持续超过阈值足够久才进入 Alerting/Firing;恢复后若配置了 Keep firing for,则先进入 Recovering,再回到 Normal。
生产阈值最终应来自服务器用途、历史基线和可接受的持续压力,而不是照搬示例数值。CPU 与内存告警都具备持续时间后,平台才开始从“展示指标”升级为“只在值得处理时提醒”。