
可观测性与稳定性 / 系统课时
Prometheus 为什么主动拉取指标
Prometheus 为什么主动拉取指标
Prometheus 的核心采集方式不是让每台服务器不断把数据推过来,而是由 Prometheus 按固定周期主动访问监控目标的指标接口。理解这条拉取链路,才能判断目标为什么会变成 UP 或 DOWN,以及采集周期、网络可达性和短生命周期任务会怎样影响监控结果。
学习目标
- 理解 Prometheus Pull 模型中的主动方、目标与指标接口
- 说明主动拉取对目标发现、采集节奏和故障判断的价值
- 判断常规服务采集与需要 Pushgateway 的场景边界
Pull 模型到底怎样工作
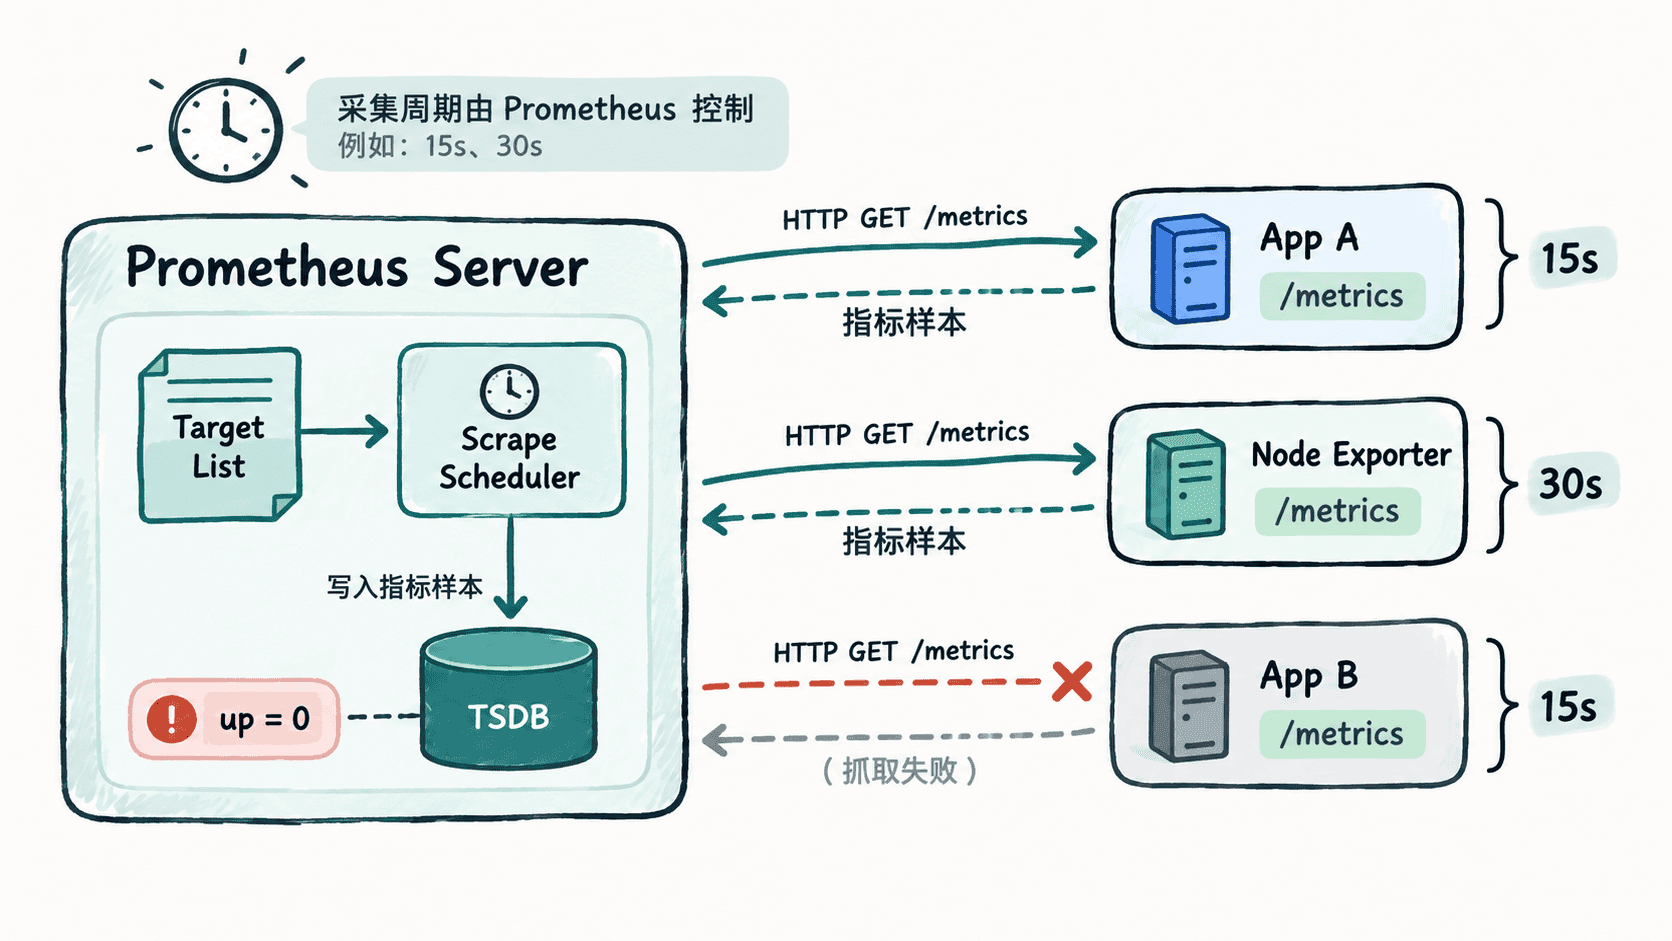
被监控的应用或 Exporter 负责暴露 HTTP 指标端点,常见路径是 /metrics。它们通常只维护当前可供读取的指标,并不需要知道 Prometheus 的地址。Prometheus 根据自己的配置或服务发现结果获得目标列表,再按照采集周期逐个发起抓取请求。
一次正常循环可以概括为:Prometheus 确定目标 → 主动请求指标端点 → 目标返回当前指标样本 → Prometheus 为样本附加目标标签并写入时序数据库。下一次采集到来时,再重复这一过程。
为什么由 Prometheus 控制采集节奏
主动拉取意味着采集周期由监控系统统一控制。例如一组主机可以每 30 秒采集一次,而关键接口可以使用更短周期。目标本身不必分别实现发送队列、重试间隔和监控服务器地址管理,采集策略集中在 Prometheus 一侧更容易统一调整。
Pull 模型也天然适合服务发现。Prometheus 可以先根据静态配置、Kubernetes 或其他发现机制得到当前目标,再决定应该抓取谁。实例扩容或下线时,目标集合随发现结果改变,而不必让每个实例主动向中心注册指标发送逻辑。
还有一个重要特点是目标无需主动上报,也能被监控是否可达。Prometheus 对某个目标执行抓取时,会生成用于描述抓取状态的 up 时间序列:抓取成功通常为 1,抓取失败为 0。因此“没有拿到业务指标”本身也能成为故障信号,而不是只能等待目标主动报告自己出了问题。
Pull 模型依赖网络可达性
主动拉取也带来明确前提:Prometheus 必须能够从自身网络位置访问目标的指标端口。如果防火墙、安全组、容器网络或监听地址阻断了这条路径,即使应用本身正常运行,Prometheus 仍然会把抓取判定为失败。
因此排查采集失败时,应把问题分成两层:先确认目标进程是否真的暴露指标,再确认 Prometheus 到目标地址的网络路径是否可达。只有端点存在且网络可访问,Pull 才能正常工作。
短生命周期任务为什么比较特殊
长期运行的 Web 服务、数据库和主机 Exporter 很适合等待 Prometheus 周期性抓取,但持续时间只有几秒的批处理任务可能在下一次采集前就已经退出。如果强行缩短全局采集周期,通常会增加大量不必要的请求和存储压力。
Prometheus 生态为这类场景提供 Pushgateway:短生命周期任务把适合保留的指标推送给 Pushgateway,而 Prometheus 仍然通过 Pull 模式定期抓取 Pushgateway。也就是说,它不是把整个 Prometheus 改成 Push 架构,而是在无法稳定等待抓取的任务与 Prometheus 之间增加一个可持续暴露指标的中间节点。
对于能够长期提供 HTTP 指标端点的服务器和应用,直接让 Prometheus 拉取通常是最简单的链路;只有目标生命周期或网络模型确实不适合直接抓取时,才需要考虑额外的推送入口。