
可观测性与稳定性 / 系统课时
为什么不能把用户 ID 当 Label
为什么不能把用户 ID 当 Label
Prometheus 的 Label 会参与时间序列身份判断,因此把用户 ID、订单号这类高基数值放进 Label,并不是简单多存一个字段,而是可能创建海量独立时间序列。本课用可计算的例子理解这种膨胀,并给出更安全的指标设计方式。
学习目标
- 理解 Label 基数与时间序列数量之间的关系
- 判断用户 ID、订单号等字段为什么不适合作为 Label
- 设计既能聚合分析又能控制基数的指标
Label 会决定时间序列身份
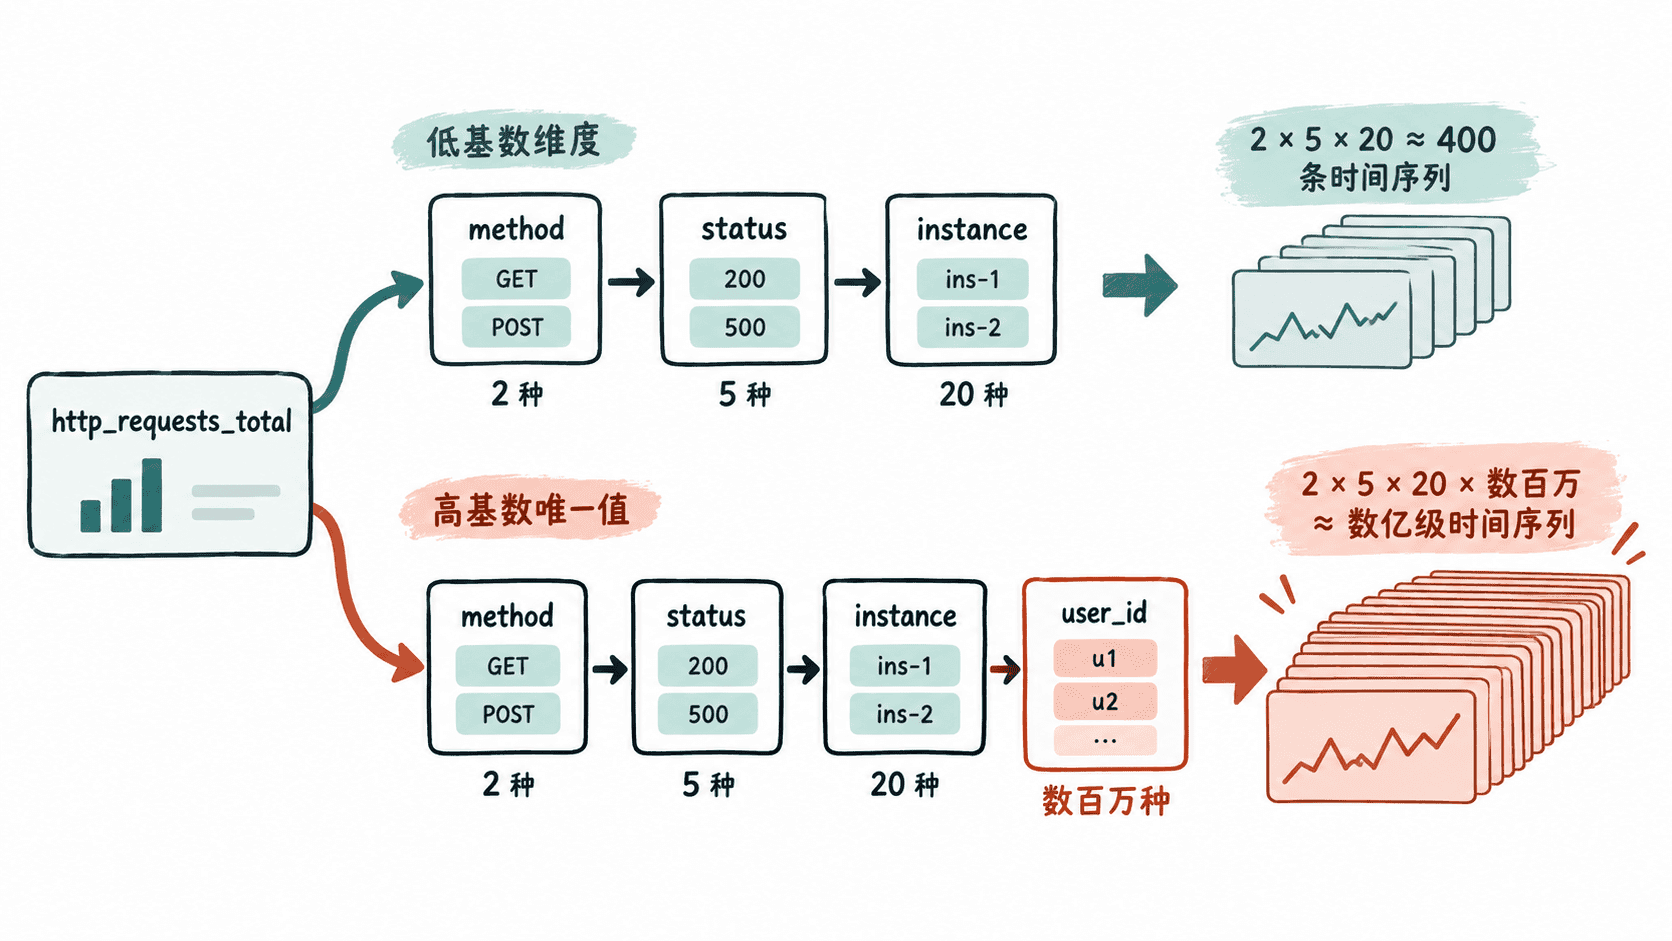
Prometheus 将“指标名 + 全部 Label 键值”视为一条时间序列。只要任意 Label 值不同,就会形成另一条序列。
例如下面两个样本虽然指标名相同,但 user_id 不同,因此属于两条独立序列:
http_requests_total{method="GET",status="200",user_id="u1001"}
http_requests_total{method="GET",status="200",user_id="u1002"}
这里的关键问题不是单个 Label 占多少字节,而是 Label 值的组合数量会直接扩大时间序列数量。如果一个指标包含 4 种请求方法、5 种状态码和 20 个实例,仅这些维度理论上就可能形成 4 × 5 × 20 = 400 条序列;再加入 100 万个用户 ID,组合上限会变成 4 亿条。
methods = 4
statuses = 5
instances = 20
users = 1_000_000

normal_series = methods * statuses * instances
with_user_id = normal_series * users

print(f'without user_id: {normal_series:,}')
print(f'with user_id: {with_user_id:,}')
预期输出:
without user_id: 400
with user_id: 400,000,000
这只是组合上限的简化计算,真实系统未必出现所有组合,但它能说明为什么唯一值接近无限增长的字段会带来危险。
高基数为什么会拖慢 Prometheus
每条活跃时间序列都需要被识别、索引并维护样本。序列数快速增长时,Prometheus 需要处理更多 Label 组合,内存中的活动序列和索引规模会上升,写入、压缩、查询和重启恢复都可能承担更高成本。
查询也会受到影响。例如按 user_id 聚合意味着查询引擎可能需要处理大量不同用户对应的序列。即使最终只展示一条汇总曲线,中间参与计算的数据仍可能非常多。
哪些字段适合作为 Label
适合 Label 的字段通常有有限、稳定并且确实需要聚合或筛选的取值,例如 method、status、region、service、instance。设计时可以先问两个问题:这个字段可能出现多少种值,以及监控告警是否真的需要按它分组。
用户 ID、订单号等业务明细通常更适合进入日志或链路追踪系统。Prometheus 指标保留聚合维度,例如记录请求总量、失败总量和延迟分布;需要定位某个具体用户时,再通过日志或 Trace 查询详细上下文。
用聚合维度替代唯一标识
假设业务希望监控登录请求,不要为每个用户建立序列,可以把指标设计成按结果、区域等有限维度聚合:
login_requests_total{result="success",region="ap-southeast"}
login_requests_total{result="failed",region="ap-southeast"}
这种设计仍然能回答“失败率是否升高”“哪个区域异常”等监控问题,同时不会让序列数量随着用户总数持续增长。Prometheus 擅长观察系统总体行为;需要保存每一次业务事件身份时,应让日志、Trace 或业务数据库承担这部分职责。