
可观测性与稳定性 / 系统课时
验证抓取状态与基础健康
验证抓取状态与基础健康
监控页面能打开,只能说明 Web 服务可访问,不能证明 Prometheus 持续抓到目标,也不能证明 Grafana 真能查询到数据。本课建立一套最小健康检查:先看 Prometheus 自身,再核对 Targets、PromQL 与 Grafana 数据源,最后用少量自监控指标确认采集链路稳定。
学习目标
- 区分 Prometheus 进程健康、抓取目标健康与 Grafana 查询可用三种状态
- 能使用 Targets、
up和自监控指标判断采集是否持续有效 - 能完成 Grafana Prometheus 数据源的连接测试并定位常见断点
先确认 Prometheus 自身可用
Prometheus 提供健康与就绪端点。健康检查回答“进程是否还能正常服务”,就绪检查回答“当前是否已经准备好处理正常请求”。官方实现中,/-/healthy 与 /-/ready 在正常状态下返回 HTTP 200;就绪状态还会在启动或停止阶段反映不可服务状态。([GitHub][1])
curl -fsS http://localhost:9090/-/healthy
curl -fsS http://localhost:9090/-/ready
预期输出
Prometheus Server is Healthy.
Prometheus Server is Ready.
如果第一条失败,优先检查进程、监听端口和反向代理;如果健康成功但就绪失败,应继续查看 Prometheus 日志,确认配置与 TSDB 初始化是否完成。页面能打开之前先过这一关,可以避免把“前端可访问”误当成“服务可工作”。
检查 Targets 是否持续抓取
打开 Prometheus 的 Targets 页面,重点看每个目标的健康状态、最近一次抓取时间以及最近错误。一个关键目标偶尔出现 DOWN,即使大多数时间正常,也可能造成图表断点和告警误判。
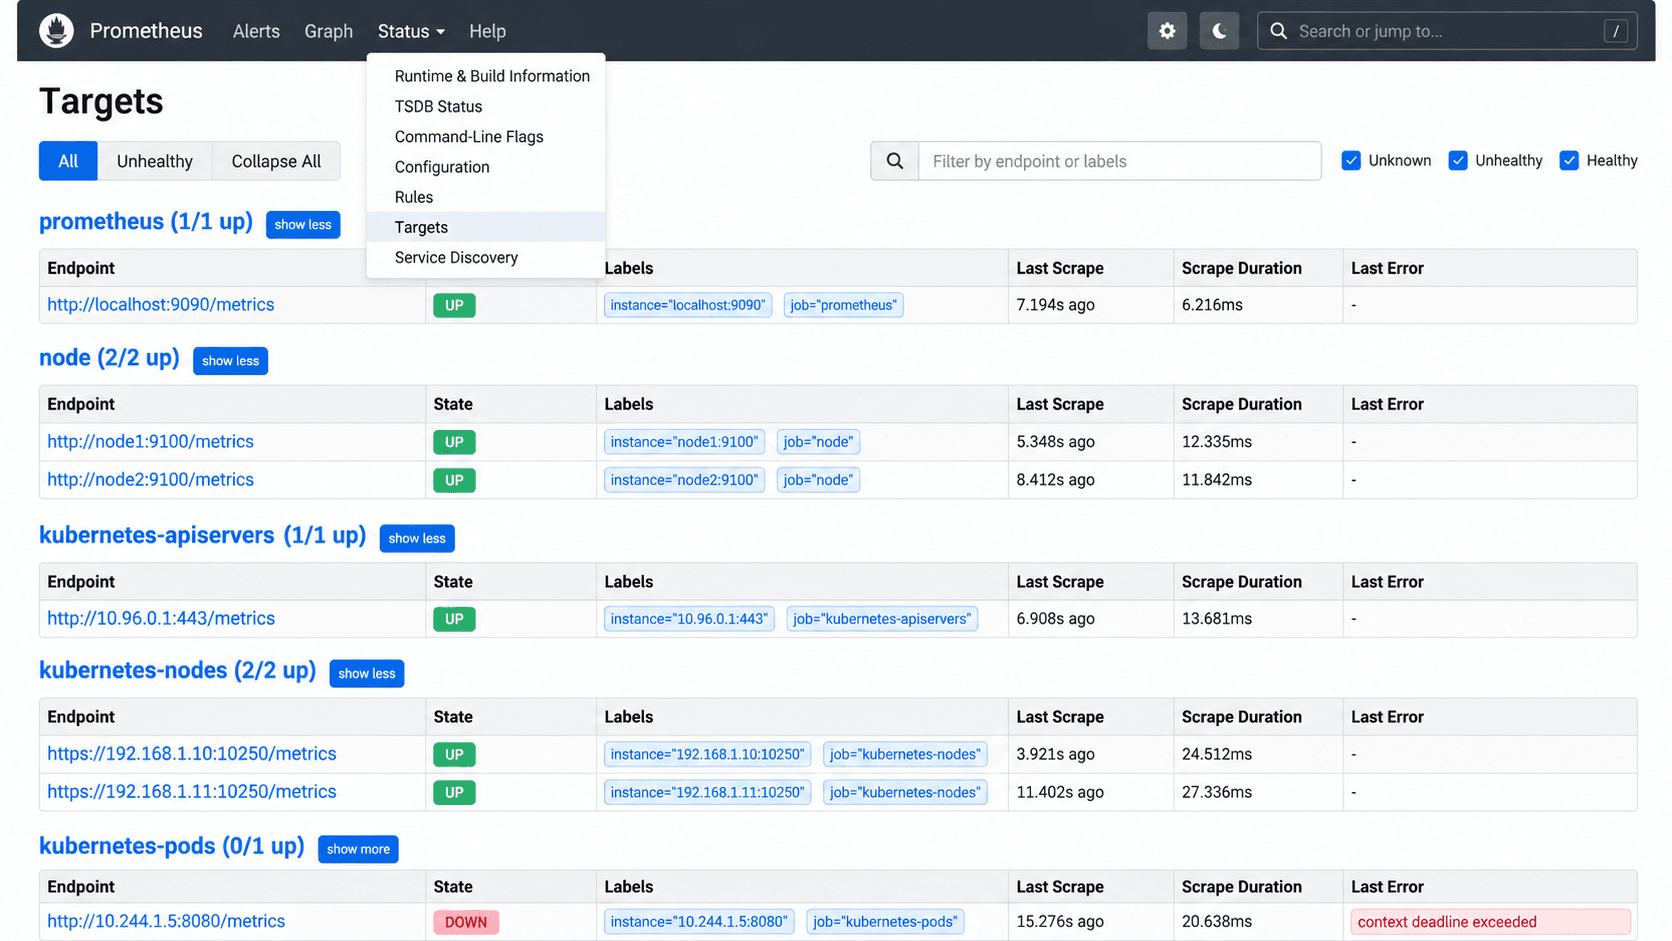
Targets 页面适合逐个看实例,PromQL 的 up 更适合快速做整体判断。Prometheus 会为每个抓取目标生成 up:本次抓取成功时值为 1,失败时值为 0。
up预期结果
正常抓取的目标返回 1;抓取失败的目标返回 0。只看 up 还不够。若目标虽然是 1,但抓取越来越慢或样本数突然下降,应继续观察 scrape_duration_seconds 和 scrape_samples_scraped,把“能抓到”与“抓得稳定”区分开。
验证 Grafana 数据源不是假通
打开 Grafana 中已经配置好的 Prometheus 数据源设置页,确认服务器 URL 指向 Grafana 实际能够访问的 Prometheus 地址,然后执行 Save & test。当前 Grafana 官方文档中,成功测试会确认已经成功查询 Prometheus API;如果 Grafana 与 Prometheus 位于不同容器中,不能想当然地把 localhost 当作另一个容器。([Grafana Labs][2])
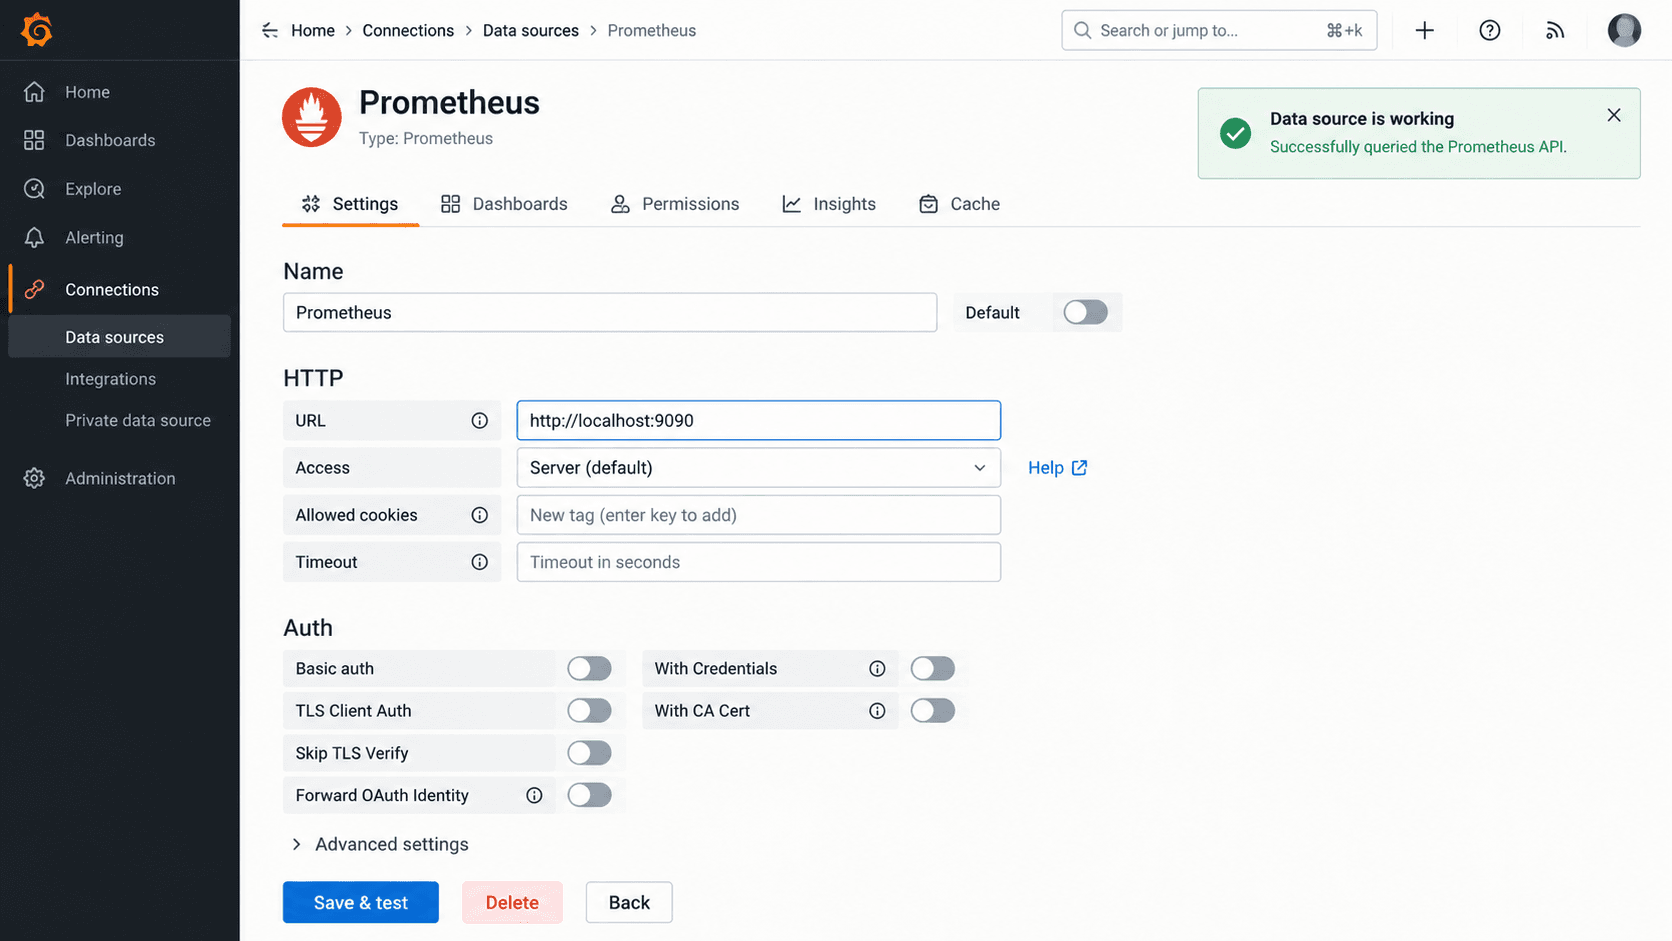
连接测试通过后,再进入 Grafana Explore,选择同一个 Prometheus 数据源并执行一个真实查询。这样验证的是“Grafana 可以查到时间序列”,而不只是“数据源设置页能连通”。
prometheus_build_info预期结果
返回至少一条时间序列,样本值为 1,并带有 Prometheus 构建信息标签。如果 Save & test 成功而查询没有数据,应回到 Prometheus 检查目标抓取和查询时间范围;如果 Prometheus 自己能查到数据而 Grafana 查询失败,则优先检查数据源选择、URL、DNS、容器网络、认证与反向代理。
观察最小自监控指标
不必一开始就监控几十个 Prometheus 内部指标。先保留能回答“采集是否成功、配置是否正常、存储规模是否异常”的几项:
| 指标 | 主要用途 | 关注方式 |
|---|---|---|
up |
判断各抓取目标最近一次抓取是否成功 | 关键实例应持续为 1 |
scrape_duration_seconds |
观察单次抓取耗时 | 突然升高时检查目标性能或网络 |
scrape_samples_scraped |
观察一次抓取获得的样本数 | 突降时检查 exporter 或过滤配置 |
prometheus_config_last_reload_successful |
判断最近一次配置加载是否成功 | 正常应为 1 |
prometheus_tsdb_head_series |
观察当前 Head 中活跃序列规模 | 关注长期趋势和突增 |
这些指标不是为了给出统一阈值,而是用来建立基线。尤其是序列数量和抓取耗时,更应该观察趋势,而不是照搬别人的固定告警值。
建立最小健康检查清单
一次完整检查可以固定为以下顺序:
/-/healthy与/-/ready都成功。- Prometheus Targets 中关键目标持续为
UP,没有反复出现的 Last Error。 - PromQL 查询
up时,关键实例返回1。 - Grafana 数据源 Save & test 成功。
- Grafana Explore 能通过同一个数据源查询到实际时间序列。
- 配置重载状态正常,抓取耗时、样本数和 TSDB 序列规模没有异常突变。
这套顺序把问题分成 Prometheus 自身、抓取链路和 Grafana 查询链路三层。只要按层验证,就能避免“页面都能打开,但数据早已停止更新”的假健康状态。