
可观测性与稳定性 / 系统课时
告警分组解决什么问题
告警分组解决什么问题
一次故障可能同时触发几十甚至几百条告警。如果每条都立即单独通知,值班人员会被消息淹没,也很难看出它们是否属于同一事件。Alertmanager 的分组会按指定标签把相关告警聚合成一个通知,并用等待与更新间隔控制通知节奏。
学习目标
- 理解
group_by如何决定哪些告警进入同一个通知组 - 区分
group_wait、group_interval与repeat_interval的作用 - 为服务级故障选择不过度拆分、也不过度合并的分组键
分组改变的是通知粒度
假设 api 服务有 20 个实例,因为同一上游故障同时触发 HighErrorRate。如果按 instance 分组,可能得到 20 组通知;如果按 service 和 alertname 分组,这 20 条告警可以进入同一组,让接收者先看到“哪个服务、哪类故障”以及组内受影响实例。
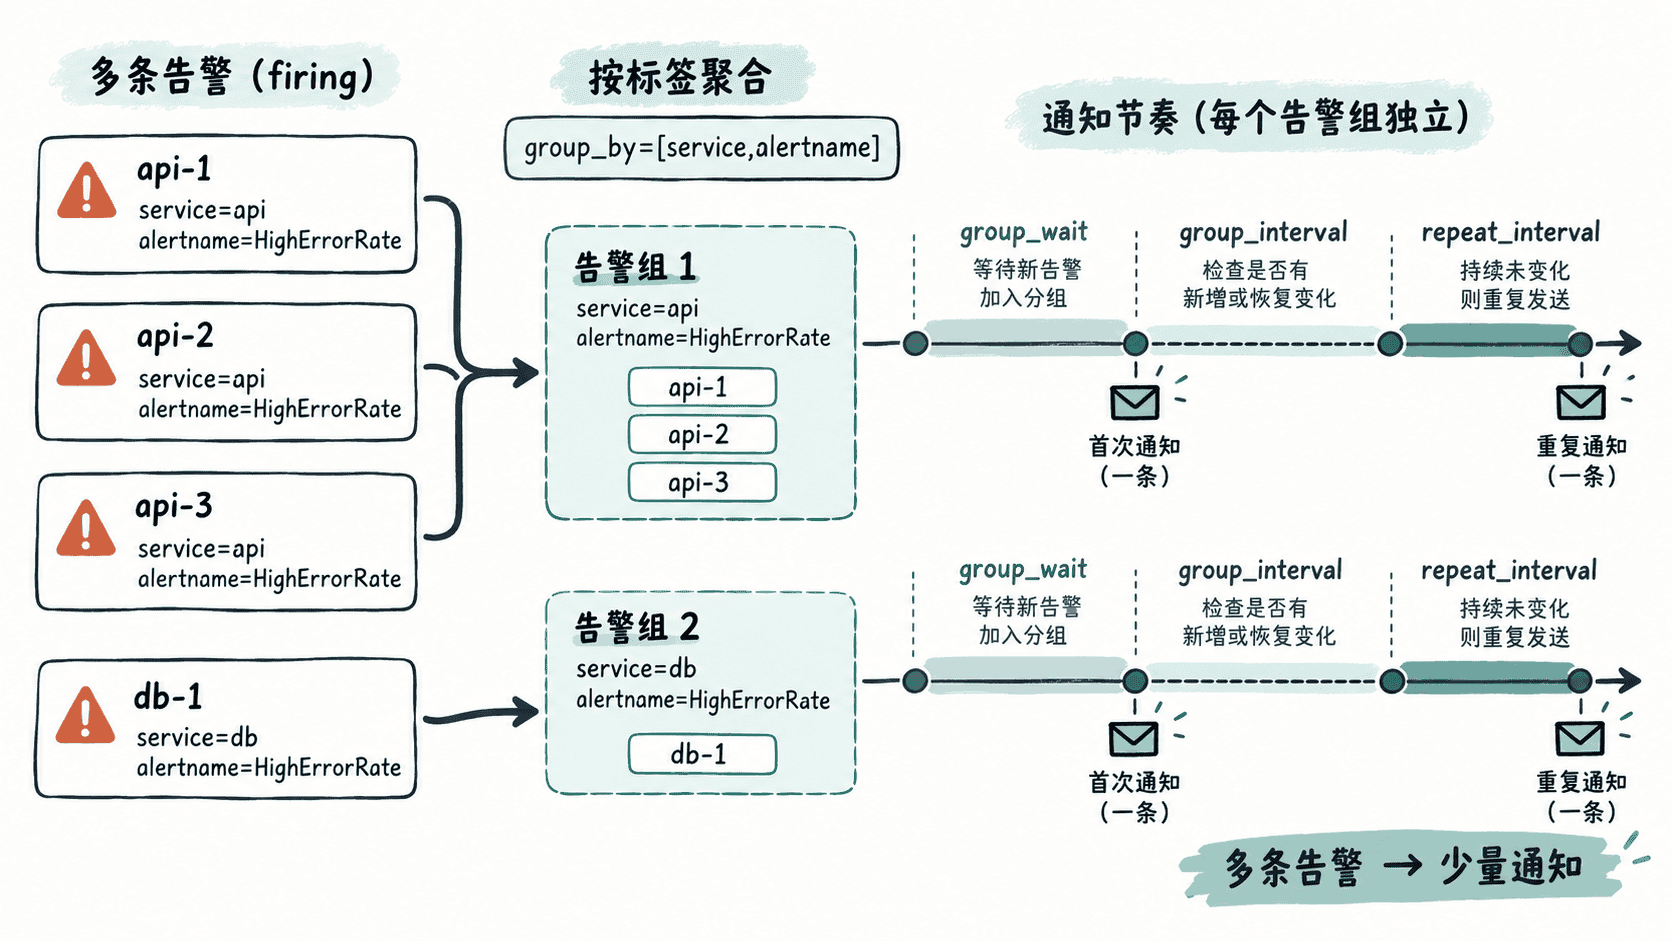
分组不会改变某条告警本身是否 firing,也不会把多条告警合成一条新告警。它改变的是 通知批次:一组里仍保留每条原始告警,只是由 Alertmanager 一起交给同一个 receiver。
用 group_by 定义同一组
下面的配置把 service 和 alertname 相同的告警放进同一组。instance 没有出现在 group_by 中,因此不同实例可以进入同一个服务级故障通知。
route:
  receiver: default-webhook
  group_by:
    - service
    - alertname
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h

receivers:
  - name: default-webhook
    webhook_configs:
      - url: http://127.0.0.1:5001/alerts
这份配置适合“同一服务的同一类告警一起通知”的场景。若把 instance 加入 group_by,通知会更细;若只按 service 分组,不同告警类型也可能被合并,通知虽然更少,但故障语义会变得模糊。
保存后,可使用 amtool 的配置检查能力确认 alertmanager.yml 语法有效,再让 Alertmanager 重载配置。生效后,具有相同 service 与 alertname 的告警应进入同一通知组;验证时应观察接收端一次通知中是否包含多条匹配告警,而不是只看 Alertmanager 进程是否启动。
三个时间参数控制通知节奏
group_wait 是新告警组第一次通知前的等待时间。它给同一故障的其他告警一个短暂汇合窗口,也让抑制规则有机会先到达;如果等待太长,首条通知就会明显变慢。
group_interval 控制已有告警组在首次通知后的检查与更新节奏。组内后来新增告警或已有告警恢复时,Alertmanager 会在后续检查点决定是否发送更新通知。
repeat_interval 面向“没有新变化但故障仍持续”的情况,控制多久再次提醒一次。通常它应明显长于 group_interval,避免持续故障产生高频重复通知。
分组键怎么选
好的分组键应代表值班人员实际处理的“一个事件”。常见做法是围绕服务、告警类型、集群或环境选择标签,而不是把所有高基数标签都塞进去。
如果把 instance、pod、container 这类实例级标签加入分组键,通知数量往往快速增加;但如果只保留 severity 这类过宽标签,又可能把完全无关的服务故障混在一起。实践中可先用 service + alertname 作为基线,再根据团队处理边界增加 cluster 或 environment。
判断分组是否合理,不看“通知越少越好”,而看一条通知里的告警是否通常由同一组人、围绕同一根因处理。这样分组才能真正减少噪声,而不是把噪声藏进一个更大的消息里。