
可观测性与稳定性 / 系统课时
什么时候需要远程长期存储
什么时候需要远程长期存储
Prometheus 自带 TSDB 已能覆盖大量单机监控场景,远程长期存储并不是“装完就要上”的组件。本篇给出一套判断方法:先看本地保留是否仍可控,再看容量、跨实例查询和故障域是否已经超出单机边界。
学习目标
- 判断本地 TSDB 继续扩容是否仍然合理。
- 识别保留周期、数据规模和高可用需求触发远程存储的信号。
- 理解接入远程存储后写入、查询与故障域发生了什么变化。
先分清本地存储能解决什么
Prometheus 会把抓取到的样本写入本地 TSDB,本地盘容量足够、时间序列规模可控时,即使保留周期较长,也不代表必须立刻引入远程存储。真正需要关注的是:单机磁盘是否还能承受数据增长,查询是否仍能在可接受时间内完成,以及节点故障时能否接受这部分历史数据暂时不可用或永久丢失。
因此,“默认保留时间不够长”本身不是充分理由。你可以先调整本地保留策略并为磁盘留出压缩和 WAL 的空间,再观察实际增长速度。容量评估可以用近似关系理解:
这个公式适合做量级估算,不应替代真实环境的磁盘增长监控,因为标签基数、WAL、压缩过程和删除策略都会影响峰值占用。
出现这些信号时再考虑远程存储
最常见的触发点可以归为三类。
| 信号 | 本地 TSDB 面临的问题 | 远程长期存储能提供的方向 |
|---|---|---|
| 保留周期不断拉长 | 单机磁盘持续扩容,备份和恢复越来越重 | 将长期历史从采集节点解耦 |
| 多个 Prometheus 都要统一查询 | 数据分散在多个实例,本地查询视角有限 | 建立集中存储或统一查询层 |
| 不能接受单机磁盘或节点故障带来的历史数据风险 | 本地存储本质上仍属于单节点故障域 | 由外部系统承担复制、持久化和扩展 |
还有一个很实用的判断:如果你已经开始为了“保留历史数据”而频繁给 Prometheus 扩盘、迁盘或做复杂备份,而采集节点本身只需要保留较短的热数据,那么远程存储通常已经值得评估。
接入后数据链路怎么变化
典型做法是让 Prometheus 继续负责抓取和短期本地存储,同时通过 Remote Write 把样本发送到外部系统。查询长期数据时,则由远程系统或其查询层提供更大的时间范围。这样采集、短期查询和长期保存不再全部压在同一块本地磁盘上。
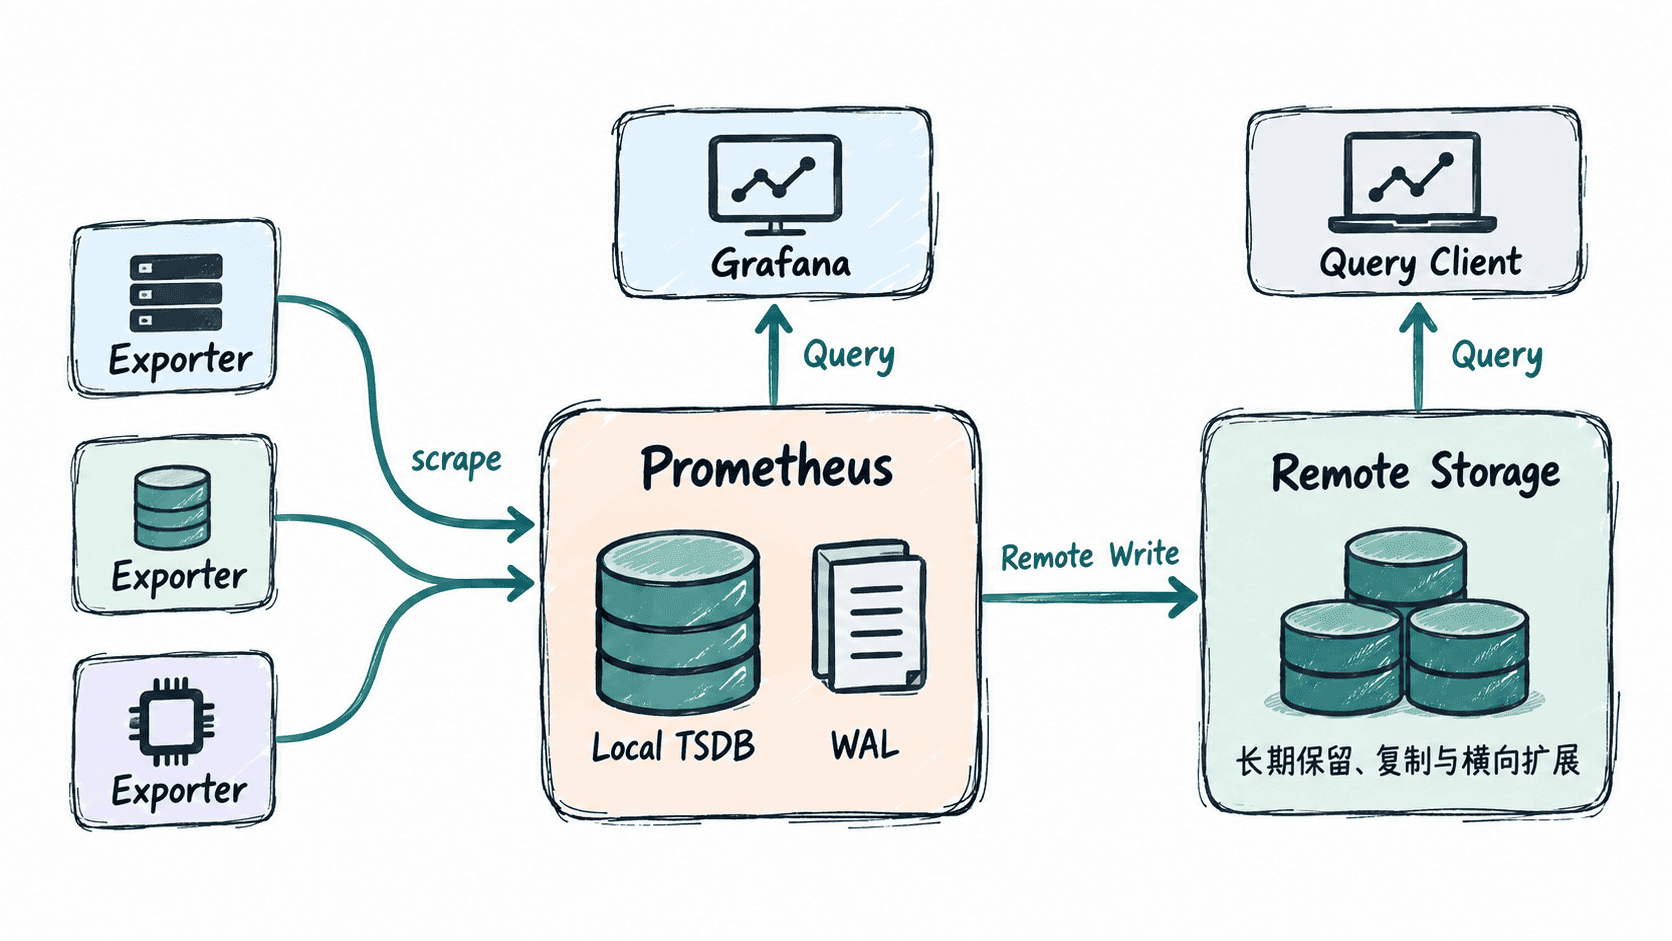
要注意,Remote Write 不是“把本地磁盘换成网络盘”。Prometheus 仍然会维护本地 WAL 和 TSDB,远程写入还会增加网络、CPU 和内存压力;远端不可用时也需要关注积压和重试。因此,接入远程存储后仍应监控发送队列、失败率和端到端延迟。
用需求而不是规模口号做决定
如果当前只有一个 Prometheus、磁盘增长稳定、历史查询主要集中在最近几周,并且节点故障后的恢复策略可以接受,那么保持本地存储通常更简单。不要仅因为“以后可能会大”就提前引入额外系统。
当你需要跨多个 Prometheus 统一查看数据、保留数月到数年的历史、把长期数据可靠性从采集节点中解耦,或单机容量与恢复时间已经成为运维负担时,再进入远程方案选型。选型时重点验证写入吞吐、数据复制、查询延迟、对象存储或磁盘成本、故障恢复方式,以及与现有 PromQL 和 Grafana 查询路径的兼容性。