
可观测性与稳定性 / 系统课时
PromQL 查询很慢怎么分析
PromQL 查询很慢怎么分析
PromQL 变慢时,先不要只盯着表达式长度。真正决定压力的是查询跨度、每个时间点的计算次数、匹配到的序列和样本数量,以及聚合后保留的分组规模。本篇给出一套可重复的定位顺序,帮助判断慢在“扫得太久、匹配太宽,还是聚合太大”。
学习目标
- 从时间范围、step、匹配序列数和聚合规模拆解 PromQL 查询成本
- 识别宽泛正则、高基数 Label 和过细分组带来的放大效应
- 用缩小范围和逐层收紧表达式的方法验证优化是否有效
先把慢查询变成可测量的问题
范围查询会在 start 到 end 之间按 step 多次计算表达式。相同 PromQL,查 6 小时与查 30 天、step=5m 与 step=15s,工作量可能完全不同。因此先固定查询文本、时间范围和 step,再比较执行时间,避免“凭 Grafana 页面体感”判断。
下面的脚本把查询条件显式化,并记录一次范围查询的 HTTP 总耗时。它适用于 GNU/Linux,要求已有 curl 和 Python 3。默认查询 up,实际排障时通过环境变量 QUERY 替换为慢查询。
PROM_URL="${PROM_URL:-http://localhost:9090}"
QUERY="${QUERY:-up}"
START="$(date -u -d '1 hour ago' +%Y-%m-%dT%H:%M:%SZ)"
END="$(date -u +%Y-%m-%dT%H:%M:%SZ)"

curl -fsS -G "$PROM_URL/api/v1/query_range" --data-urlencode "query=$QUERY" --data-urlencode "start=$START" --data-urlencode "end=$END" --data-urlencode "step=60s" -o /tmp/prom-query.json -w 'http_code=%{http_code} total_time=%{time_total}s\n'
python3 -c 'import json; d=json.load(open("/tmp/prom-query.json")); print("status="+d["status"]); print("series="+str(len(d.get("data",{}).get("result",[]))))'
预期输出
http_code=200 total_time=<TIME>s
status=success
series=<COUNT>
<COUNT> 和 <TIME> 会随数据规模、缓存和机器负载变化。若同一表达式在缩短时间范围或增大 step 后明显变快,首先应处理查询跨度与分辨率,而不是急着改 Prometheus 的并发或样本上限。
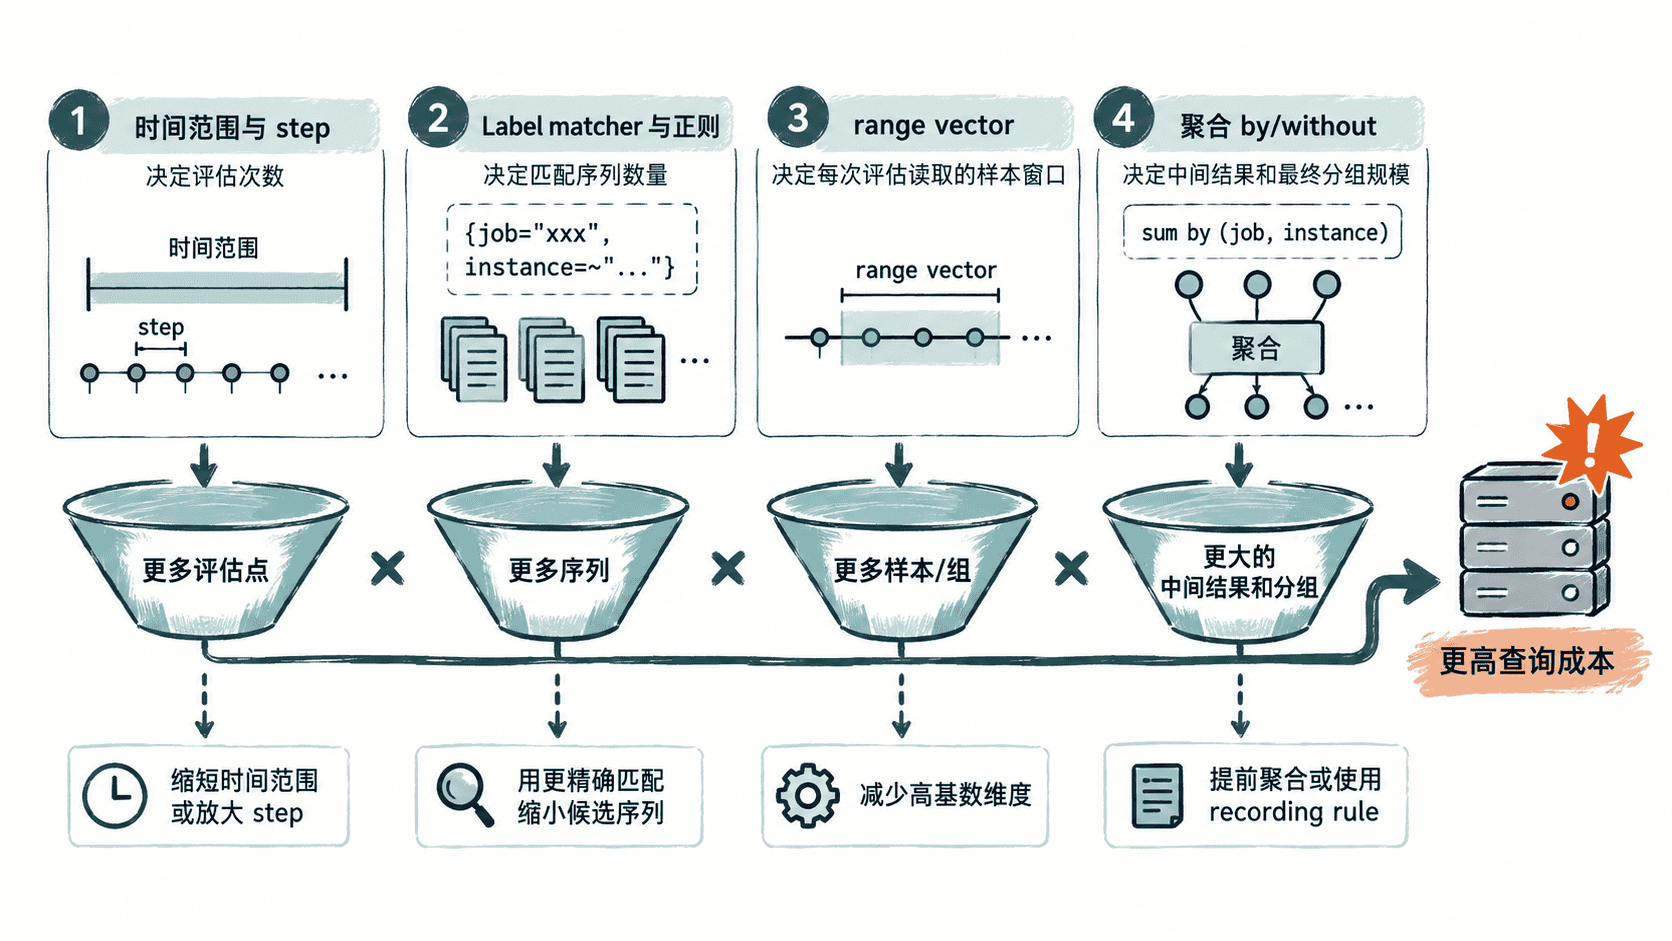
按固定顺序缩小查询压力
排查时一次只改一个因素,这样才能知道真正的瓶颈在哪里。
首先缩短时间范围。例如把 24 小时缩到 1 小时;如果速度改善明显,说明总评估次数或区间向量读取量是主要因素。随后保持时间范围不变,适当增大 step。Dashboard 只需要展示趋势时,没有必要用远小于图表像素分辨率的 step 重复计算。
其次检查选择器。job="api" 这类等值匹配通常能快速缩小候选集合;path=~".*"、instance=~".+" 这类宽泛正则会覆盖大量标签值。问题不在于“正则一定慢”,而在于它是否导致更多序列进入后续计算。能用明确值或更窄条件表达时,就不要用覆盖整个标签空间的正则。
然后检查输入序列基数。即使表达式很短,如果某个指标因为 user_id、原始 URL、Pod 临时 ID 等 Label 拥有几十万条序列,rate()、increase() 等函数仍要处理大量样本。此时单纯改 PromQL 只能缓解,根治仍然是控制指标标签基数。
最后看聚合维度。sum by (job) 会把大量输入压成少数组;sum by (job, pod, path, user_id) 则可能保留几乎所有高基数组合,聚合并没有真正降低结果规模。用于总览的 Dashboard 应只保留确实需要展示的维度,明细查询放到按需下钻中。
用逐层替换确认是哪一段慢
对于复杂表达式,可以从最内层选择器开始运行,逐层加回函数和聚合。每增加一层,就观察返回序列数量和耗时变化。若仅选择器就返回海量序列,优先收紧 matcher;若选择器可控,但加入长窗口函数后变慢,就检查时间跨度和窗口;若聚合后才明显变慢,则检查 by 或 without 是否保留了高基数维度。
对于被多个 Dashboard 或规则频繁重复计算的昂贵表达式,可以考虑 recording rule,把常用的中间聚合结果预计算为新的时间序列,再让展示查询读取预聚合结果。它适合稳定、重复、计算代价高的查询,不应被用来掩盖失控的原始指标基数。
当查询已经慢到影响 Prometheus 整体负载时,还可以临时启用 query log 记录真实查询的时间范围、step 和引擎耗时,再据此找出高频慢查询。优化完成后,应使用相同的查询文本、相同范围和相同 step 重新测量;只有输入条件一致,优化前后的耗时才有可比性。