
可观测性与稳定性 / 系统课时
CPU 指标应该怎么看
CPU 指标应该怎么看
Node Exporter 给出的 CPU 指标不是“当前使用率”,而是各 CPU 核心在不同状态上累计消耗的秒数。本节把这些累计值转换成速率,再得到可解释的 CPU 使用率。
学习目标
- 理解
node_cpu_seconds_total为什么必须先计算速率 - 用 PromQL 计算整机 CPU 使用率
- 区分
user、system、idle、iowait、steal等状态的含义
先读懂累计 CPU 时间
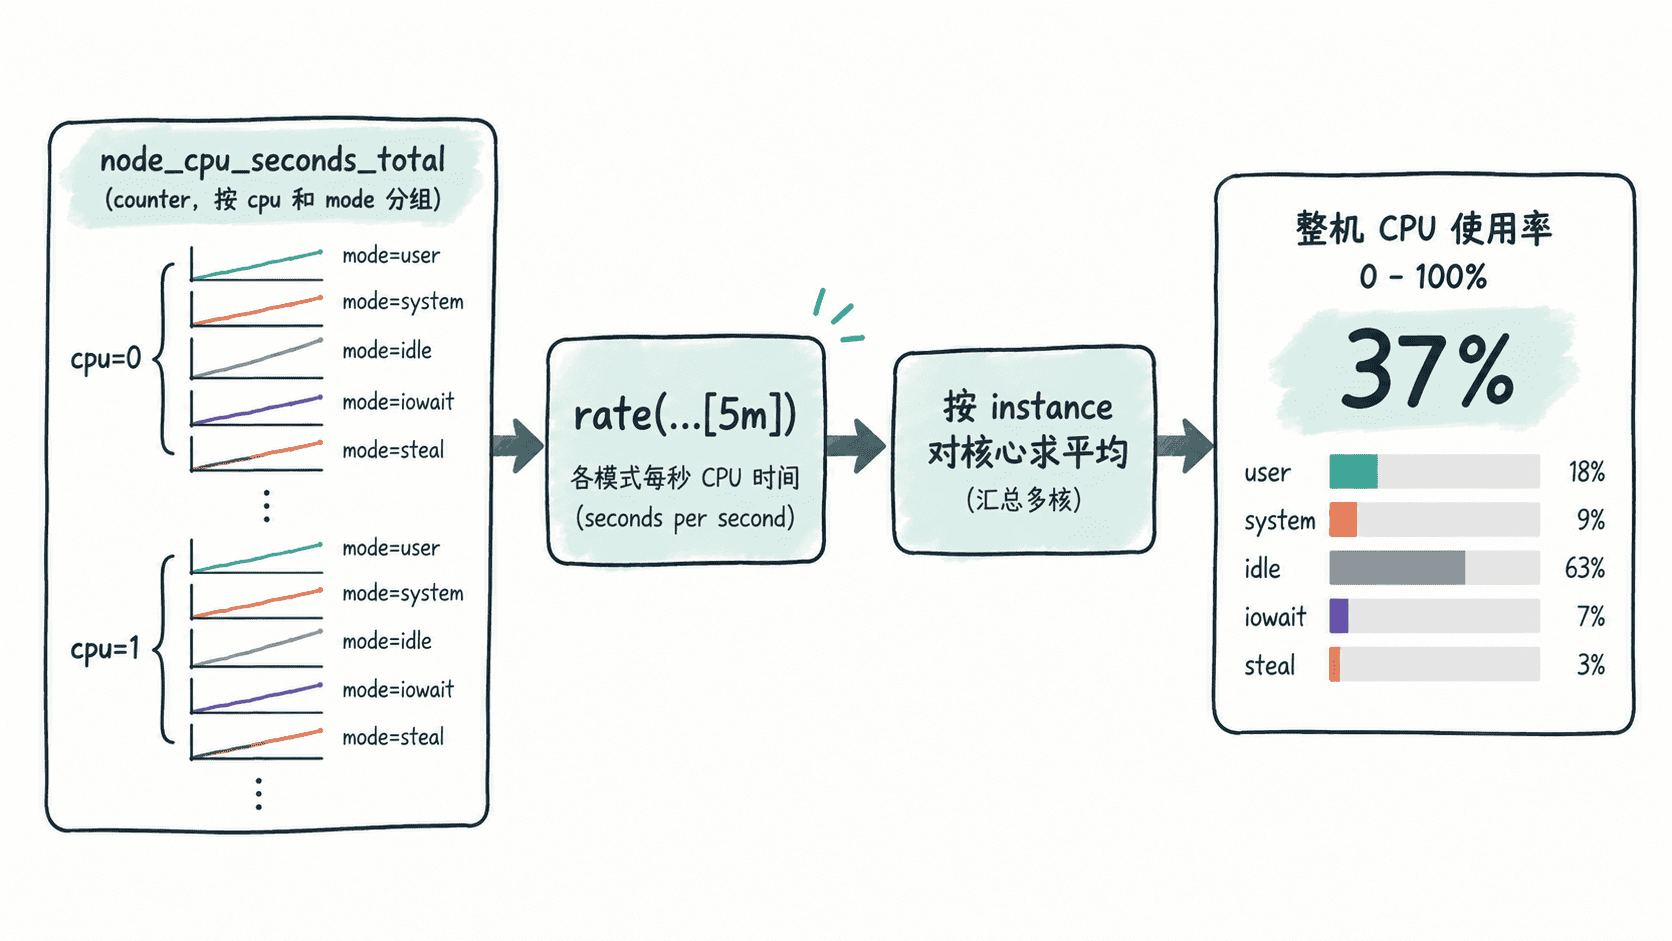
node_cpu_seconds_total 是按 cpu 和 mode 拆分的累计秒数指标,例如同一台主机会有 cpu="0", mode="user"、cpu="0", mode="idle" 等多条时间序列。Node Exporter 的指标说明将它定义为 CPU 在各模式上累计花费的秒数。([GitHub][3])
累计值本身会随着运行时间不断增大,因此不能把某一时刻的数值直接当成百分比。Prometheus 通常使用 rate() 计算一个时间窗口内“每秒增加多少秒 CPU 时间”,官方示例也用 rate(node_cpu_seconds_total{mode="system"}[1m]) 来表示 system 模式的平均 CPU 时间速率。([普罗米修斯][4])
用 idle 反推整机使用率
最常见的口径是把“非 idle 时间”视为 CPU 已使用时间。对每个核心先算 idle 的速率,再对所有核心取平均,最后用 1 - idle 得到整机使用率。
100 * (1 - avg by (instance) (
  rate(node_cpu_seconds_total{mode="idle"}[5m])
))
预期结果
{instance="<HOST>:9100"} <PERCENT><PERCENT> 是 0 到 100 附近的百分比数值,例如结果为 37.5 表示最近 5 分钟窗口内平均约 37.5% 的 CPU 时间不是 idle。这里用 5 分钟窗口是为了减少瞬时抖动;若观察短时尖峰可以缩短窗口,但结果会更敏感。
不要把所有非 idle 都理解成业务计算
Linux 会把 CPU 时间拆成多个 mode。user 是用户态执行时间,system 是内核态执行时间,irq 与 softirq 反映中断处理,nice 是调整过优先级的用户进程时间。iowait 表示 CPU 在等待 I/O 完成期间处于空闲状态,而 steal 常见于虚拟化环境,表示虚拟 CPU 等待宿主机调度的时间。
因此,“CPU 使用率”没有唯一口径。只排除 idle 时,iowait 和 steal 会被算进非 idle;Prometheus Node Exporter 的官方 mixin 也提供了另一种口径,把 idle|iowait|steal 一起排除后再计算利用率。([GitHub][5])
当告警目标是“应用是否在真正消耗计算资源”时,排除 iowait 和 steal 往往更便于定位;当目标是“CPU 是否还有可调度余量”时,只看 idle 又更直观。关键不是选一个永远正确的公式,而是让仪表盘和告警始终使用同一口径。
结合 mode 找根因
看到总使用率升高后,不要停在一个百分比上。可以继续观察 user、system、iowait 和 steal 的占比:user 高通常说明应用计算繁忙,system 高需要关注系统调用、中断或内核开销,iowait 高更应联动磁盘延迟与 I/O 指标,steal 高则要检查虚拟化宿主机资源争用。
CPU 指标的正确阅读顺序是:先确认累计 counter 正常增长,再用 rate() 转成窗口速率,最后按核心和模式聚合。这样得到的百分比才具有时间意义,也能继续沿 mode 维度解释“CPU 为什么高”。