
可观测性与稳定性 / 系统课时
规划监控平台组件和主机
规划监控平台组件和主机
搭建监控平台前,先把组件放在哪里、谁主动连接谁、哪些端口必须互通确定下来。完成这一步后,你应该能画出 Prometheus、Grafana、Alertmanager 与被监控服务器之间的关系,并据此检查 DNS、防火墙和主机资源是否满足部署要求。
学习目标
- 规划 Prometheus、Grafana、Alertmanager 与被监控主机的部署位置
- 判断指标采集、查询和告警链路中的连接方向
- 在部署前验证主机名解析与关键网络路径
先确定每个组件的职责
服务器监控最小闭环通常由 Prometheus、Grafana、Alertmanager 和被监控主机上的 Node Exporter 组成。不要把它们理解成一条所有组件依次转发数据的流水线,它们之间实际上存在三条不同链路。
Prometheus 主动访问各服务器的 Node Exporter HTTP 接口并抓取指标;Grafana 主动查询 Prometheus;Prometheus 在告警规则触发后把告警事件发送给 Alertmanager。Alertmanager 负责分组、抑制、静默和通知路由,而不是保存服务器指标。
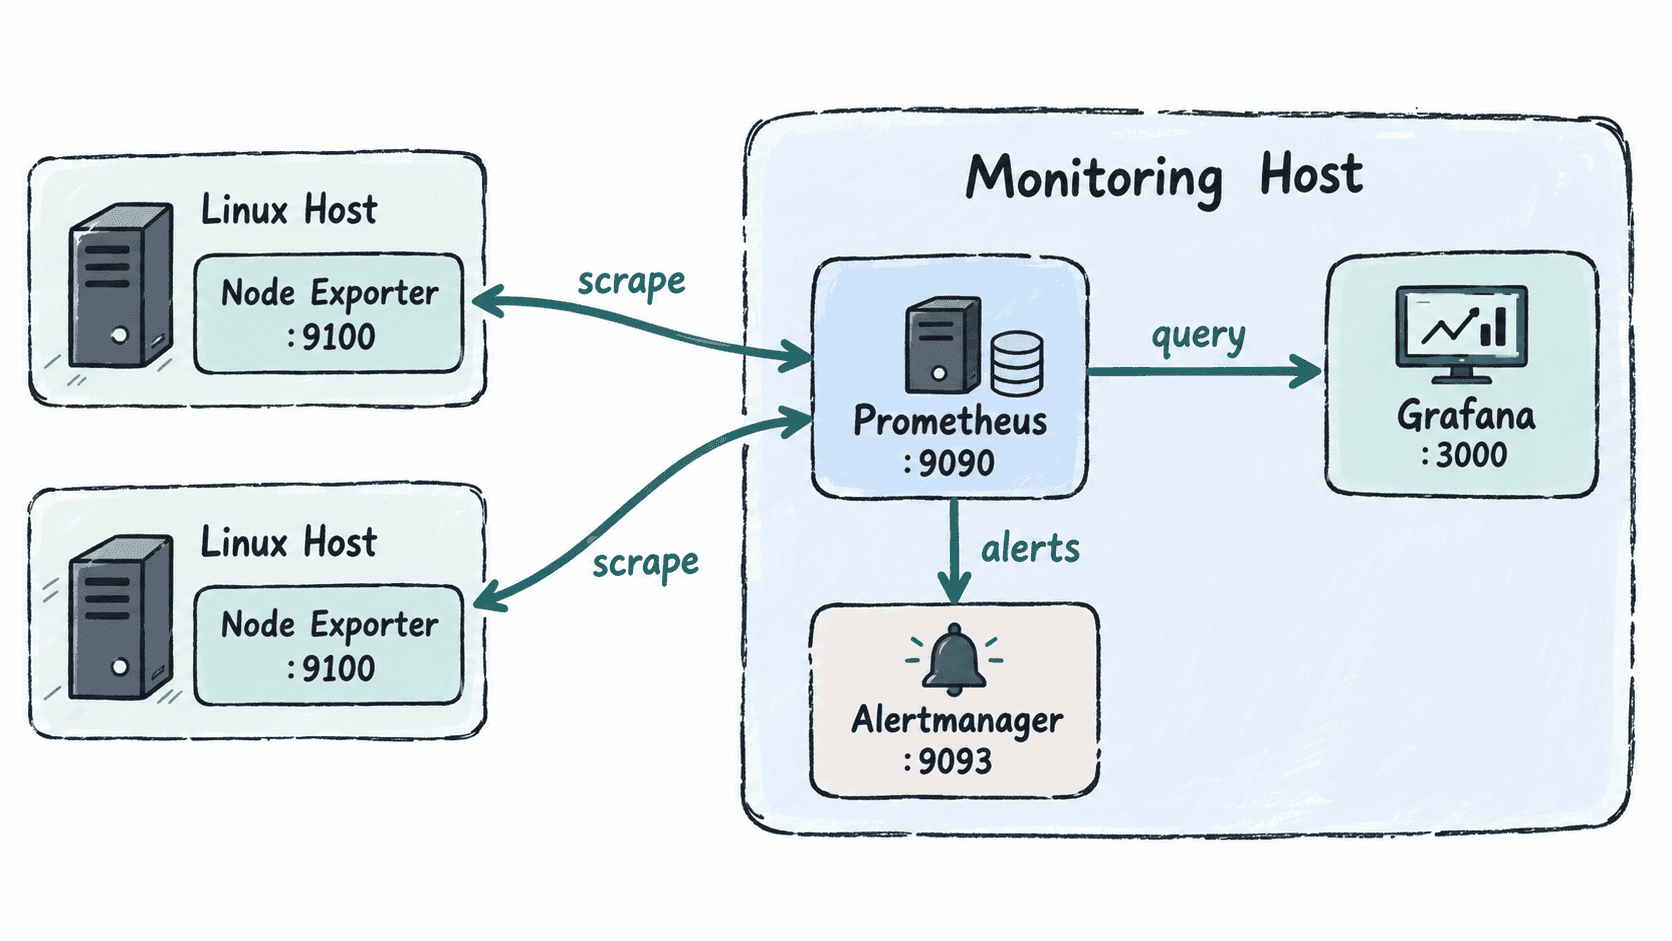
一个适合练习环境的规划如下:
| 主机 | 部署内容 | 默认端口 | 主要访问关系 |
|---|---|---|---|
monitoring.internal |
Prometheus | 9090 |
访问各 Node Exporter |
monitoring.internal |
Grafana | 3000 |
查询 Prometheus |
monitoring.internal |
Alertmanager | 9093 |
接收 Prometheus 告警 |
app-01.internal |
Node Exporter | 9100 |
接受 Prometheus 抓取 |
app-02.internal |
Node Exporter | 9100 |
接受 Prometheus 抓取 |
练习环境可以让三个中心组件共用一台监控主机。生产环境是否拆分,应根据可用性、数据规模和维护边界决定,而不是为了形式上做到“一组件一主机”。
按通信方向规划网络
监控网络最常见的错误,是只确认端口已经监听,却没有确认真正发起连接的一端能够访问目标地址。例如 Node Exporter 即使正常监听 9100,Prometheus 所在主机无法路由到该端口,目标依然会显示为不可用。
需要重点保证以下路径:
- Prometheus 主机能够访问每台被监控服务器的
9100/tcp。 - Grafana 能够访问 Prometheus 的
9090/tcp。 - Prometheus 能够访问 Alertmanager 的
9093/tcp。 - 运维人员需要访问 Grafana 时,再根据实际入口开放
3000/tcp或通过反向代理统一暴露。
在部署前验证名称解析
如果后续 Prometheus 配置准备使用主机名作为抓取目标,应先从监控主机检查这些名称能否解析。下面的命令可以一次验证规划中的几个节点:
getent hosts monitoring.internal app-01.internal app-02.internal预期输出
<IP> monitoring.internal
<IP> app-01.internal
<IP> app-02.internal
<IP> 会因实验环境而不同。如果某个名称没有输出,应先修复 DNS 或 /etc/hosts,不要急着写 Prometheus 配置。使用 IP 地址也可以完成实验,但稳定的主机名通常更便于后续迁移和维护。
给平台留出故障边界
规划时还要避免让监控系统与被监控业务形成不必要的共同故障点。例如只监控一台应用服务器时,把 Prometheus 也运行在这台服务器上,一旦服务器宕机,业务和监控会同时消失,你只能知道“什么都访问不了”,却失去了独立观察者。
因此,即使是小型平台,也建议让 Prometheus 至少运行在独立于主要业务节点的主机上。Grafana 和 Alertmanager可以与 Prometheus 共机起步,等指标规模、用户数量或可用性要求提高后再拆分。规划的目标不是追求复杂拓扑,而是保证采集、查询和告警三条链路都清楚、可访问,并且发生业务故障时仍有地方观察故障。