
可观测性与稳定性 / 系统课时
监控数据为什么会越来越大
监控数据为什么会越来越大
Prometheus 磁盘持续增长通常不是日志没清理,而是持续有新样本写入 TSDB。要判断增长是否合理,需要把活跃时间序列数量、Target 规模、每个 Target 暴露的指标、Label 基数和抓取间隔放到同一条容量链路里分析。
学习目标
- 用时间序列数量、采集频率和保留时间解释存储增长
- 识别高基数 Label 为什么会迅速放大时间序列数量
- 使用 Prometheus 自身指标观察当前序列规模和样本写入速率
磁盘增长的本质是持续写入样本
对一个稳定存在的时间序列,Prometheus 每次抓取通常会追加一个新样本。因此,在其他条件不变时,抓取越频繁、活跃时间序列越多、保留时间越长,需要保存的样本就越多。
可以用下面的近似关系做容量判断:
Prometheus 官方存储文档给出的经验值是,持久化后平均每个样本大约占 1~2 字节,并建议用“保留秒数 × 每秒写入样本数 × 每样本字节数”估算基础磁盘需求;实际部署还要给 WAL、Head、索引和 Compaction 留空间。([普罗米修斯][1])
Target 和指标数量决定基础规模
假设有 100 个 Target,每个 Target 暴露约 1000 条可抓取时间序列,那么仅这一组任务就可能形成约 10 万条活跃序列。若 scrape_interval 为 15 秒,每秒大约写入 6667 个样本;改成 60 秒后,同一批序列的样本写入速率约降为四分之一。
这也是为什么增加一批机器与让每台机器多暴露一批指标都会直接推高磁盘消耗。前者增加 Target,后者增加单个 Target 每轮抓取的样本数,两者最终都落到更高的样本写入速率。
Label 基数会把一个指标拆成大量序列
Prometheus 里的时间序列由指标名和完整 Label 集合共同标识。增加一个只有少量固定值的 Label 往往可控;但把 user_id、request_id、session_id、完整 URL 这类近乎无限变化的值放进 Label,会不断产生新序列。
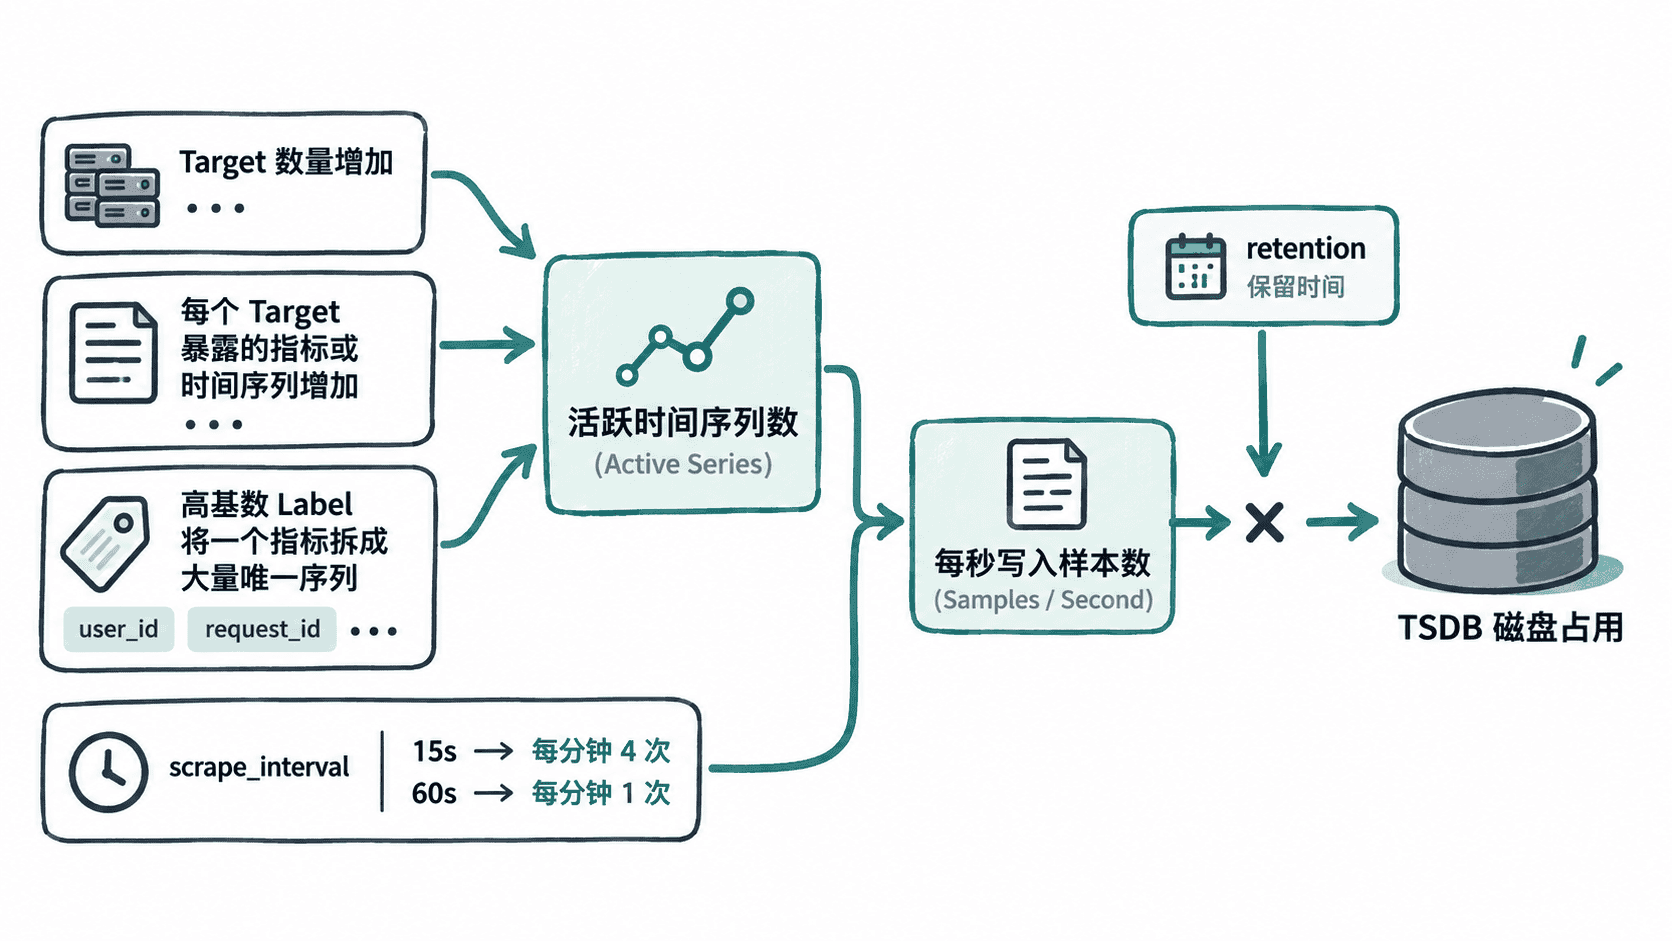
高基数的危险不只是每个样本多几个字符串。真正的放大器是唯一 Label 组合变多,导致时间序列数量变多。如果某个 Label 的取值持续增长,旧序列尚在保留期内,新序列又不断出现,磁盘和内存压力会一起上升。
采集周期决定同一批序列写得多快
把 scrape_interval 从 60 秒改成 15 秒,在序列数量不变时,大致意味着单位时间写入四倍样本。高频采集适合确实需要更细时间分辨率的指标,但不应该对所有 Job 无差别缩短周期。
优化时通常先处理无价值指标和高基数 Label,再考虑适度放宽采集周期。官方文档也指出,减少抓取的时间序列数量或增大抓取间隔都能降低样本写入速率,而减少序列通常更有效。([普罗米修斯][1])
用 Prometheus 自身指标确认增长来源
可以直接查询当前 Head 中的时间序列数量,以及最近一段时间的样本追加速率。下面假设本机 Prometheus 监听 9090。
curl -sG 'http://localhost:9090/api/v1/query' --data-urlencode 'query=scalar(sum(prometheus_tsdb_head_series))'
curl -sG 'http://localhost:9090/api/v1/query' --data-urlencode 'query=scalar(sum(rate(prometheus_tsdb_head_samples_appended_total[5m])))'
预期结果
{"status":"success","data":{"resultType":"scalar","result":[<TIME>,"<VALUE>"]}}
{"status":"success","data":{"resultType":"scalar","result":[<TIME>,"<VALUE>"]}}
<TIME> 和 <VALUE> 是动态值。第一条反映当前 Head 中的序列规模,第二条反映近 5 分钟平均每秒追加样本的速率;如果磁盘突然加速增长,先看这两个值是否同步上升,再继续按 Job、Target 和 Label 维度定位。
存储持续变大并不一定是故障,因为 Prometheus 本来就在积累历史数据。真正需要处理的是增长速度超过容量规划:优先检查 Target 是否暴增、单 Target 样本数是否异常、高基数 Label 是否失控、采集周期是否过密,再决定精简指标、调整标签设计、降低采集频率或修改保留策略。