
可观测性与稳定性 / 系统课时
模拟 CPU 异常观察告警流程
模拟 CPU 异常观察告警流程
告警规则写对并不等于告警链路真的可用。本课在一台非生产监控节点上主动制造持续 CPU 压力,从指标升高开始,依次观察 Prometheus 的 Pending 与 Firing、Alertmanager 的活动告警,以及 Grafana 中的 CPU 曲线,最后停止压力确认恢复过程。
学习目标
- 安全制造和停止一段可控的 CPU 高负载
- 观察 Prometheus 告警从 Inactive 到 Pending、Firing 再恢复的状态变化
- 区分 Prometheus、Alertmanager 与 Grafana 在告警链路中的职责
先确认 CPU 告警规则
为了让实验不用等待太久,可以使用较短的计算窗口和持续时间。下面的规则先计算每台实例所有 CPU 核心的平均 idle 比例,再转换为 CPU 使用率;使用率连续两分钟超过 80% 时触发告警。
groups:
  - name: cpu-lab
    rules:
      - alert: HostHighCPU
        expr: (1 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[1m]))) * 100 > 80
        for: 2m
        labels:
          severity: warning
        annotations:
          summary: "High CPU usage on {{ $labels.instance }}"
          description: "Average CPU usage has stayed above 80% for more than 2 minutes."
实验规则可以保存为 /etc/prometheus/rules/cpu-lab.yml,并确保 Prometheus 的 rule_files 能匹配该文件。修改后先检查规则,而不是直接依赖运行时日志发现错误。
promtool check rules /etc/prometheus/rules/cpu-lab.yml预期输出:
Checking /etc/prometheus/rules/cpu-lab.yml
  SUCCESS: 1 rules found
确认规则已经加载后,在 Prometheus 的 Rules 页面应能看到 HostHighCPU。正式环境通常会采用更长的 rate 窗口、for 时间以及更符合业务基线的阈值,本课的参数主要用于缩短实验周期。
制造可控的 CPU 压力
在被 Node Exporter 监控的非生产 Linux 主机上执行下面的命令。它会为每个逻辑 CPU 启动一个持续计算的 yes 进程,并把 PID 保存到临时文件,方便之后精确停止本次实验产生的进程。
pids=""
for _ in $(seq 1 "$(nproc)"); do
  yes > /dev/null &
  pids="$pids $!"
done
printf '%s\n' "$pids" > /tmp/cpu-load.pids
echo "CPU load started; PIDs saved in /tmp/cpu-load.pids"
预期输出:
CPU load started; PIDs saved in /tmp/cpu-load.pids观察告警从指标到通知的变化
压力产生后,不会立即看到完整告警。Node Exporter 要先暴露新的 CPU 累计时间,Prometheus 下一次抓取后才能计算 rate,随后规则还必须持续满足 for: 2m 才会从 Pending 进入 Firing。
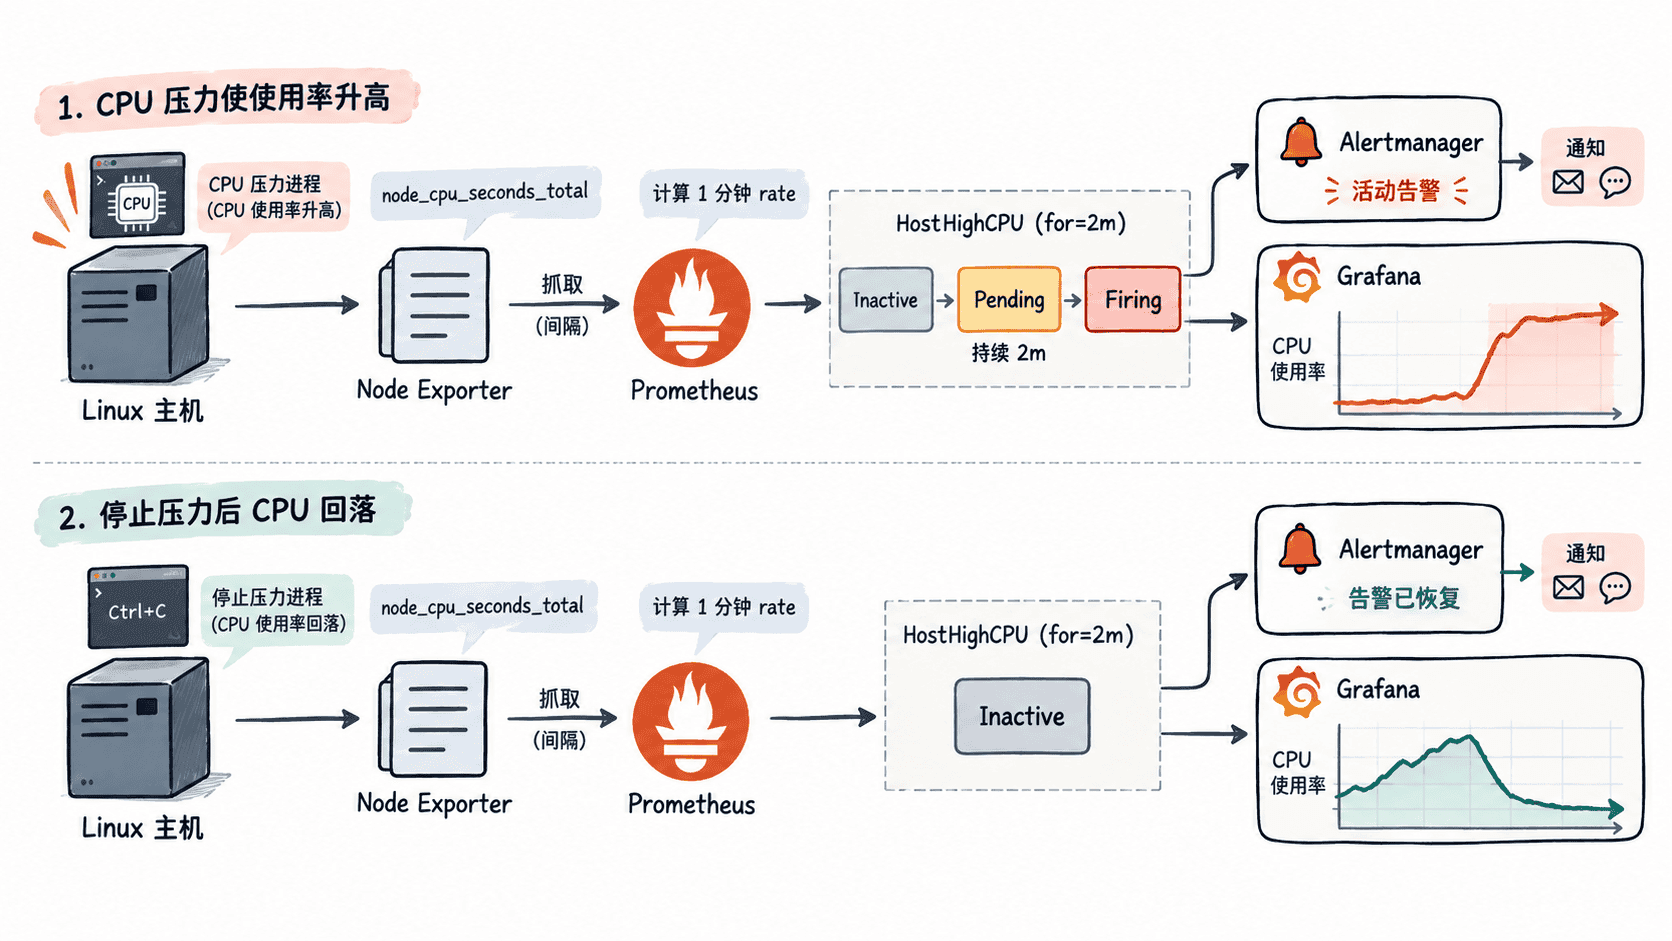
观察时可以按下面的顺序判断链路是否正常:
| 阶段 | Prometheus | Alertmanager | Grafana |
|---|---|---|---|
| 压力刚开始 | CPU 指标开始上升 | 无活动告警 | CPU 曲线上升 |
| 条件达到阈值 | HostHighCPU 为 Pending |
通常仍无活动告警 | 高负载持续可见 |
| 持续超过 2 分钟 | HostHighCPU 为 Firing |
出现活动告警并按路由通知 | CPU 曲线维持高位 |
| 压力停止后 | 条件消失并恢复 Inactive | Firing 告警被解析 | CPU 曲线逐渐回落 |
Grafana 的监控面板可以直接展示 Prometheus 中的 CPU 指标,但 Grafana Alerting 页面不会因为存在 Prometheus 原生规则就自动复制同一条规则。只有在 Grafana 已配置相应 Alertmanager 数据源或使用了对应告警集成时,才应期待在 Grafana 的告警界面看到相同的活动告警。
停止压力并确认恢复
观察到 Firing 后,应停止刚才记录的全部压力进程。下面的命令只读取实验自己的 PID 文件,不需要用模糊的进程名批量杀进程。
xargs -r kill < /tmp/cpu-load.pids
rm -f /tmp/cpu-load.pids
echo "CPU load stopped"
预期输出:
CPU load stopped随后继续观察至少几个抓取周期。CPU 指标不会在停止命令执行的瞬间归零,因为 rate(...[1m]) 仍包含前一分钟的样本;随着时间窗口向前移动,计算出的使用率会逐渐下降到阈值以下,Prometheus 告警条件随即恢复为 Inactive。
Alertmanager 收到恢复状态后不再把该告警作为活动告警处理。外部通知渠道是否额外发送一条“已恢复”消息,则取决于所使用接收器及其恢复通知配置,不能仅凭 Prometheus 状态恢复就假定一定会收到恢复消息。
读懂告警为什么会有延迟
从 CPU 压力开始到真正收到通知,中间至少会经过采集间隔、PromQL 时间窗口、规则评估、for 持续时间和 Alertmanager 通知分组等环节。因此“CPU 已经很高,但通知为什么晚了一会儿”通常不是故障,而是告警抗抖动设计的结果。
反过来,如果 CPU 已连续高负载数分钟,Prometheus 仍没有进入 Pending,应先检查表达式当前值和规则是否加载;已经 Firing 但 Alertmanager 没有告警,则检查 Prometheus 到 Alertmanager 的配置与连通性;Alertmanager 有活动告警但没有外部通知,再检查路由、静默、抑制和接收器。这样沿链路逐段验证,比直接修改阈值更容易定位真正的断点。