
可观测性与稳定性 / 系统课时
Alertmanager 在告警链路中做什么
Alertmanager 在告警链路中做什么
Prometheus 能判断异常条件是否持续成立,但它并不负责把每条告警直接发到所有聊天群、邮件或值班系统。Alertmanager 位于告警生成之后,专门处理告警的分组、路由、抑制和通知,让监控判断与通知策略彼此解耦。
学习目标
- 区分 Prometheus 与 Alertmanager 在告警链路中的职责
- 理解告警从规则触发到最终通知的主要处理阶段
- 判断分组、路由、静默和抑制分别适合解决什么问题
Prometheus 负责判断,Alertmanager 负责处理
Prometheus 周期性计算告警规则。当表达式满足条件并持续达到 for 指定的时间后,告警进入 firing 状态。Prometheus 随后把告警及其标签、注解等信息发送给配置好的 Alertmanager。
Alertmanager 接到的不是原始指标,也不会重新执行 PromQL。它处理的是已经由 Prometheus 判断出的告警事件,然后根据标签决定这些事件怎样组织以及发送到哪里。
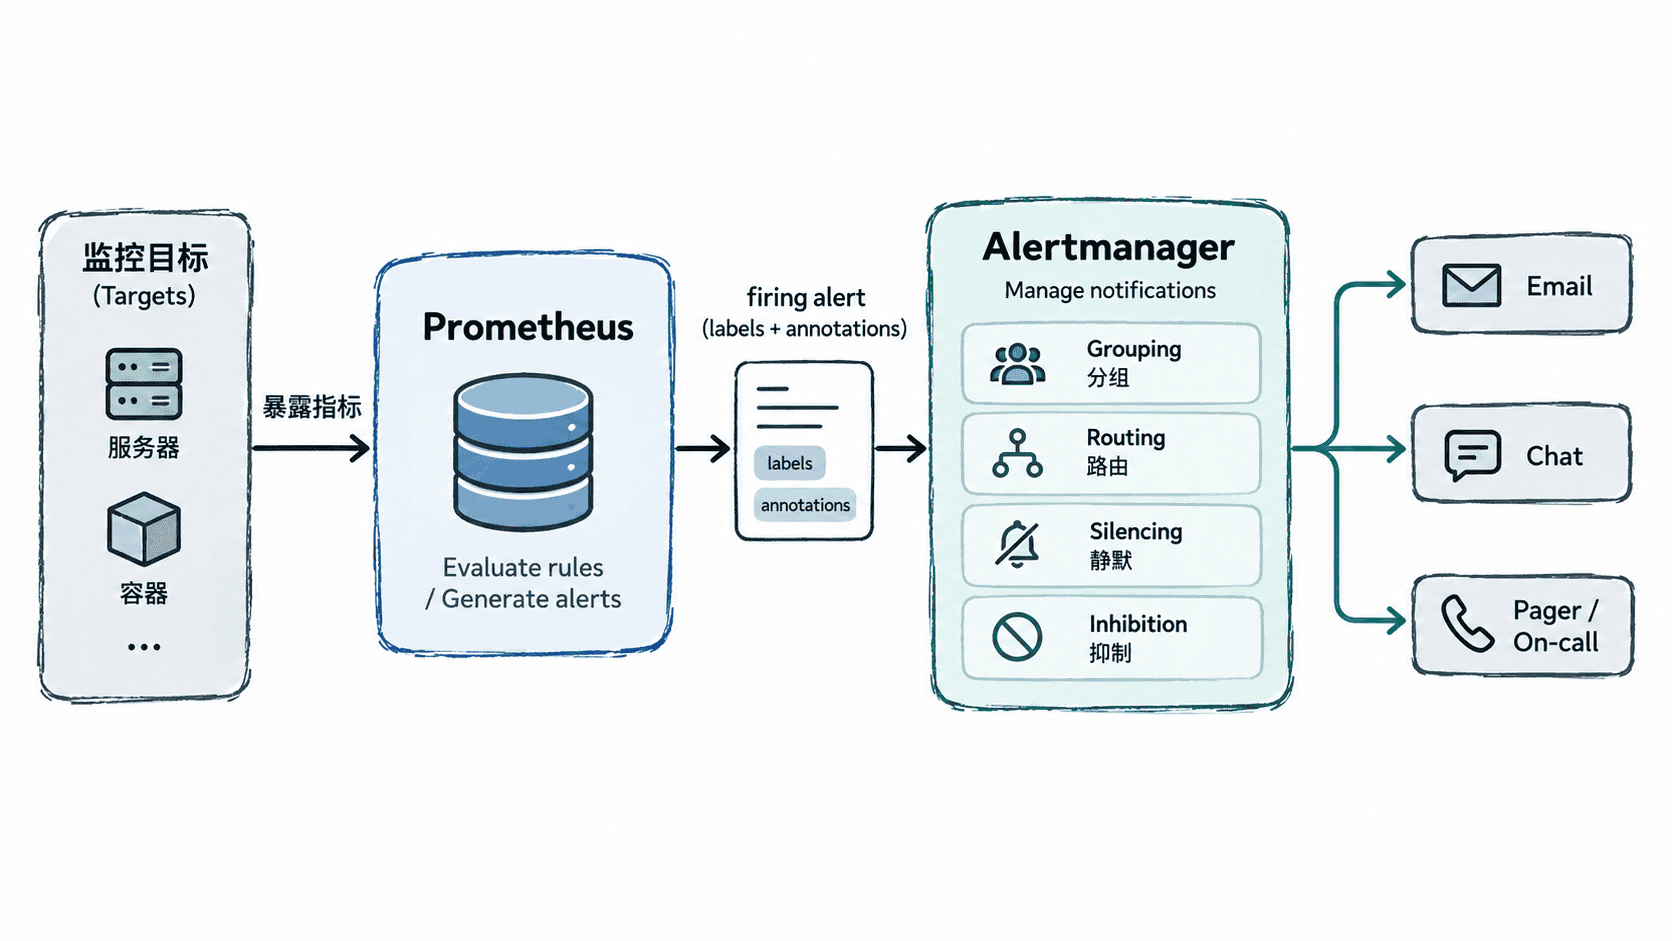
Alertmanager 主要处理四类事情
分组
如果 50 台服务器同时因同一上游故障产生告警,逐条发送 50 条消息通常没有价值。Alertmanager 可以根据 alertname、cluster 或其他标签把相关告警合并成一次通知,并在后续状态变化时更新这一组通知。
路由
路由根据标签选择接收者。例如 severity="critical" 可以进入值班渠道,team="database" 可以发送给数据库团队。路由解决的是“这条告警应该交给谁”,而不是判断告警是否成立。
静默
静默用于在计划维护等已知时间窗口内暂时阻止匹配告警产生通知。告警事件仍然存在,只是 Alertmanager 不发送对应通知,因此维护结束后无需修改 Prometheus 告警表达式。
抑制
抑制用于表达告警之间的依赖关系。例如“整个节点不可达”已经触发时,可以抑制该节点上的“磁盘不可访问”“服务探测失败”等次生告警,减少同一根因引发的通知风暴。
一条告警经过链路时发生什么
假设某主机磁盘空间不足,Prometheus 中的规则连续满足五分钟并进入 firing。Prometheus 把告警发送给 Alertmanager,其中可能包含 alertname="HostDiskAlmostFull"、severity="critical" 和 team="platform" 等标签。
Alertmanager 随后先查看是否存在匹配的静默或抑制条件,再根据分组策略把相关告警聚合,然后沿路由树查找接收者。如果规则将 critical 指向值班系统,这条告警才会最终产生对应通知。恢复后,Prometheus 将状态变化发送给 Alertmanager,通知端是否收到恢复消息则取决于接收器配置。
职责边界决定配置应该放在哪里
判断“磁盘剩余空间低于多少才算异常”属于监控条件,应写在 Prometheus 告警规则中;判断“严重告警发给值班人员,普通告警只进团队群”属于通知策略,应放在 Alertmanager。
这个边界能避免为了更换通知渠道而修改 PromQL,也避免把业务异常条件散落在通知系统里。实际设计时,可以用一句话判断配置位置:Prometheus 决定要不要产生告警,Alertmanager 决定产生告警以后怎样通知。