
可观测性与稳定性 / 系统课时
不同告警怎样发送给不同人员
不同告警怎样发送给不同人员
当所有告警都发进同一个群或邮箱,值班人员很快会被无关信息淹没。本节用 Alertmanager 的路由树按环境、服务和严重程度分流,并说明匹配顺序与 continue 如何决定一条告警最终进入哪些接收器。
学习目标
- 能根据
env、service、severity等标签编写分层路由 - 理解“首个匹配即停止”和
continue: true的差异 - 能用
amtool检查路由配置的基本合法性
路由树怎样决定接收器
Alertmanager 的 route 是一棵从根节点向下匹配的树。每条告警先进入根路由,再按子路由的 matchers 判断是否命中;如果子路由没有覆盖分组或时间参数,会继承父路由配置。
实际设计时应先约定稳定标签。例如生产环境使用 env="prod",数据库服务使用 service="mysql",最高优先级使用 severity="critical"。标签越稳定,后续路由越容易维护。
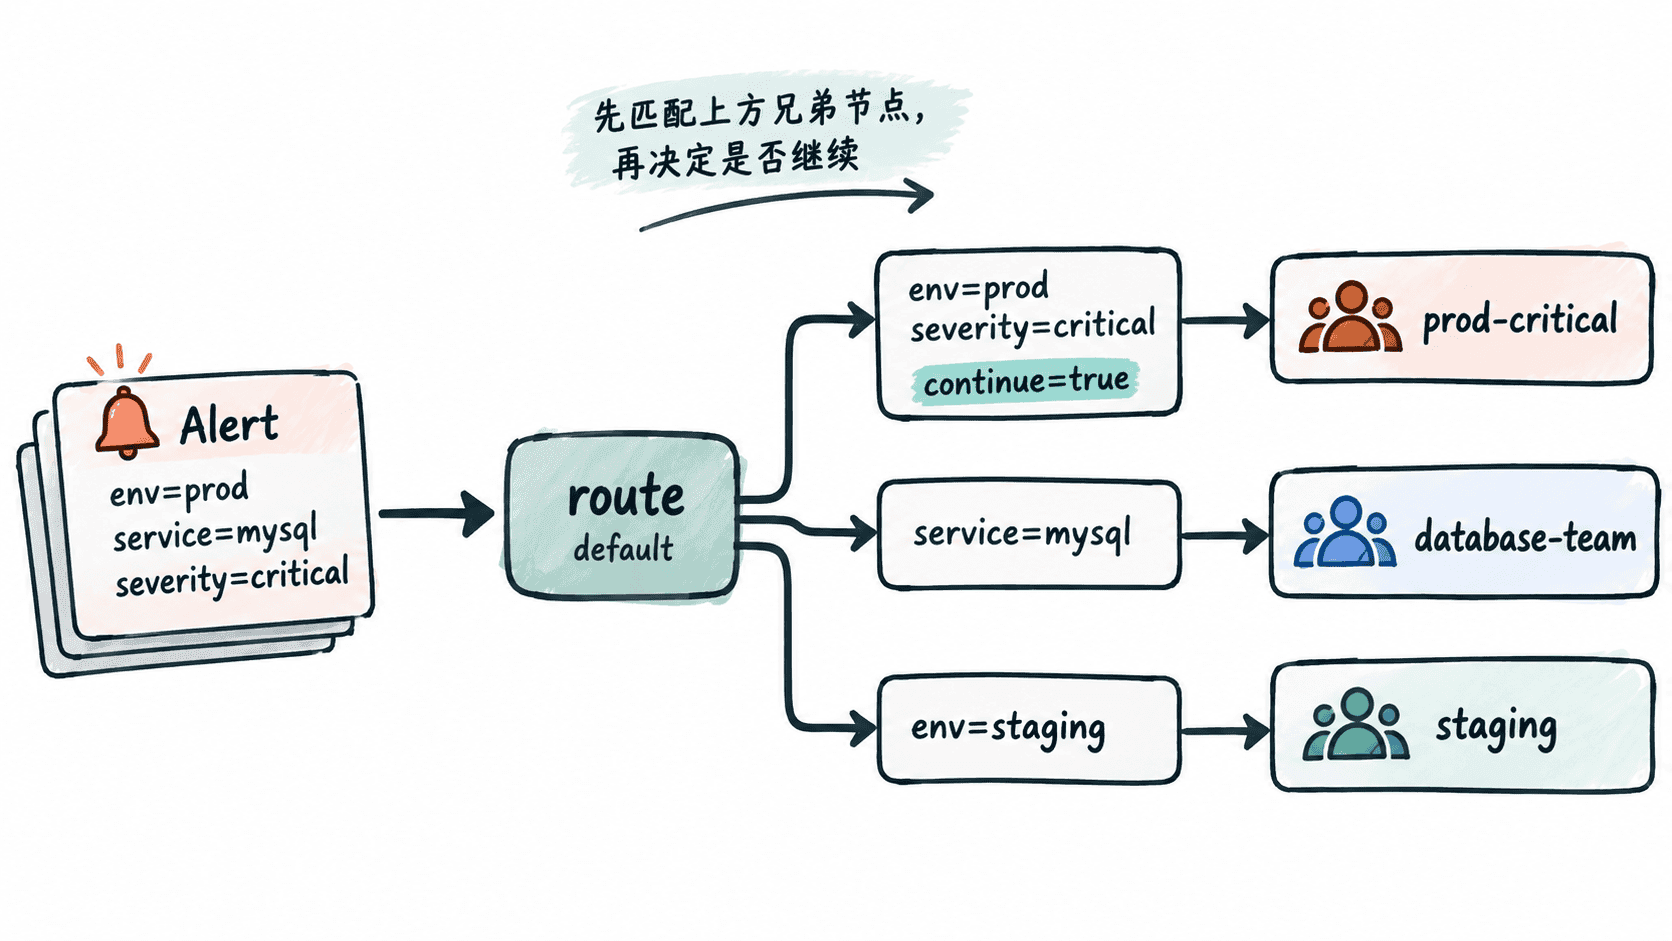
用标签编写分流规则
下面给出一个完整的最小配置。接收器只定义名称,重点演示路由逻辑;生产环境还需要在对应 receiver 中补充邮件、Webhook、PagerDuty 等实际通知集成。
route:
  receiver: default
  group_by: [alertname, env, service]
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
    - receiver: prod-critical
      matchers:
        - 'env="prod"'
        - 'severity="critical"'
      continue: true

    - receiver: database-team
      matchers:
        - 'service="mysql"'

    - receiver: staging
      matchers:
        - 'env="staging"'

receivers:
  - name: default
  - name: prod-critical
  - name: database-team
  - name: staging
这段配置的关键点不是“条件写得越多越好”,而是先把组织责任映射成标签。生产严重告警先进入 prod-critical;因为该节点设置了 continue: true,如果同时还是 MySQL 告警,还会继续命中 database-team。
如果去掉 continue: true,一旦命中 prod-critical,同级后续路由就不会再参与匹配。由此可见,兄弟路由的顺序本身就是配置语义的一部分。
先决定单发还是多发
多数告警只应该交给一个主要责任方,此时保持默认的 continue: false 更容易控制通知数量。只有确实需要“一条告警同时通知平台值班和业务团队”时,才在前面的匹配节点上开启 continue: true。
设计时可以按这个顺序判断:
- 先确定兜底接收器,保证没有命中任何子路由的告警也不会丢失。
- 再放置最具体、优先级最高的规则,例如生产环境严重告警。
- 最后添加按服务或环境划分的通用规则,并检查是否需要继续匹配后续兄弟节点。
验证配置是否合法
把配置保存为 alertmanager.yml 后,可使用随 Alertmanager 提供的 amtool 做语法与结构检查。
amtool check-config alertmanager.yml预期输出的关键结果是检查成功;不同版本可能还会输出 receiver、route 等统计行。
Checking 'alertmanager.yml' SUCCESS如果检查失败,应先修复 YAML 缩进、matcher 引号或接收器名称引用错误,再加载到 Alertmanager。路由配置通过语法检查后,还应选几组真实标签做人工推演:分别验证生产严重告警、数据库告警、测试环境告警以及没有任何匹配条件的告警,确认它们进入预期接收器。
让标签体系先于路由复杂度
路由本身并不负责判断“谁该处理故障”,它只是执行标签到接收器的映射。真正可维护的方案通常只有少量稳定维度,例如环境、团队、服务和严重程度。先统一这些标签,再写路由树,远比不断叠加正则和例外规则更可靠。