
可观测性与稳定性 / 系统课时
时间序列数量暴涨怎么查
时间序列数量暴涨怎么查
时间序列突然变多,最常见的原因不是“采样太频繁”,而是新指标或 Label 组合数量失控。本篇用 Prometheus 自带的 TSDB 统计接口先定位增长集中在哪个指标、哪个标签,再判断是否把用户 ID、原始 URL、请求参数等高基数字段误当成 Label。
学习目标
- 用 TSDB 统计快速定位序列数增长集中在哪些指标和标签
- 判断高基数 Label 为什么会把一个指标拆成大量时间序列
- 按“定位、修复、验证”的顺序处理基数暴涨问题
先确认是不是基数问题
Prometheus 中,一组唯一的“指标名 + 全部 Label 键值”就是一条时间序列。采样间隔变短主要增加样本数;Label 新增大量不同取值,则会直接增加时间序列数。
例如 http_requests_total{method="GET",route="/orders"} 与 http_requests_total{method="GET",route="/users"} 是两条序列。如果把 user_id 放进 Label,10 万个活跃用户就可能把原本几十条序列扩成数十万条;若再叠加原始 URL、Pod、状态码等维度,组合数会继续相乘。
先看现象是否同时伴随 Prometheus 内存上涨、WAL 写入变大或查询变慢,但不要直接据此猜根因。真正需要确认的是:当前 Head 中有多少序列,以及增长集中在哪里。
用 TSDB 统计找到异常指标和标签
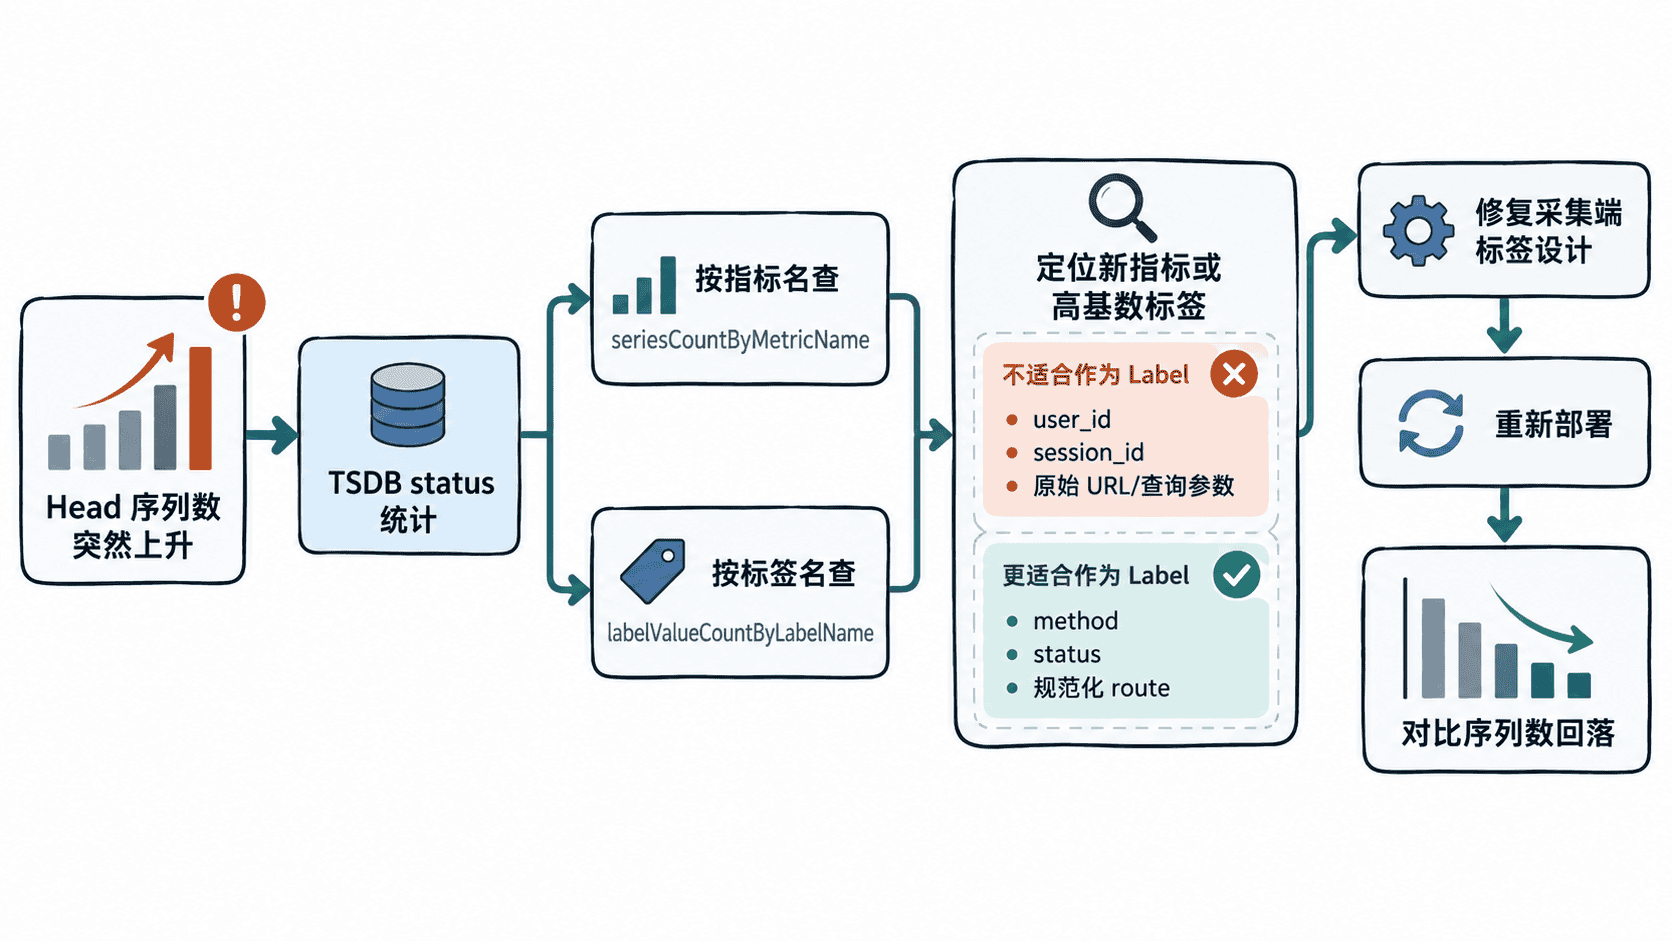
Prometheus 的 /api/v1/status/tsdb 会返回当前 Head 的序列数量、按指标名统计的序列数、按标签名统计的取值数量,以及高占用的标签键值对。下面的命令需要本机已有 curl 和 jq,并假设 Prometheus 地址为 http://localhost:9090。
PROM_URL="${PROM_URL:-http://localhost:9090}"
curl -fsS "$PROM_URL/api/v1/status/tsdb?limit=20" > /tmp/prom-tsdb.json

jq -r '
  "numSeries=" + (.data.headStats.numSeries|tostring),
  "",
  "top metrics:",
  (.data.seriesCountByMetricName[] | "metric=" + .name + " series=" + (.value|tostring)),
  "",
  "top label value counts:",
  (.data.labelValueCountByLabelName[] | "label=" + .name + " values=" + (.value|tostring))
' /tmp/prom-tsdb.json
预期输出
numSeries=<COUNT>

top metrics:
metric=<METRIC_NAME> series=<COUNT>
...

top label value counts:
label=<LABEL_NAME> values=<COUNT>
...<COUNT>、<METRIC_NAME> 和 <LABEL_NAME> 会随实际数据变化。排查时先找最近突然进入榜单或数量明显变大的指标,再看是否同时出现取值数量异常的业务标签。__name__、instance 等标签本身可能排在前面,不应只凭“排名第一”就认定为问题。
识别不适合作为 Label 的字段
判断一个字段能不能做 Label,不是看它“有没有业务意义”,而是看它的取值集合是否受控、是否真的需要用于聚合和筛选。下面几类字段尤其危险:
- 用户 ID、订单 ID、Trace ID、Session ID:取值接近对象数量,通常持续增长。
- 原始 URL 或完整路径:
/users/123与/users/456会变成不同取值;应优先暴露规范化路由,如/users/:id。 - 查询参数、时间戳、随机值:几乎每次请求都可能产生新值。
- 错误消息全文:文本内容变化多,适合日志,不适合指标 Label。
一个实用判断是:如果这个值更像“事件详情”而不是“有限维度”,通常应放到日志或 Trace 中,而不是长期进入指标标签集合。
修复时先控制新序列继续产生
最优修复位置通常在应用埋点或 Exporter:删除高基数 Label,或把原始值归一化为有限集合。例如保留 route="/users/:id",而不是记录真实用户路径。这样既减少新序列,也保留按接口聚合的能力。
如果暂时无法修改源端,可在抓取侧临时丢弃问题指标,避免基数继续膨胀;但这会直接失去该指标数据,只适合作为止血措施。不要随意通过 labeldrop 删除唯一性关键标签,因为不同样本在标签被移除后可能碰撞,必须先确认剩余标签仍能唯一表达需要保留的序列。
修复后重新执行前面的 TSDB 统计,并与故障期间保存的结果比较。重点看问题指标的序列数、可疑 Label 的取值数量,以及 headStats.numSeries 是否停止增长。旧序列不会因为修改埋点立即从所有历史块中消失,因此验证重点是不再持续产生新组合,而不是要求总数瞬间归零。