
可观测性与稳定性 / 系统课时
监控和告警有什么区别
监控和告警有什么区别
监控和告警使用的是同一批运行数据,但解决的问题不同:监控让人看见系统正在发生什么,告警则持续判断某个条件是否已经值得通知人员。分清这两层,才能避免把每个波动都做成告警,也不会只做漂亮图表却错过真正需要响应的故障。
学习目标
- 区分监控、告警判断和通知三个职责。
- 理解为什么“指标异常”不等于“必须通知”。
- 能为一个监控指标判断是否需要告警条件与持续时间。
监控负责保留和呈现状态
监控的核心是持续采集、保存、查询和展示系统状态。例如 CPU 使用率、内存余量、磁盘空间、请求延迟和错误率,都可以成为时间序列。Grafana 仪表盘把这些数据组织成趋势图,帮助人判断“什么时候开始异常”“影响了哪些主机”“恢复后是否回到基线”。
因此,即使某项指标暂时越过经验阈值,监控本身也不要求立即通知。它首先要保证数据可观察、可回看,给排障提供上下文。
告警是在监控数据上持续做条件判断
告警会周期性评估表达式,把“观察到的数据”转成“是否需要行动”的状态。在 Prometheus 体系中,Prometheus 负责评估告警规则;触发后的告警可以交给 Alertmanager 做聚合、抑制、静默和路由,再发送到邮件、聊天工具或值班系统。
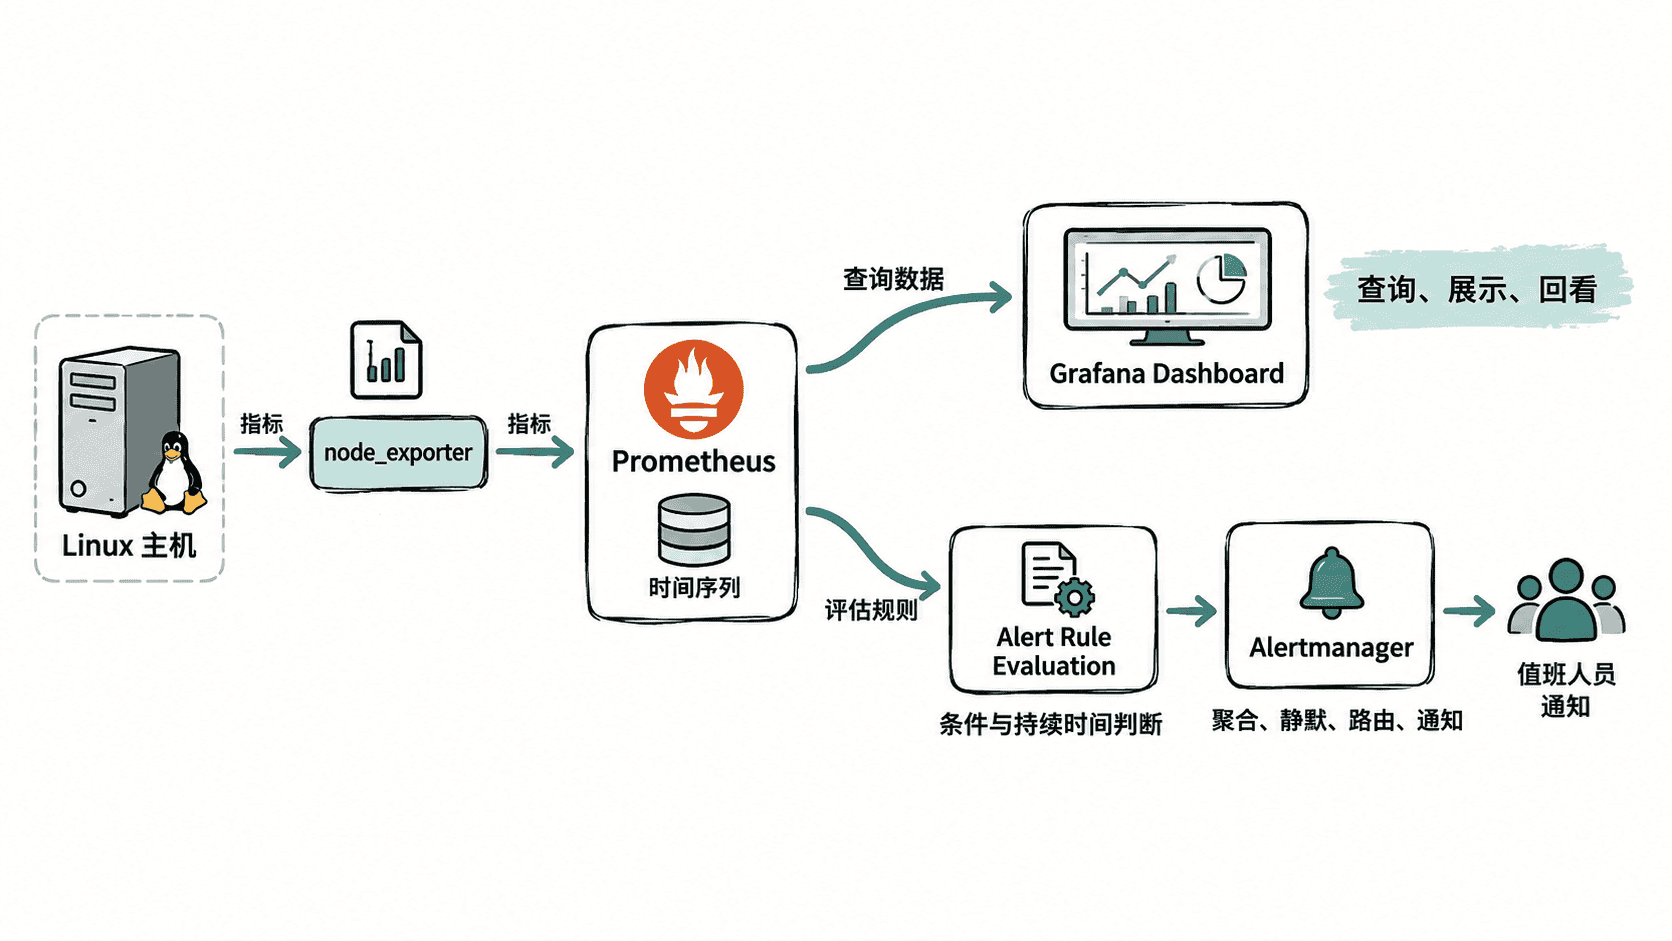
这条链路说明了一个关键边界:Dashboard 上出现红色区域只是“值得关注的信号”,只有规则条件成立,并达到设定的持续时间或其他约束后,才应该进入通知流程。
不要把所有异常都变成通知
好的告警条件通常对应“需要人在有限时间内采取动作”。例如磁盘使用率短暂升高后自动回落,适合继续监控;如果可用空间持续逼近耗尽,并且增长趋势表明很快会写满,就更有理由通知值班人员。
持续时间可以过滤瞬时抖动。例如把条件设计为“CPU 使用率高于某阈值并持续 10 分钟”,与“只要某个采样点超过阈值就通知”相比,更不容易因为短暂峰值产生噪声。具体阈值和持续时间应依据业务负载、容量和响应要求确定,不能照搬固定数字。
用三个问题判断是否值得告警
设计告警时,可以依次检查三个问题:
- 这个条件是否代表用户体验、服务可用性或容量风险正在明显恶化?
- 收到通知的人是否有明确动作,例如扩容、回滚、切流或处理故障主机?
- 如果暂时不通知,仅保留在 Dashboard 中观察,是否可能错过需要及时处理的窗口?
如果第一个问题只是“指标看起来不正常”,第二个问题又没有可执行动作,这更像监控项而不是告警项。监控让问题可见,告警只把真正需要响应的那一小部分状态升级成通知。