
可观测性与稳定性 / 系统课时
接入多台 Linux 服务器指标
接入多台 Linux 服务器指标
当第一台服务器已经能够被 Prometheus 抓取后,扩展到多台主机的关键不是复制一套 Prometheus,而是把多个 Node Exporter 目标加入同一个抓取任务,并利用 job、instance 以及自定义标签区分来源。完成后可以用同一条 PromQL 同时检查所有服务器状态。
学习目标
- 把多台运行 Node Exporter 的 Linux 服务器加入同一 Prometheus
- 理解 Prometheus 自动生成的
job与instance标签 - 验证所有目标均可抓取,并按标签定位具体服务器
先确认每台服务器都能被抓取
假设已经有两台 Linux 主机 linux-a.internal 和 linux-b.internal,Node Exporter 均监听默认的 9100 端口。Prometheus 不会替你解决网络问题,所以应先从 Prometheus 所在主机直接访问两个指标端点。
for host in linux-a.internal linux-b.internal; do
  printf '%s: ' "$host"
  curl -fsS "http://$host:9100/metrics" >/dev/null && echo reachable || echo failed
done
预期输出
linux-a.internal: reachable
linux-b.internal: reachable
如果这里已经显示 failed,应先检查 Node Exporter 进程、监听地址、DNS、路由或防火墙。只有 Prometheus 主机能够访问目标的 /metrics 接口,后续抓取配置才有意义。
把多个目标放进同一个抓取任务
编辑 Prometheus 的 prometheus.yml,为 Linux 主机建立一个独立的 job_name。下面配置把两台服务器加入同一任务,并额外添加环境和角色标签:
global:
  scrape_interval: 15s

scrape_configs:
  - job_name: linux-node
    static_configs:
      - targets:
          - linux-a.internal:9100
        labels:
          env: prod
          role: web
      - targets:
          - linux-b.internal:9100
        labels:
          env: prod
          role: db
这段配置生效后,Prometheus 会自动为时间序列附加 job="linux-node"。instance 默认取抓取目标地址,因此两台服务器分别得到 instance="linux-a.internal:9100" 和 instance="linux-b.internal:9100"。自定义的 env、role 则可以用于后续筛选、聚合和 Grafana 变量。
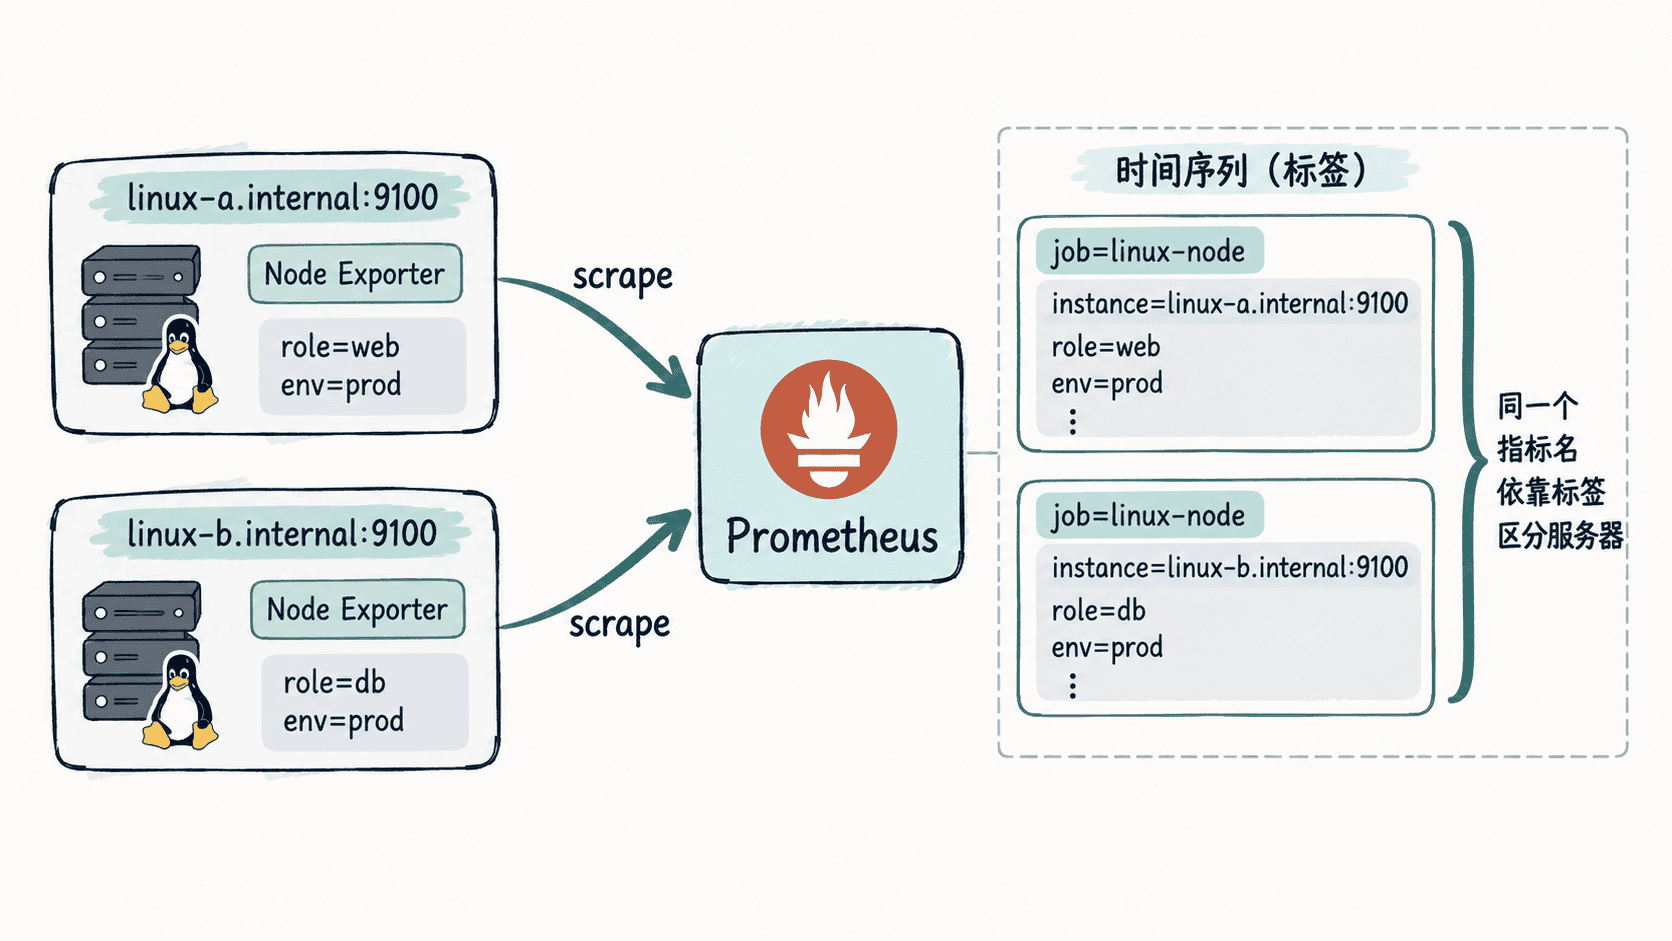
修改配置后,应按你的部署方式让 Prometheus 重新加载配置。启用了生命周期接口时可以调用 /-/reload;使用 systemd、容器或编排平台时,也可以采用对应的配置重载或滚动重启机制。不要假设所有环境都默认开放重载接口。
用标签确认每台主机都处于 UP
Prometheus 的 up 指标最适合做第一轮验收。它的值为 1 表示最近一次抓取成功,为 0 表示目标存在但抓取失败。下面通过 HTTP API 查询 linux-node 任务,并用 jq 只打印实例和值:
curl -fsS --get 'http://prometheus.internal:9090/api/v1/query' \
  --data-urlencode 'query=up{job="linux-node"}' \
  | jq -r '.data.result[] | "\(.metric.instance) \(.value[1])"'
预期输出
linux-a.internal:9100 1
linux-b.internal:9100 1
如果只出现一台服务器,先检查另一目标是否已经进入当前配置;如果实例存在但值为 0,则说明 Prometheus 已识别目标,但抓取请求失败,应回到网络、端口和 Node Exporter 日志继续定位。
用 instance 和业务标签回答不同问题
instance 适合回答“是哪一个抓取端点出了问题”,例如查看某台服务器的可用状态:
up{job="linux-node",instance="linux-a.internal:9100"}role、env 这类自定义标签则适合表达运维语义。例如 Grafana 面板可以筛选 env="prod",告警规则也可以按 role 区分 Web 与数据库节点。不要把主机名、机房、业务、负责人等所有信息都拼进指标名称,Prometheus 的标签机制就是为这些维度设计的。
接入更多 Linux 服务器时,核心流程保持不变:先保证每台 Node Exporter 可从 Prometheus 访问,再把目标加入合适的 job,最后用 up 和标签验证。这样一套 Prometheus 就能够统一采集多台服务器,同时仍能准确定位每条指标属于哪一个实例。