
可观测性与稳定性 / 系统课时
for 为什么能减少瞬时误报
for 为什么能减少瞬时误报
CPU 短时间冲到 90% 并不一定意味着故障:批处理、压缩或启动阶段都可能产生正常峰值。Prometheus 告警规则中的 for 可以要求异常条件持续成立一段时间,再把告警变为 firing,从而过滤只出现几十秒的瞬时波动。
学习目标
- 理解告警从 inactive、pending 到 firing 的状态变化
- 使用
for要求异常条件持续满足指定时间 - 区分 PromQL 时间窗口与告警持续时间的不同作用
没有 for 时发生什么
假设 CPU 告警表达式为:
100 * (1 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]))) > 80如果没有配置 for,某次规则计算只要发现 CPU 使用率超过 80%,对应告警实例就可以立即进入 firing。对于真正持续的高负载,这很及时;但一次几十秒的正常峰值也可能满足表达式,于是产生不必要的通知。
告警噪声的问题通常不在于 PromQL 算错,而在于“超过阈值一次”与“持续异常”表达的是两种不同条件。
for 引入 pending 状态
给规则增加 for: 10m 后,表达式首次满足条件时不会立即 firing,而是先进入 pending。只有同一个告警实例持续满足条件至少 10 分钟,才会进入 firing。
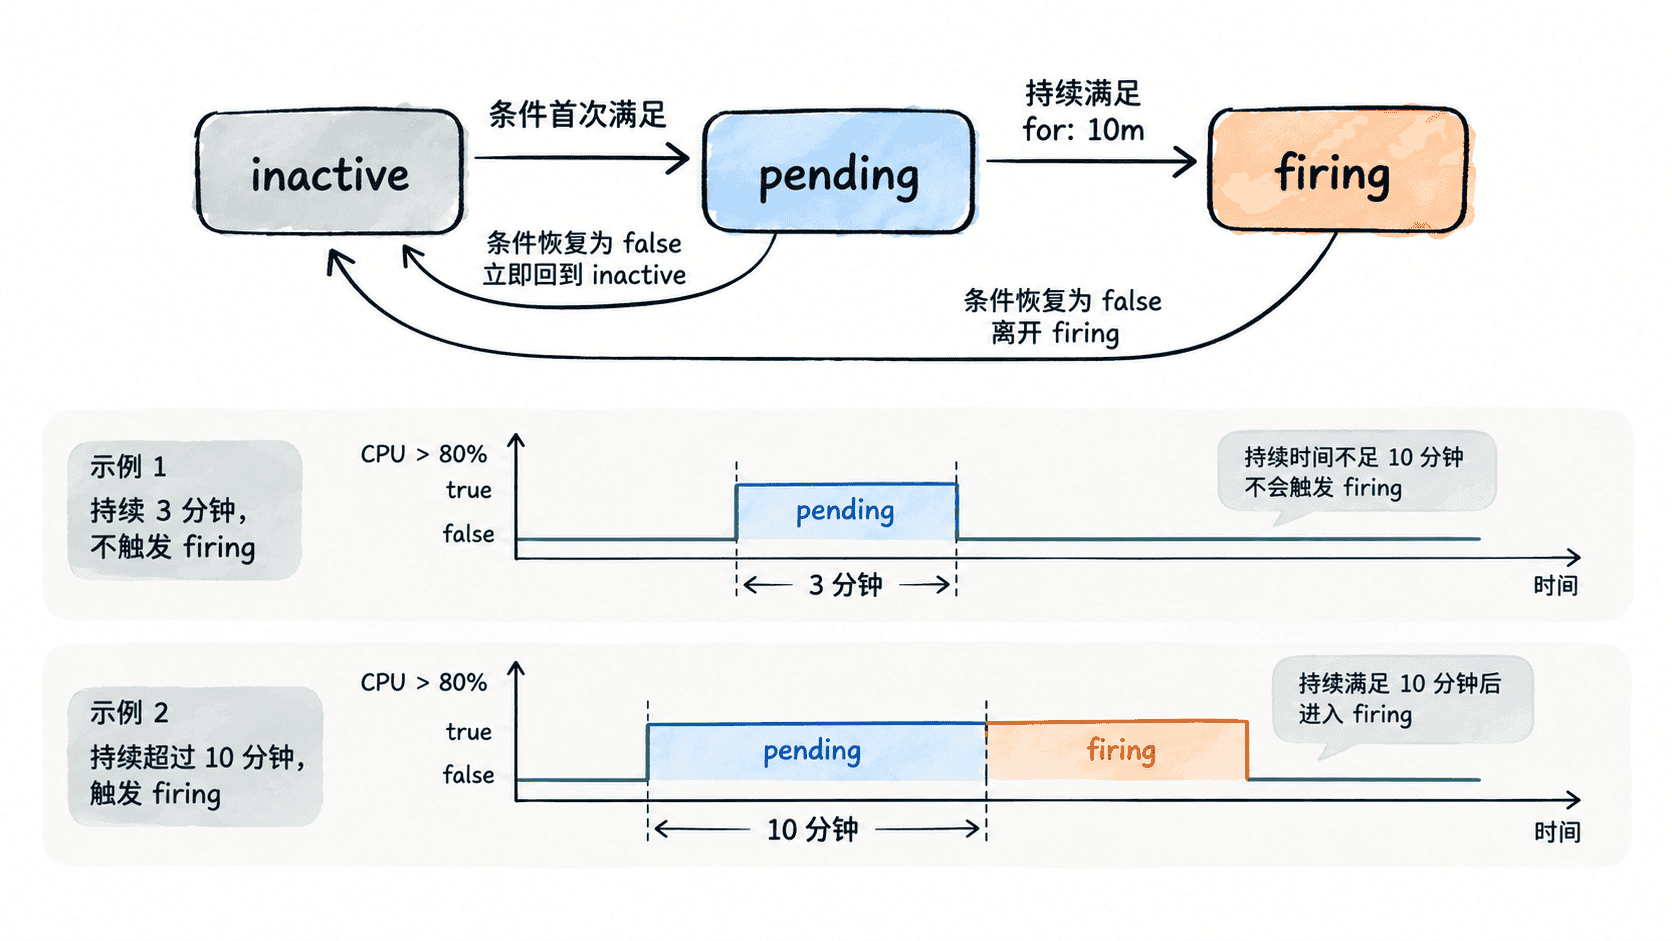
关键点是 pending 期间条件必须持续成立。如果 CPU 在第 7 分钟降回阈值以下,这次 pending 会被取消;下次再次超过阈值时,需要重新累计持续时间,而不是从之前的 7 分钟继续计算。
给 CPU 告警增加持续时间
下面的规则要求 CPU 使用率超过 80% 并持续 10 分钟,才真正触发 HostHighCpuUsage:
groups:
  - name: host-resource-alerts
    rules:
      - alert: HostHighCpuUsage
        expr: 100 * (1 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]))) > 80
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: '主机 CPU 持续高使用率'
          description: '实例 {{ $labels.instance }} 的 CPU 使用率持续超过 80%,当前表达式值为 {{ $value }}%。'
这里的 10m 是告警状态条件,不会改变 PromQL 本身的计算结果。表达式仍然按照 [5m] 窗口估算当前 CPU 使用率,只是 Prometheus 会额外记录该告警实例已经连续满足表达式多久。
规则修改后,可以先做语法检查。将 <PATH> 替换为实际规则目录:
promtool check rules <PATH>/host-alerts.yml预期输出类似:
Checking <PATH>/host-alerts.yml
  SUCCESS: 1 rules found
实际提示文字可能随 Prometheus 版本略有变化,但检查应成功结束。如果 for 的持续时间格式无效或 YAML 结构错误,promtool 会直接报告规则无法解析。
不要把时间窗口和 for 混为一谈
rate(...[5m]) 与 for: 10m 经常同时出现,但解决的问题完全不同。
| 配置 | 作用 | 本例含义 |
|---|---|---|
[5m] |
PromQL 计算窗口 | 用最近 5 分钟样本估算 CPU 空闲速率 |
> 80 |
异常阈值 | CPU 使用率高于 80% 才返回时间序列 |
for: 10m |
告警持续条件 | 返回的同一告警实例连续存在 10 分钟才 firing |
把 [5m] 改成 [10m] 只会让 CPU 使用率计算更平滑,并不等价于“连续高 10 分钟”。反过来,增加 for 也不会改变当前查询出来的 CPU 百分比。
for 应该设置多长
for 没有适用于所有服务器的固定值。设置太短,瞬时峰值仍容易产生噪声;设置太长,则可能延迟真正故障的发现。CPU 容量类告警通常可以容忍一定等待时间,而进程消失、服务完全不可用等故障往往需要更快响应。
选择持续时间时,应观察正常业务峰值通常能维持多久,再让 for 略高于这些可接受波动。这样设计出来的告警表达的不再是“CPU 曾经高过”,而是“CPU 已经持续高到值得人工关注”。