
可观测性与稳定性 / 系统课时
先设计主机监控的信息层级
先设计主机监控的信息层级
搭建 Linux 主机 Dashboard 前,先确定页面要按什么顺序回答问题,比直接拖入 CPU、内存和磁盘图表更重要。本课先建立总体状态到资源细节的信息层级,让仪表盘能够快速判断主机是否异常,并自然引导后续排查。
学习目标
- 设计主机监控从总体状态到资源详情的阅读顺序
- 为 CPU、内存、磁盘和网络选择合适的信息层级
- 区分总览指标、趋势指标与下钻指标的职责
先定义仪表盘要回答的问题
主机监控最先需要回答的不是“CPU 当前是多少”,而是“这台主机现在是否值得关注”。因此页面顶部应优先放置能够直接表达总体状态的信息,例如主机是否在线、运行时长、CPU 总体压力、内存可用量、根文件系统空间和关键告警数量。
继续向下浏览时,问题才逐渐变成“异常来自哪里”。此时再展开 CPU、内存、磁盘和网络的趋势及组成。这样的顺序能避免使用者一打开页面就面对大量时间序列,却不知道应该先看哪一张。
按从总览到资源的顺序分区
一个单机监控 Dashboard 可以采用“总体状态 → CPU → 内存 → 磁盘 → 网络”的纵向结构。它并不是唯一正确顺序,但符合多数 Linux 主机故障从发现到定位的阅读习惯。
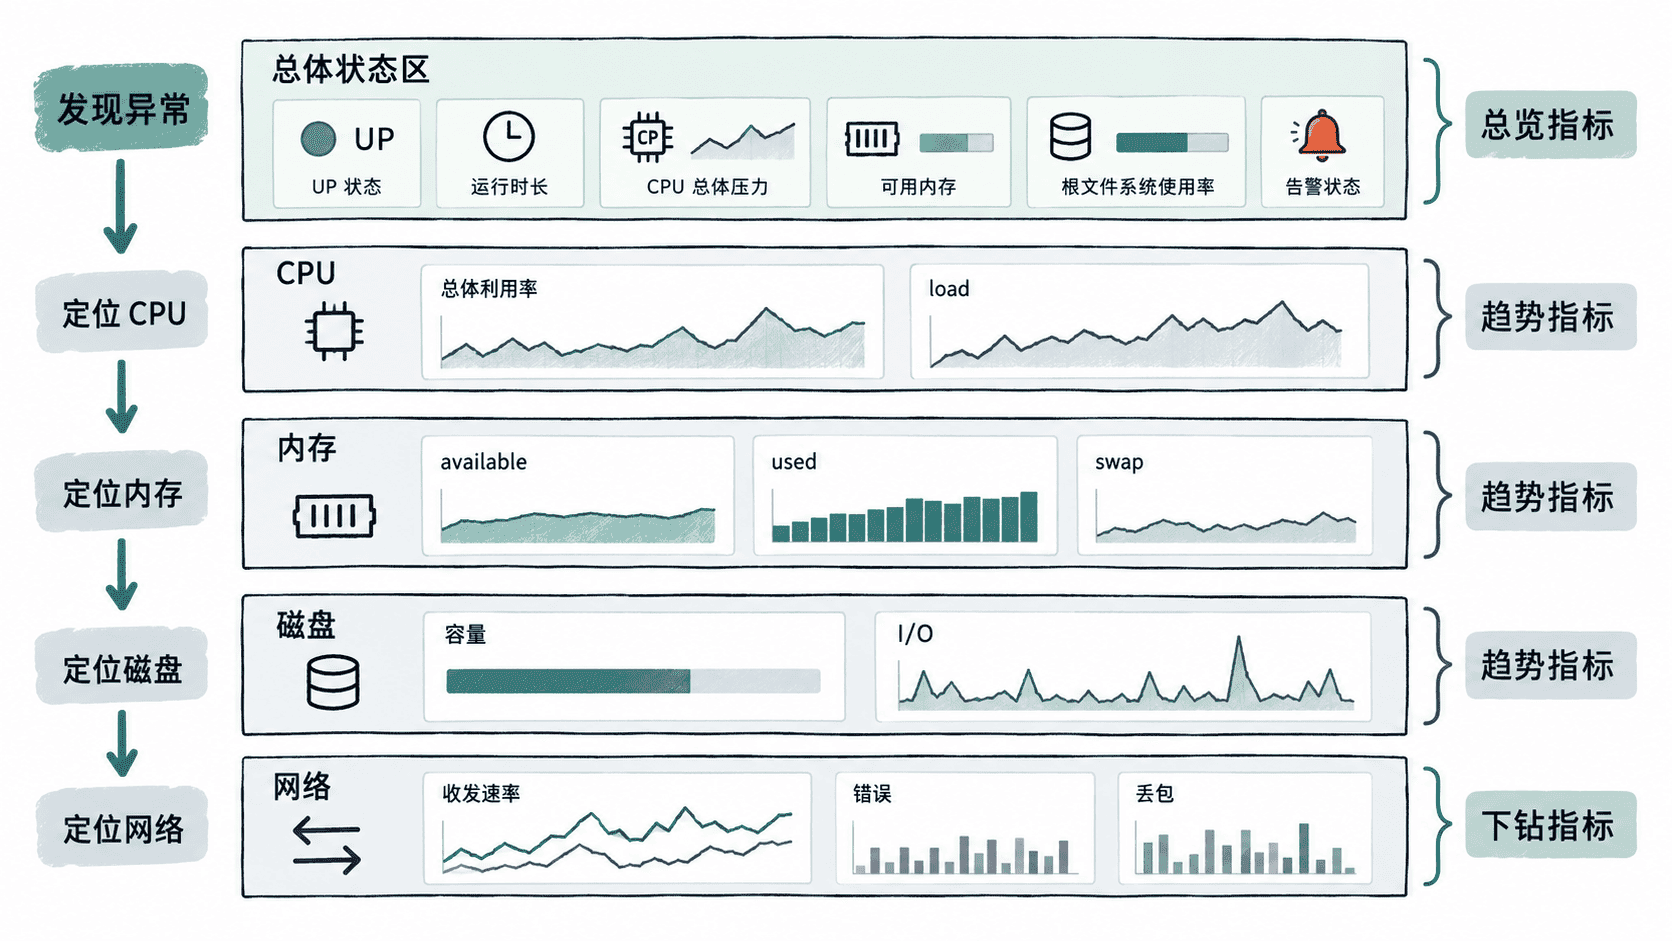
总体状态区应尽量短,让关键状态在首屏完成扫描。CPU、内存等资源区则可以使用较宽的时间序列 Panel,因为这里关注的是异常出现的时间、持续时间和变化趋势,而不仅是当前瞬时值。
给不同资源分配不同问题
CPU 区域不应只有一个使用率数字。除总体忙碌程度外,还需要能够区分 user、system、iowait 等主要时间去向,并结合 load 判断任务是否正在排队。这样才能区分真正的计算压力和由存储等待造成的假性 CPU 问题。
内存区域应围绕“系统还有多少可用内存”组织,而不是把 free 内存单独当成健康判断依据。Linux 会主动利用空闲内存作为缓存,因此 available、实际使用结构以及 swap 活动通常比单独的 free 值更有解释力。
磁盘需要拆成容量和性能两个问题。文件系统使用率回答“空间是否快满”,I/O 延迟、吞吐和忙碌程度回答“存储是否成为性能瓶颈”。这两组信息不能互相替代。
网络区域则优先关注收发速率、错误和丢包。连接级或协议级的更细指标可以留给专门的网络详情页,避免单机总览无限扩张。
区分总览、趋势和下钻
同一个指标在不同层级可以有不同表现形式。总览层适合显示当前状态或短时间窗口的聚合结果,趋势层关注一段时间内的变化,下钻层才展开设备、CPU 核心、挂载点或网卡等高基数维度。
例如磁盘总览可以只显示最危险文件系统的使用率;趋势区域展示主要挂载点变化;需要定位具体目录或设备时,再进入更细的 Dashboard。这样既保留诊断能力,也不会让首屏被几十条设备曲线占满。
主机监控页面最终应形成清晰的阅读路径:顶部回答“主机是否异常”,资源分区回答“异常属于哪类资源”,更细的维度负责回答“具体是哪一个设备或组成部分”。先确定这条路径,再决定每个 Panel 放什么指标,通常比从现成 Dashboard 逐个删图更容易得到稳定可用的结果。