
可观测性与稳定性 / 系统课时
平均响应时间为什么可能骗人
平均响应时间为什么可能骗人
平均响应时间能告诉你整体趋势,却很容易把少量极慢请求“摊薄”。当绝大多数请求很快、只有少数请求卡住时,平均值可能仍然看起来健康,因此分析服务体验时必须同时观察尾部延迟。
学习目标
- 解释平均值为何会掩盖少量高延迟请求
- 区分平均延迟与 P95、P99 分位数表达的含义
- 判断什么时候应把分位数作为主要延迟指标
平均值会怎样掩盖尾部请求
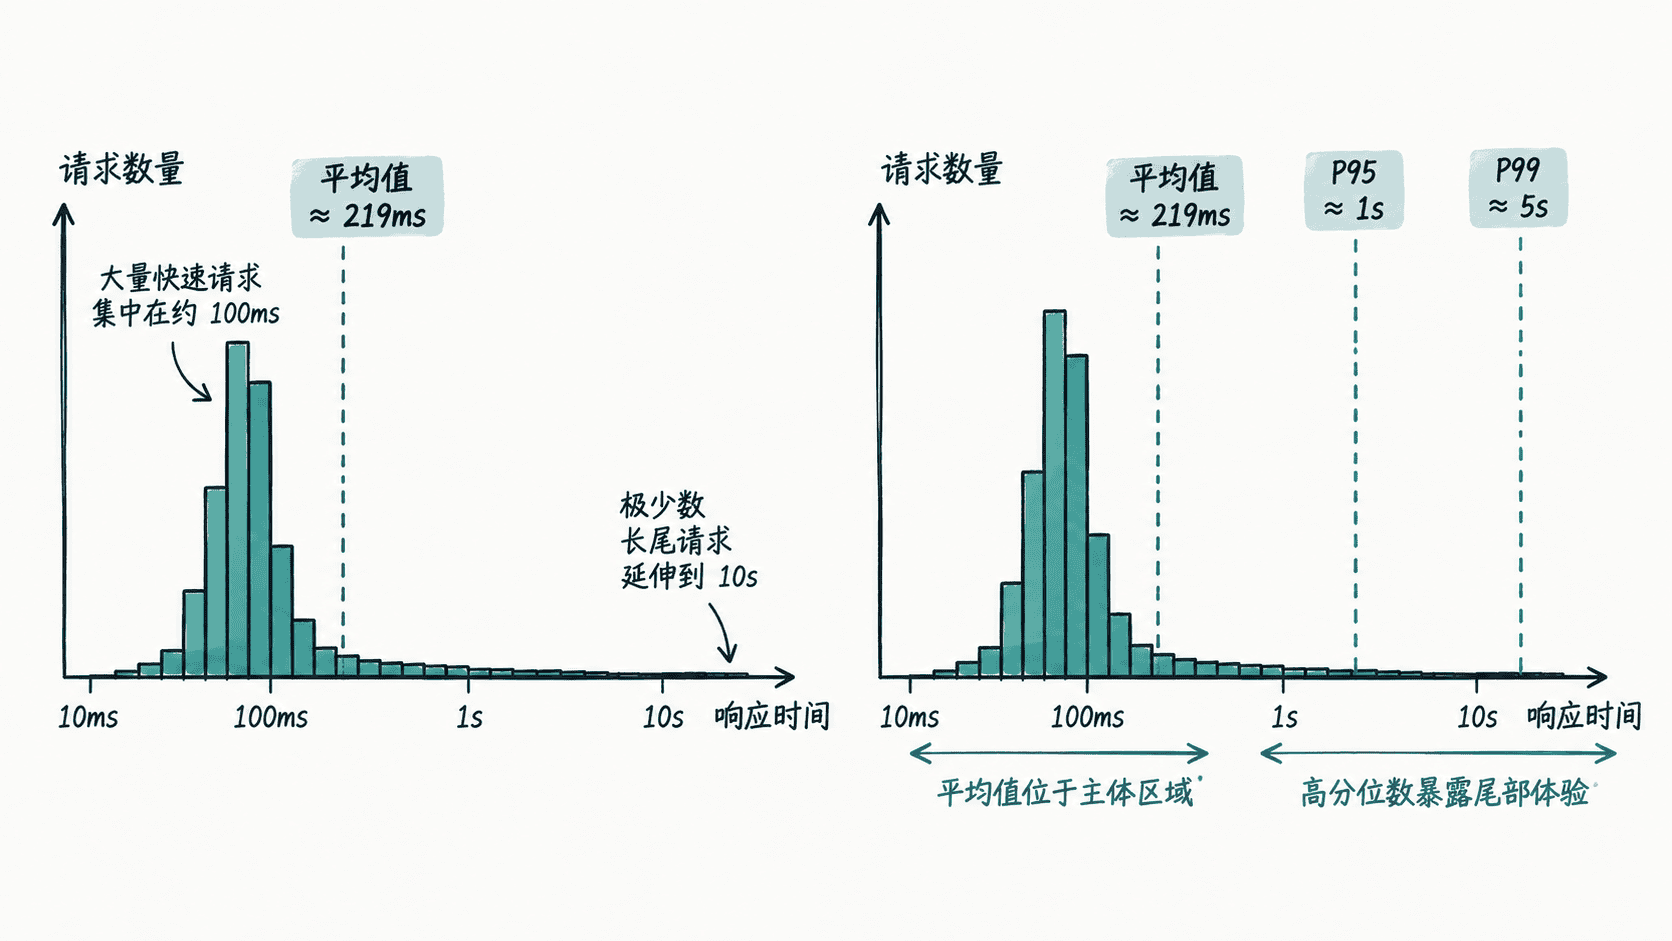
假设 100 个请求中,94 个耗时 100 ms,5 个耗时 500 ms,1 个耗时 10 s。平均值约为 219 ms,看上去只是“略慢”;但那个 10 s 请求对真实用户来说已经接近超时体验。
平均值回答的是“所有请求摊在一起,每个请求平均耗时多少”,它不会告诉你慢请求集中在分布的哪个尾部。只要慢请求占比很低,它们就可能被大量快速请求稀释。
在 Prometheus 中算平均响应时间
如果应用暴露经典 Histogram 或 Summary 产生的累计耗时与请求计数,例如 http_request_duration_seconds_sum 和 http_request_duration_seconds_count,5 分钟窗口内的平均响应时间可以用两者的速率相除。下面假设这两个指标真实存在,并且标签集合兼容。
sum(rate(http_request_duration_seconds_sum[5m]))
/
sum(rate(http_request_duration_seconds_count[5m]))
预期结果
返回一个以秒为单位的平均响应时间序列;具体数值随最近 5 分钟的请求流量变化。这个查询适合看整体趋势和容量变化,但不能替代尾延迟分析。平均值稳定,只能说明“总体没有明显漂移”,不能证明所有用户都获得稳定体验。
P95 和 P99 在回答什么
P95 表示约 95% 的请求延迟不高于该值,剩余约 5% 更慢;P99 则把观察位置推进到最慢的约 1% 请求附近。它们不是“最慢请求”,也不是“95% 请求的平均值”。
分位数特别适合回答“绝大多数用户最慢会等多久”这类问题。P95 常用于持续观察服务体验,P99 对缓存穿透、偶发 GC、下游抖动或少量慢查询更敏感,但也更容易受低流量和偶发异常影响。
监控时不要只保留一个数字
延迟监控通常同时保留平均值和高分位数。平均值适合判断总体资源与吞吐变化,高分位数适合发现尾部退化;两者一起看,才能区分“所有请求都稍微变慢”和“只有少量请求突然极慢”。
当平均值正常而 P95、P99 持续升高时,应优先把注意力放到慢请求路径、下游依赖和资源抖动上,而不是被“平均响应时间正常”误导。