
大模型原理与训练 / 系统课时
追踪张量形状与序列维度
追踪张量形状与序列维度
Transformers 的许多报错最终都能归结为某个张量维度不符合预期。本节沿着 batch、sequence、hidden 三个核心维度追踪一次真实模型前向计算,并建立一套从输入到分类头逐层检查 shape 的定位方法。
学习目标
- 读懂常见的
(batch, sequence)与(batch, sequence, hidden)张量形状 - 沿 tokenizer、Transformer 编码器和下游层追踪维度变化
- 在 shape 不匹配时快速判断错误发生在哪一个维度
先给三个维度固定含义
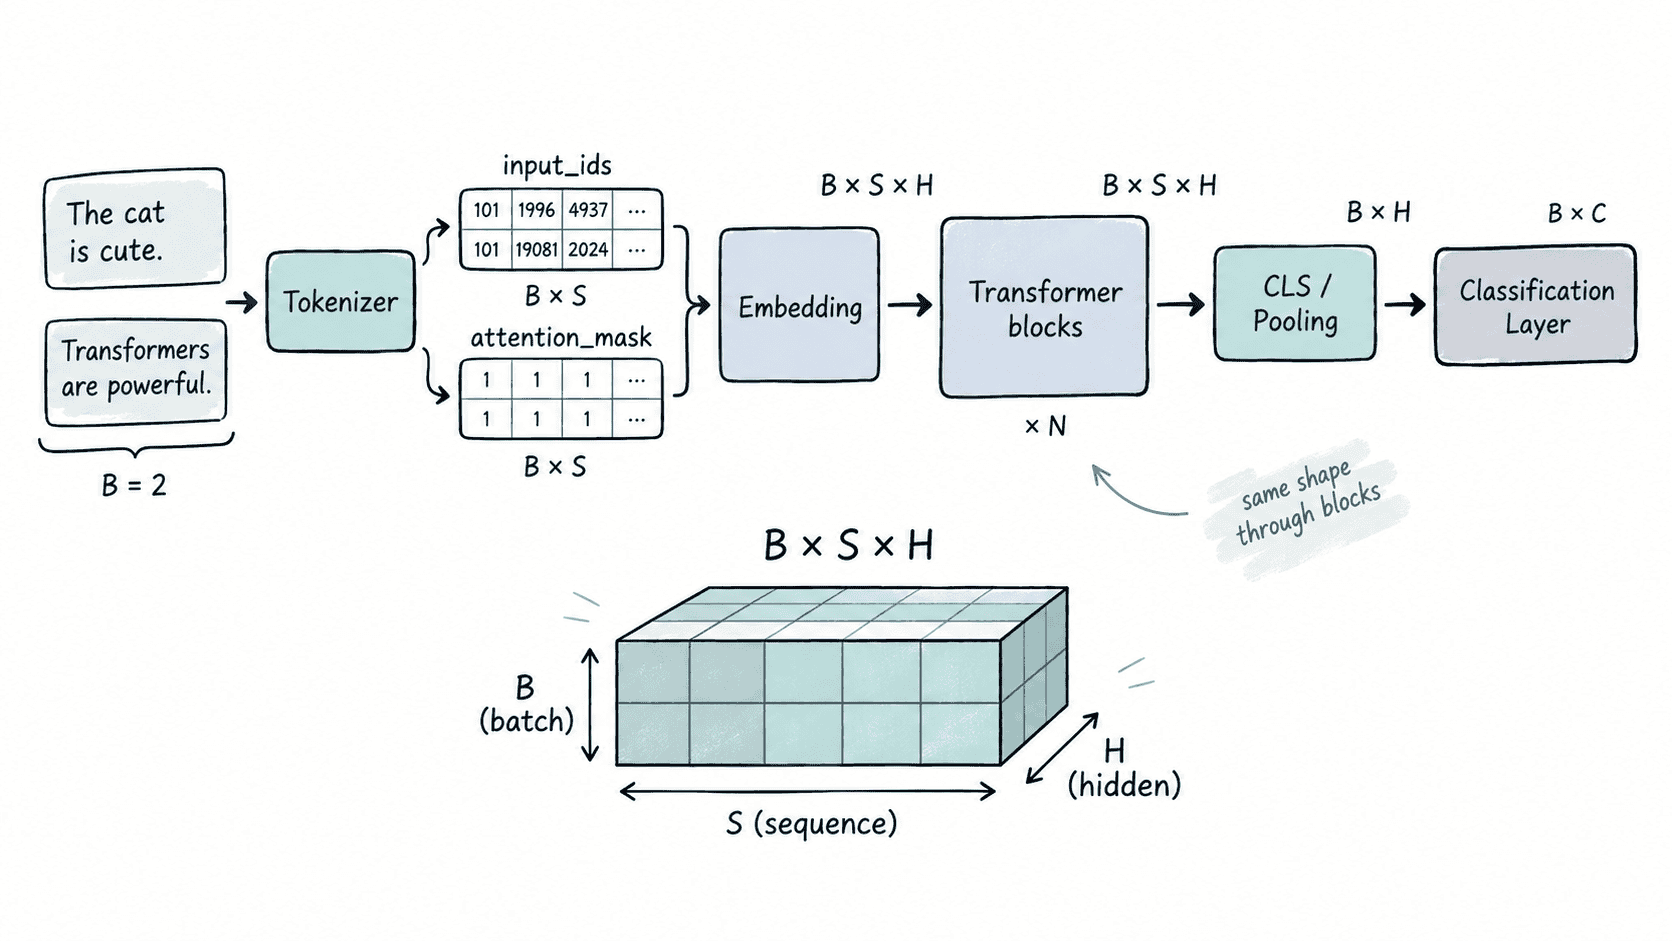
Tokenizer 输出的 input_ids 和 attention_mask 通常是二维张量,形状可以写成 (B, S)。其中 B 是 batch 中样本数量,S 是每条样本当前的 token 序列长度。
文本进入模型的 embedding 层后,每个 token 会变成一个长度为 H 的向量,于是中间表示通常成为 (B, S, H)。H 是模型隐藏维度,由模型结构决定,例如 DistilBERT Base 的隐藏维度是 768。
因此,看到一个三维张量时不要只记数字,要先把每个轴重新标成含义:第一维回答“有多少条样本”,第二维回答“每条有多少个 token 位置”,第三维回答“每个 token 用多少个数表示”。
跟踪一次真实前向计算
下面加载 DistilBERT,先检查 tokenizer 输出,再检查模型最后一层隐藏状态。使用 padding=True 后,两条文本会被补到当前批次中的最长序列。
import torch
from transformers import AutoModel, AutoTokenizer

model_name = "distilbert-base-uncased"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModel.from_pretrained(model_name)

texts = ["Hello", "Hello world"]
batch = tokenizer(
    texts,
    padding=True,
    truncation=True,
    return_tensors="pt",
)

with torch.no_grad():
    outputs = model(**batch)

hidden = outputs.last_hidden_state
print("input_ids:", batch["input_ids"].shape)
print("attention_mask:", batch["attention_mask"].shape)
print("last_hidden_state:", hidden.shape)
print("hidden_size:", model.config.hidden_size)
预期输出
input_ids: torch.Size([2, 4])
attention_mask: torch.Size([2, 4])
last_hidden_state: torch.Size([2, 4, 768])
hidden_size: 768
从结果可以直接读出完整变化:输入是 2 × 4,表示两条样本、每条四个 token 位置;模型为每个位置生成 768 维表示后,张量变成 2 × 4 × 768。模型没有凭空增加样本或 token,只是在末尾增加了 hidden 维度。
序列维度为什么经常变化
S 并不是一个始终固定的常数。改变 batch 中最长文本、max_length、padding 策略或 truncation 设置,都可能改变 sequence 长度。代码如果把 S 硬编码成某个数字,很容易在换数据后失败。
相比之下,同一个模型配置中的 H 通常固定。例如下游线性分类层若接收单个 token 的表示,它的输入特征数应该与 model.config.hidden_size 对齐,而不应该从某次运行得到的 shape 中手工写死一个猜测值。
还要区分“保留全部 token”和“压缩序列”两个阶段。完整隐藏状态是 (B, S, H);如果选择第一个 token 的表示,如 hidden[:, 0, :],sequence 这一维被索引掉,结果才会变成 (B, H)。
用断言提前发现错位
在自定义分类头、拼接额外特征或修改模型输出时,可以把关键 shape 约束写成断言,让错误停在真正出问题的位置,而不是几层运算以后才出现难懂的矩阵乘法异常。
import torch

hidden = torch.randn(2, 4, 768)
expected_hidden_size = 768

assert hidden.ndim == 3
assert hidden.shape[-1] == expected_hidden_size

pooled = hidden[:, 0, :]
classifier = torch.nn.Linear(expected_hidden_size, 3)
logits = classifier(pooled)

print("pooled:", pooled.shape)
print("logits:", logits.shape)
预期输出
pooled: torch.Size([2, 768])
logits: torch.Size([2, 3])
这里 hidden[:, 0, :] 保留 batch 和 hidden 两个维度,因此分类层接收到的是 (B, H),输出 (B, C),其中 C=3 是类别数量。如果误把 sequence 维当成 hidden 维,线性层通常会立刻暴露特征数不匹配。
shape 不匹配时从哪里查
定位时按数据流从前往后检查最省时间:先打印 tokenizer 返回的 input_ids.shape 与 attention_mask.shape,确认二者都是 (B, S);再检查模型输出是不是 (B, S, H);最后检查池化、索引、拼接或分类层是否按预期删除或新增了维度。
当某一层报矩阵乘法或广播错误时,真正的根因通常发生在更早的 transpose、squeeze、索引或拼接操作。逐层打印或断言 shape,把第一次偏离预期的位置找出来,通常比围绕最终异常信息反复修改参数更快。