
大模型原理与训练 / 系统课时
用 Auto 类加载模型组件
用 Auto 类加载模型组件
这一节不用 pipeline 的整套封装,而是用 AutoConfig、AutoTokenizer 和任务型 AutoModel 手工装配同一个检查点。重点不是记住某个 DistilBERT 类名,而是理解 Auto 类怎样根据仓库元数据选择正确架构,以及任务头究竟由谁决定。
学习目标
- 用三个 Auto 类加载配置、分词器和带分类头的模型
- 说明配置元数据如何驱动具体架构类的自动选择
- 区分基础
AutoModel与任务型AutoModelFor...的职责
Auto 类如何分工
Auto 类本身不是一种模型架构,而是一层“按元数据选具体实现”的入口。AutoConfig 先得到与检查点匹配的配置类,AutoTokenizer 选择对应 tokenizer,AutoModelForSequenceClassification 再根据配置映射到带序列分类头的具体模型类。
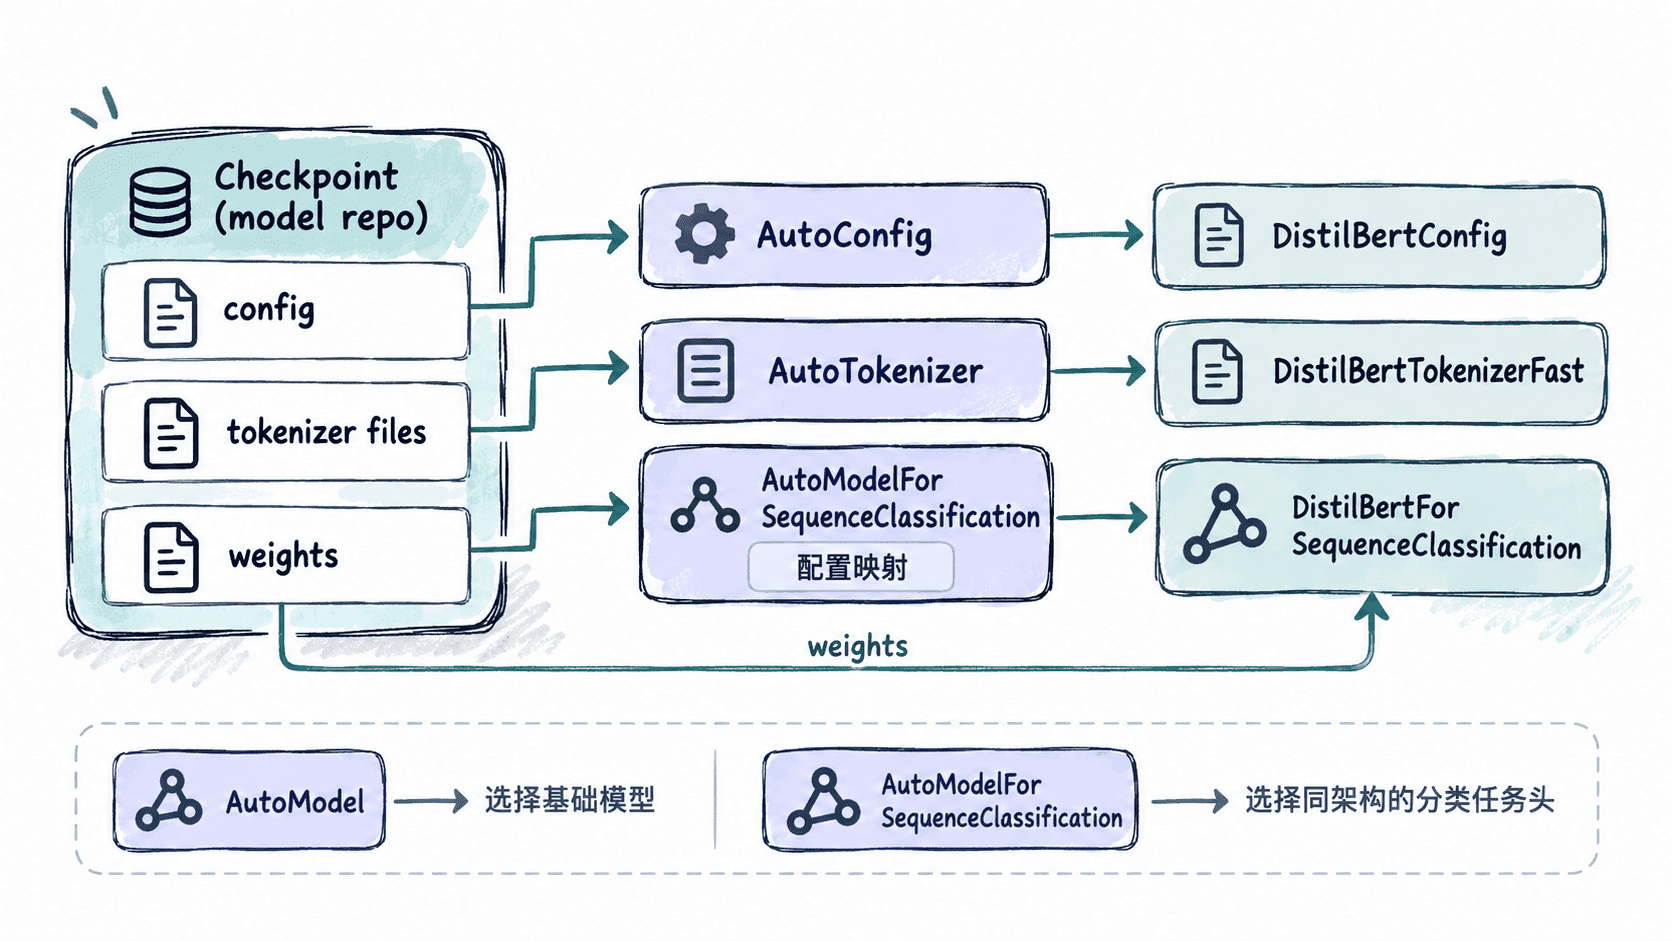
这里最容易混淆的一点是:仓库配置决定“是哪种架构”,你调用的 AutoModel 家族决定“要哪种任务头”。因此同一个检查点交给 AutoModel 和 AutoModelForSequenceClassification,得到的模型职责并不相同。
用同一检查点组装组件
下面仍使用 DistilBERT 情感分类检查点,但显式拆开配置、分词和模型前向过程。这样可以直接观察 Auto 类最终实例化出的具体 Python 类。
import torch
from transformers import AutoConfig, AutoTokenizer, AutoModelForSequenceClassification

checkpoint = "distilbert/distilbert-base-uncased-finetuned-sst-2-english"

# 三个 Auto 类读取同一 checkpoint,避免组件不匹配。
config = AutoConfig.from_pretrained(checkpoint)
tokenizer = AutoTokenizer.from_pretrained(checkpoint)
model = AutoModelForSequenceClassification.from_pretrained(
    checkpoint,
    config=config,
)
model.eval()

# tokenizer 返回 PyTorch 张量,可直接展开给模型前向方法。
inputs = tokenizer(
    "I love using Transformers for practical NLP tasks.",
    return_tensors="pt",
)

# inference_mode 避免构建训练所需的梯度图。
with torch.inference_mode():
    outputs = model(**inputs)

pred_id = outputs.logits.argmax(dim=-1).item()
label = model.config.id2label[pred_id]

print("config:", type(config).__name__)
print("tokenizer:", type(tokenizer).__name__)
print("model:", type(model).__name__)
print("batch:", inputs["input_ids"].shape[0])
print("classes:", outputs.logits.shape[-1])
print("label:", label)
预期输出:
config: DistilBertConfig
tokenizer: DistilBertTokenizerFast
model: DistilBertForSequenceClassification
batch: 1
classes: 2
label: POSITIVE
这次没有 pipeline 帮你做后处理,所以代码需要自己从 outputs.logits 取最大值索引,再通过 id2label 转成可读标签。也正因为步骤被拆开,你可以在任意位置检查张量、修改 tokenizer 参数或读取模型中间输出。
自动选择架构与任务头
AutoConfig.from_pretrained 读取检查点配置后,会实例化匹配的配置类。任务型 AutoModel 再依据这个配置类,从内部映射中找到对应模型实现,因此调用方不需要硬编码 DistilBertForSequenceClassification。
但任务头不是仅靠仓库名“猜”出来的。调用 AutoModelForSequenceClassification 已经明确要求序列分类头;如果改用 AutoModel,得到的是基础模型输出,通常是 hidden states,而不是直接用于分类的 logits。做生成任务时则应选择与模型类型匹配的 AutoModelForCausalLM 或 AutoModelForSeq2SeqLM。
加载时要守住的边界
同一个 checkpoint 的 config、tokenizer 与 weights 应保持配套,这是最稳妥的默认做法。仓库也可以替换成本地 save_pretrained 目录,Auto 类仍按同样机制读取元数据。
遇到依赖仓库自定义 Python 实现的模型时,文档或模型卡可能要求 trust_remote_code=True。这个开关会允许加载远端仓库提供的代码,因此只应对可信来源使用,并在可复现要求高的环境中固定仓库 revision。对 Transformers 已内置支持的常见架构,不要为了“保险”随意开启它。
当你只想快速得到最终标签时,pipeline 更省事;当你需要控制 tokenizer 参数、张量设备、任务头或前向结果时,Auto 类提供了更清晰的控制边界。