
大模型原理与训练 / 系统课时
区分基础模型与任务头
区分基础模型与任务头
选择模型类时,真正要对齐的是任务目标与输出张量,而不是仓库名称。基础模型只负责生成隐藏表示,分类模型和因果语言模型则在骨干网络上增加任务头;本篇用最小可运行示例直接比较三者的输出形状。
学习目标
- 解释基础模型、骨干网络与任务头之间的关系。
- 根据特征提取、分类和文本生成目标选择正确的 AutoModel 类。
- 通过输出张量形状验证模型类是否与任务匹配。
先把骨干网络和任务头分开
Transformer 的骨干网络负责把 token 序列变成上下文化隐藏向量。AutoModel 通常只实例化这部分,因此核心输出是 last_hidden_state,形状可写成 (B, L, H):批大小、序列长度和隐藏维度。
任务头是在骨干输出之上增加的预测层。序列分类头把整段文本映射为类别分数 (B, C);因果语言模型头则为每个位置预测词表中的下一个 token,输出 (B, L, V)。这里的 C 是类别数,V 是词表大小。
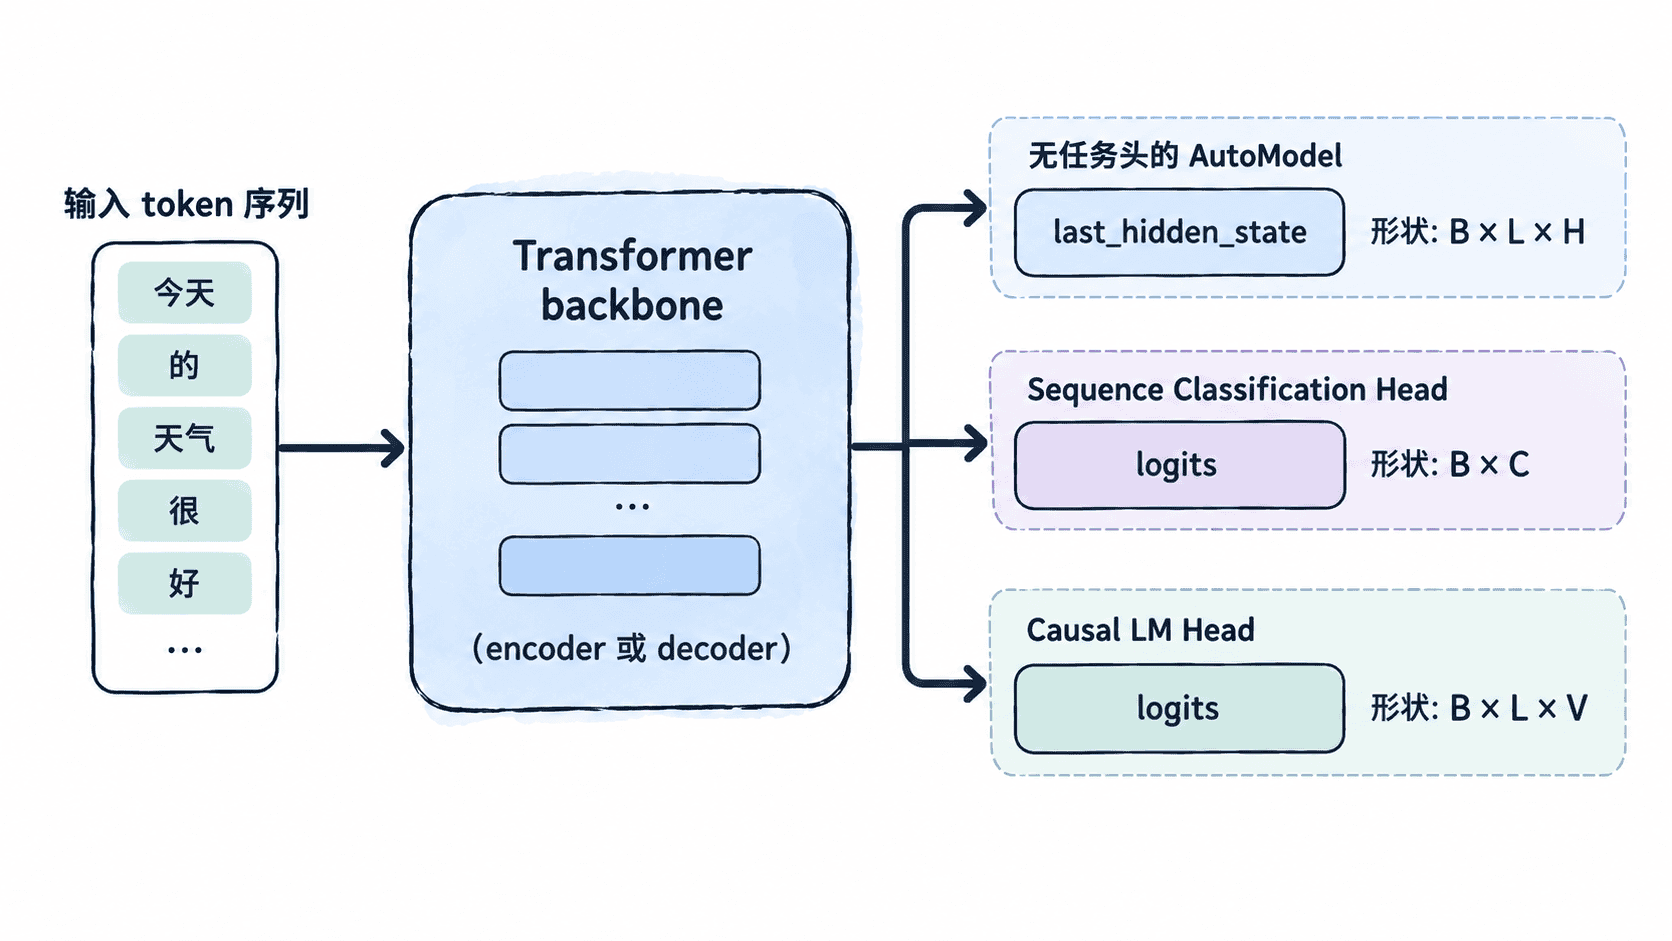
模型仓库中的 checkpoint 是一组已经训练好的参数,模型类则决定用什么结构承载这些参数。即使两个类读取同一个配置,它们也可能因为任务头不同而产生完全不同的输出接口。若 checkpoint 没有对应任务头的已训练权重,新任务头可能被随机初始化,因此加载日志和模型卡仍需要检查。
三类模型的输出差异
| 模型类 | 主要输出 | 典型形状 | 适合任务 |
|---|---|---|---|
AutoModel |
last_hidden_state |
(B, L, H) |
特征提取、向量池化、自定义下游头 |
AutoModelForSequenceClassification |
logits |
(B, C) |
文本分类、回归 |
AutoModelForCausalLM |
logits |
(B, L, V) |
自回归生成、下一个 token 预测 |
这里的 logits 是 softmax 之前的原始分数。基础模型没有通用的 logits 概念,因为它还不知道你希望把隐藏表示解释成类别、词表概率还是其他任务输出。
用最小模型验证输出形状
下面用随机初始化的小型配置验证结构,不访问 Hub,也不依赖具体 checkpoint。随机权重没有预测意义,但非常适合观察不同模型类的接口。
import torch
from transformers import (
    AutoModel,
    AutoModelForCausalLM,
    AutoModelForSequenceClassification,
    BertConfig,
    GPT2Config,
)

# 用很小的 BERT 配置分别构造裸骨干与分类模型。
bert_config = BertConfig(
    vocab_size=100,
    hidden_size=16,
    num_hidden_layers=2,
    num_attention_heads=2,
    intermediate_size=32,
    num_labels=3,
)
base_model = AutoModel.from_config(bert_config)
classifier = AutoModelForSequenceClassification.from_config(bert_config)

# 因果语言模型需要支持自回归建模的架构,这里使用一个极小 GPT-2 配置。
gpt_config = GPT2Config(vocab_size=100, n_embd=16, n_layer=2, n_head=2)
causal_lm = AutoModelForCausalLM.from_config(gpt_config)

# 两个样本、每个样本四个 token,便于直接比较输出形状。
input_ids = torch.tensor([[1, 5, 9, 2], [1, 8, 3, 2]])
attention_mask = torch.ones_like(input_ids)

with torch.no_grad():
    base_out = base_model(input_ids=input_ids, attention_mask=attention_mask)
    cls_out = classifier(input_ids=input_ids, attention_mask=attention_mask)
    lm_out = causal_lm(input_ids=input_ids)

print("base:", tuple(base_out.last_hidden_state.shape))
print("classifier:", tuple(cls_out.logits.shape))
print("causal_lm:", tuple(lm_out.logits.shape))
预期输出
base: (2, 4, 16)
classifier: (2, 3)
causal_lm: (2, 4, 100)
同样的批大小和序列长度经过不同任务头后,最后一维已经变成完全不同的语义:隐藏维度、类别数或词表大小。看到这个差异,就能判断后续代码应该读取隐藏状态还是预测分数。
按任务目标选择模型类
需要句向量、token 表示或准备自己编写任务头时,优先从 AutoModel 开始。要直接完成整段文本分类,应使用 AutoModelForSequenceClassification;要做逐 token 分类、问答、掩码预测或序列到序列生成,则分别选择对应的 AutoModelFor... 任务类。
最可靠的判断顺序是先确定任务需要什么输出,再选择对应模型类,最后确认 checkpoint 的架构与任务头权重是否兼容。