
大模型原理与训练 / 系统课时
用采样参数控制多样性
用采样参数控制多样性
采样参数真正要解决的不是“越随机越好”,而是在连贯性、变化度和重复之间找到可复现的平衡。本节用同一提示词对照 temperature、top_k、top_p 与 repetition_penalty,建立一套能直接迁移到生成任务的调参方法。
学习目标
- 解释四个参数分别改变概率分布的哪个环节
- 用同一提示词对照不同采样组合并观察输出差异
- 按“先控制候选集,再处理重复”的顺序定位常见生成问题
四个参数控制的是不同环节
只有开启 do_sample=True,温度和概率截断才真正参与随机采样。temperature 会重新缩放 logits:小于 1 时概率更集中,大于 1 时分布更平;top_k 只保留概率最高的 k 个候选;top_p 保留累计概率达到阈值的最小候选集合;repetition_penalty 则对已经出现过的 token 调整分数,值大于 1 通常用于减轻重复。当前 Transformers 的生成配置仍提供这些参数。([Hugging Face][1])
把它们理解成一条“先修正分数,再收窄候选,再抽样”的链路更容易调试。top_k 是固定数量的硬上限,top_p 会随当前概率分布自动改变候选数量;两者可以同时使用,此时候选集合会受到双重约束。
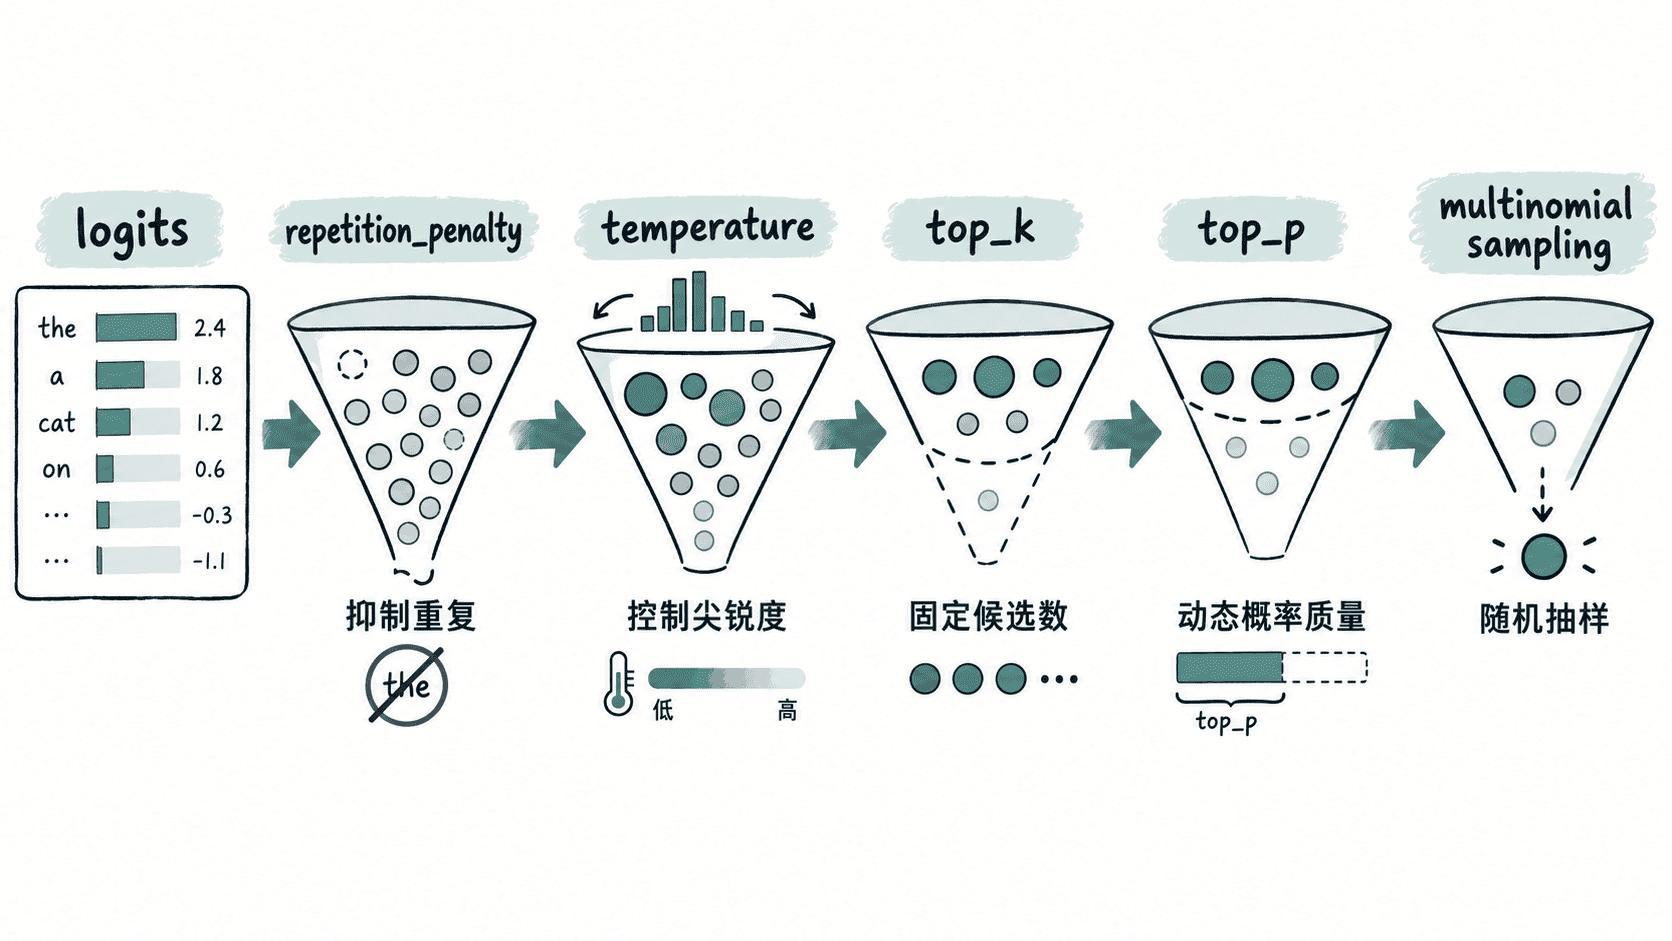
用同一提示词做对照实验
下面使用小型 GPT-2 模型和同一个随机种子。每组都显式设置参数,避免模型自带的 generation_config 让比较失去意义。第一次运行会从 Hugging Face Hub 下载模型;后续会使用本地缓存。
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed

MODEL_ID = "openai-community/gpt2"
prompt = "A useful way to learn machine learning is"

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(MODEL_ID)
model.eval()

inputs = tokenizer(prompt, return_tensors="pt")
profiles = {
    "stable": {
        "temperature": 0.7,
        "top_k": 30,
        "top_p": 0.85,
        "repetition_penalty": 1.05,
    },
    "balanced": {
        "temperature": 0.9,
        "top_k": 50,
        "top_p": 0.95,
        "repetition_penalty": 1.10,
    },
    "creative": {
        "temperature": 1.2,
        "top_k": 100,
        "top_p": 0.98,
        "repetition_penalty": 1.05,
    },
}

for name, config in profiles.items():
    # 每组重置同一随机种子,使主要差异来自参数组合。
    set_seed(42)
    output = model.generate(
        **inputs,
        do_sample=True,
        max_new_tokens=40,
        pad_token_id=tokenizer.eos_token_id,
        **config,
    )
    new_tokens = output[0, inputs["input_ids"].shape[1]:]
    text = tokenizer.decode(new_tokens, skip_special_tokens=True)
    print(f"{name}: {text}")
预期结果
stable: 输出一段候选范围较窄、措辞通常更集中的续写
balanced: 输出一段变化度更高但仍较连贯的续写
creative: 输出一段候选更分散、偶尔更跳跃的续写
采样生成本身含随机性,因此具体句子可能随硬件、PyTorch 或 Transformers 版本变化;真正要比较的是相对趋势,而不是逐字匹配示例文本。若三组结果差异不明显,可以把 max_new_tokens 提高后再次观察,但一次只改一个参数更容易归因。
按症状调整而不是盲目叠参数
输出太保守时,先轻微提高 temperature 或 top_p,不要同时把所有阈值放宽。输出开始跑题时,优先降低 temperature,再收紧 top_p;如果模型总在几个词之间打转,才提高 repetition_penalty。惩罚过强也会伤害必须重复的专有名词、代码标识符和固定短语。
top_k 与 top_p 不存在通用“最佳值”。更可靠的做法是固定提示词与随机种子,保存每次参数组合和输出,再围绕一个维度小步搜索。这样看到质量变化时,才能知道是哪一个控制量造成的。
识别参数失效的边界
如果 do_sample=False,生成会走确定性解码路径,此时用温度或概率截断期待“更多随机性”是错误方向。另一个常见误区是把 repetition_penalty 当作语义去重器:它作用在 token 分数上,只能降低重复倾向,不能保证句子级别不重复。
调参时先确认目标:需要事实性、格式稳定的答案,就让分布更集中;需要头脑风暴或多候选表达,再逐步放宽温度和候选集合。四个参数组合的价值在于可控,而不是把随机性推到最大。