
大模型原理与训练 / 系统课时
分析过拟合与欠拟合曲线
分析过拟合与欠拟合曲线
训练结束后只看最后一个指标,很容易把“继续训练会更好”和“已经开始过拟合”混为一谈。本节把 train loss、eval loss 与任务指标放到同一时间轴上,判断训练状态,并据此选择更合理的轮数与正则策略。
学习目标
- 联合 train loss、eval loss 和任务指标识别过拟合、欠拟合与训练不足
- 从 Trainer 日志中定位最佳 epoch 或 checkpoint
- 把曲线诊断转换为继续训练、提前停止或加强正则的决策
先把三条信号放在一起
train loss 反映模型对训练集的拟合程度,eval loss 反映验证集上的泛化误差,F1、accuracy、BLEU 等任务指标则对应最终验收目标。只看其中一条曲线,结论往往不可靠。
分析时必须让三类信号来自同一个验证集和相同评估节奏。若训练按 step 记录而验证按 epoch 记录,应先对齐时间轴;不要拿不同 checkpoint、不同数据切分的点硬连成一条曲线。
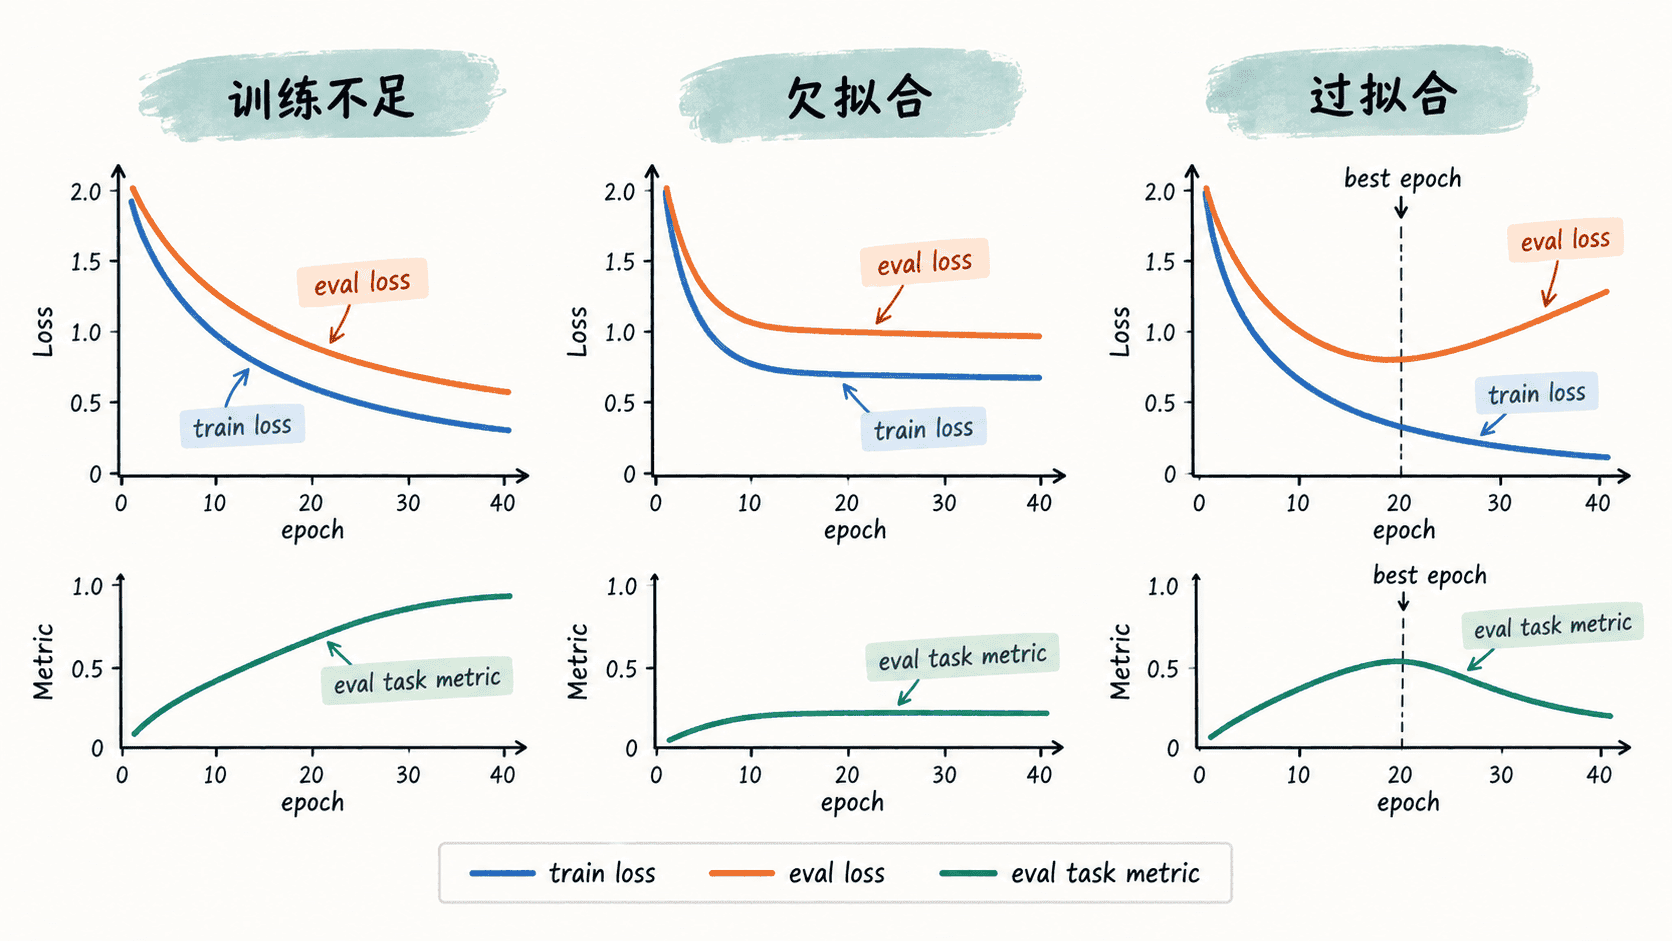
用曲线形状判断训练状态
训练不足的关键是趋势还没有结束:train loss 与 eval loss 都在明显下降,任务指标仍持续上升。这时继续训练通常有价值,贸然加大正则反而可能让模型更难收敛。
欠拟合则表现为训练集本身也学不好:train loss 较高并较早进入平台,eval loss 同样偏高,任务指标长期处在低位。此时单纯增加 epoch 往往收益有限,应检查学习率、输入预处理、模型容量或任务设定。
过拟合常见于 train loss 继续下降,而 eval loss 已经过最低点后回升;与此同时任务指标达到峰值后停滞或下降。最佳模型通常出现在验证指标峰值附近,而不是训练结束的最后一步。
健康收敛时,train loss 与 eval loss 都逐步趋稳,两者差距没有持续扩大,任务指标也进入稳定平台。此时再训练很多轮通常只会增加成本。
从 Trainer 日志找最佳轮次
当 logging_strategy="epoch" 且 eval_strategy="epoch" 时,trainer.state.log_history 会同时包含训练日志和评估日志。下面用同样的数据结构演示如何合并每个 epoch 的记录,并判断最佳 F1 之后是否出现过拟合。
log_history = [
    {"loss": 0.80, "epoch": 1.0},
    {"eval_loss": 0.74, "eval_f1": 0.69, "epoch": 1.0},
    {"loss": 0.58, "epoch": 2.0},
    {"eval_loss": 0.57, "eval_f1": 0.76, "epoch": 2.0},
    {"loss": 0.45, "epoch": 3.0},
    {"eval_loss": 0.51, "eval_f1": 0.80, "epoch": 3.0},
    {"loss": 0.34, "epoch": 4.0},
    {"eval_loss": 0.55, "eval_f1": 0.79, "epoch": 4.0},
    {"loss": 0.26, "epoch": 5.0},
    {"eval_loss": 0.63, "eval_f1": 0.76, "epoch": 5.0},
]

# Trainer 的训练日志和评估日志通常是分开的,先按 epoch 合并。
by_epoch = {}
for row in log_history:
    epoch = row.get("epoch")
    if epoch is None:
        continue
    current = by_epoch.setdefault(epoch, {"epoch": epoch})
    if "loss" in row:
        current["train_loss"] = row["loss"]
    if "eval_loss" in row:
        current["eval_loss"] = row["eval_loss"]
        current["eval_f1"] = row["eval_f1"]

history = [
    row for row in by_epoch.values()
    if {"train_loss", "eval_loss", "eval_f1"} <= row.keys()
]
best = max(history, key=lambda row: row["eval_f1"])
later = [row for row in history if row["epoch"] > best["epoch"]]

# 最佳点之后训练损失更低、验证损失却更高,是典型过拟合信号。
overfit = bool(later) and all(
    row["train_loss"] < best["train_loss"]
    and row["eval_loss"] > best["eval_loss"]
    for row in later
)

print(f"best_epoch={best['epoch']:.0f}")
print(f"best_eval_f1={best['eval_f1']:.2f}")
print(
    f"diagnosis=overfitting_after_epoch_{best['epoch']:.0f}"
    if overfit else "diagnosis=no_clear_overfitting"
)
预期输出
best_epoch=3
best_eval_f1=0.80
diagnosis=overfitting_after_epoch_3
真实训练中可把示例列表替换为 trainer.state.log_history。如果按 step 记录,则应改用 step 对齐,而不是强行归并到整数 epoch。
把诊断转换成训练决策
如果最佳指标稳定出现在中间 checkpoint,优先把训练轮数收敛到该区域,并让 load_best_model_at_end=True 配合 metric_for_best_model 保存真正最优的模型。使用按 step 的保存与评估时,保存节奏要与评估节奏匹配,避免最佳评估点根本没有对应 checkpoint。
确认过拟合后,再考虑加强 weight_decay、提高 dropout、增加数据或使用任务合适的数据增强;这些措施解决的是泛化差距,不是“训练得不够久”。如果 train loss 与 eval loss 都高且早早停滞,应先处理欠拟合,而不是继续加正则。
曲线分析的核心不是给每条线贴标签,而是判断“继续优化训练集是否还会改善验证目标”。一旦这两个方向开始分离,就应该把注意力从继续训练转向 checkpoint 选择和泛化策略。