
大模型原理与训练 / 系统课时
实现批量生成与流式输出
实现批量生成与流式输出
生成服务常同时追求两件事:批量请求要提高设备吞吐,交互请求又要尽快看到首段文本。本篇把这两条路径拆开实现:批量生成使用左填充并按行回切结果,单请求流式生成使用 TextIteratorStreamer 边生成边消费。
学习目标
- 为 decoder-only 聊天模型构造左填充批量输入并正确切出新增 token
- 用
TextIteratorStreamer实现单请求增量输出 - 根据吞吐量与交互延迟选择批量或流式路径
批量生成先把输入右端对齐
decoder-only 模型在每个解码步都从序列末端继续预测。批量中各请求长度不同,因此通常把 padding_side 设为 left,让每一行最后一个有效 token 都位于右端;attention_mask 再负责屏蔽左侧填充。没有独立 pad token 的模型可按其模型说明选择兼容的填充值,常见做法是复用 EOS。
生成结果的每一行仍与输入批次同索引对应。对已经填充成同一宽度的输入,切分新增部分时应使用整个批次的 input_ids.shape[1],而不是分别拿每条原始文本长度去切 tensor,否则很容易把提示词残片混进答案。
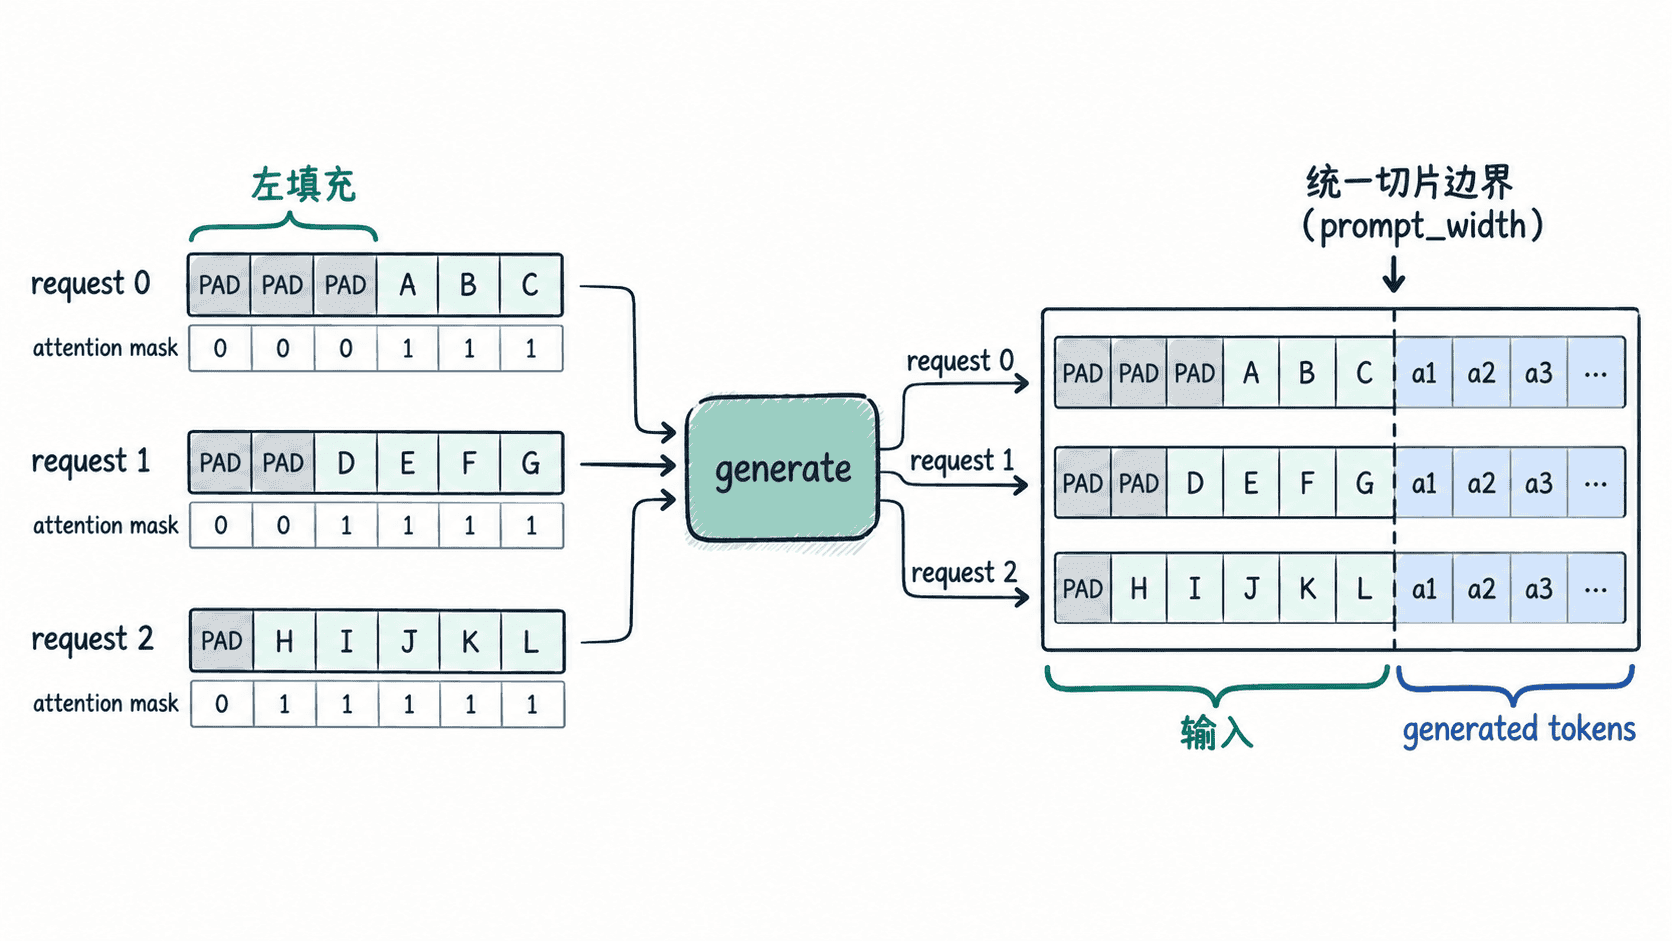
同一脚本实现批量与流式两条路径
下面的脚本使用同一个小型 instruct 模型。batch_generate() 一次处理两个会话;stream_one() 单独处理一个会话,并把生成放在线程中,让主线程可以持续消费 streamer 的文本片段。
from threading import Thread

import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    TextIteratorStreamer,
)

MODEL_ID = "HuggingFaceTB/SmolLM2-135M-Instruct"
device = "cuda" if torch.cuda.is_available() else "cpu"

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
tokenizer.padding_side = "left"
if tokenizer.pad_token_id is None:
    tokenizer.pad_token = tokenizer.eos_token

model = AutoModelForCausalLM.from_pretrained(MODEL_ID).to(device)
model.eval()

chats = [
    [{"role": "user", "content": "只回答一个数字:1+1 等于多少?"}],
    [{"role": "user", "content": "只回答一个数字:3+4 等于多少?"}],
]

def batch_generate(conversations):
    inputs = tokenizer.apply_chat_template(
        conversations,
        tokenize=True,
        add_generation_prompt=True,
        padding=True,
        return_dict=True,
        return_tensors="pt",
    ).to(device)

    prompt_width = inputs["input_ids"].shape[1]
    with torch.inference_mode():
        output_ids = model.generate(
            **inputs,
            max_new_tokens=8,
            do_sample=False,
            pad_token_id=tokenizer.pad_token_id,
        )

    new_ids = output_ids[:, prompt_width:]
    return tokenizer.batch_decode(new_ids, skip_special_tokens=True)

def stream_one(conversation):
    inputs = tokenizer.apply_chat_template(
        conversation,
        tokenize=True,
        add_generation_prompt=True,
        return_dict=True,
        return_tensors="pt",
    ).to(device)

    streamer = TextIteratorStreamer(
        tokenizer,
        skip_prompt=True,
        skip_special_tokens=True,
        timeout=30.0,
    )
    generation_kwargs = {
        **inputs,
        "streamer": streamer,
        "max_new_tokens": 24,
        "do_sample": False,
        "pad_token_id": tokenizer.pad_token_id,
    }

    worker = Thread(target=model.generate, kwargs=generation_kwargs)
    worker.start()
    for piece in streamer:
        print(piece, end="", flush=True)
    worker.join()
    print()

answers = batch_generate(chats)
for index, answer in enumerate(answers):
    print(f"batch[{index}]: {answer.strip()}")

print("stream:", end=" ")
stream_one(chats[0])
预期结果
batch[0]: <GENERATED_TEXT_0>
batch[1]: <GENERATED_TEXT_1>
stream: <GENERATED_TEXT_0>
其中 <GENERATED_TEXT_0> 和 <GENERATED_TEXT_1> 是实际模型生成文本;示例使用贪心解码以减少随机性,但模型仓库后续更新权重或生成配置时,具体内容仍可能变化。稳定不变的是批次行与请求索引的对应关系,以及流式路径会逐片段打印单个请求的回复。
Streamer 改善的是可见延迟
TextIteratorStreamer 会把可解码文本放入队列,调用方可以一边迭代一边把片段推给终端、WebSocket 或 SSE。它并不会让模型计算本身更快;收益在于用户不必等整段生成完成后才看到第一个可读片段。
生成必须放到另一个线程,是因为 model.generate() 是阻塞调用。如果主线程先同步等待它返回,再去遍历 streamer,就失去了流式效果。设置 timeout 还能避免生成线程异常时消费者永久阻塞。
吞吐与响应速度不要混成一个指标
批量生成让多个序列共享每个解码步的模型计算,更容易提高 GPU 利用率和单位时间完成的 token 数,但请求要等待凑批,而且同一批中的长序列会占用更多解码步。它适合离线任务、队列消费和允许短暂排队的接口。
流式输出强调交互体验,通常围绕单请求尽快暴露首个文本片段。它适合聊天、代码补全和长回答界面。生产系统常用微批调度把两者结合:后端动态合批提高吞吐,前端仍按请求分别接收增量 token。
无论选择哪条路径,都应保留请求索引或请求 ID,并只解码 prompt_width 之后的新增 token。批量负责计算效率,streamer 负责结果交付方式;把这两层职责分开,才能同时避免错配答案和误判性能瓶颈。