
大模型原理与训练 / 系统课时
完成可复现的模型交付
完成可复现的模型交付
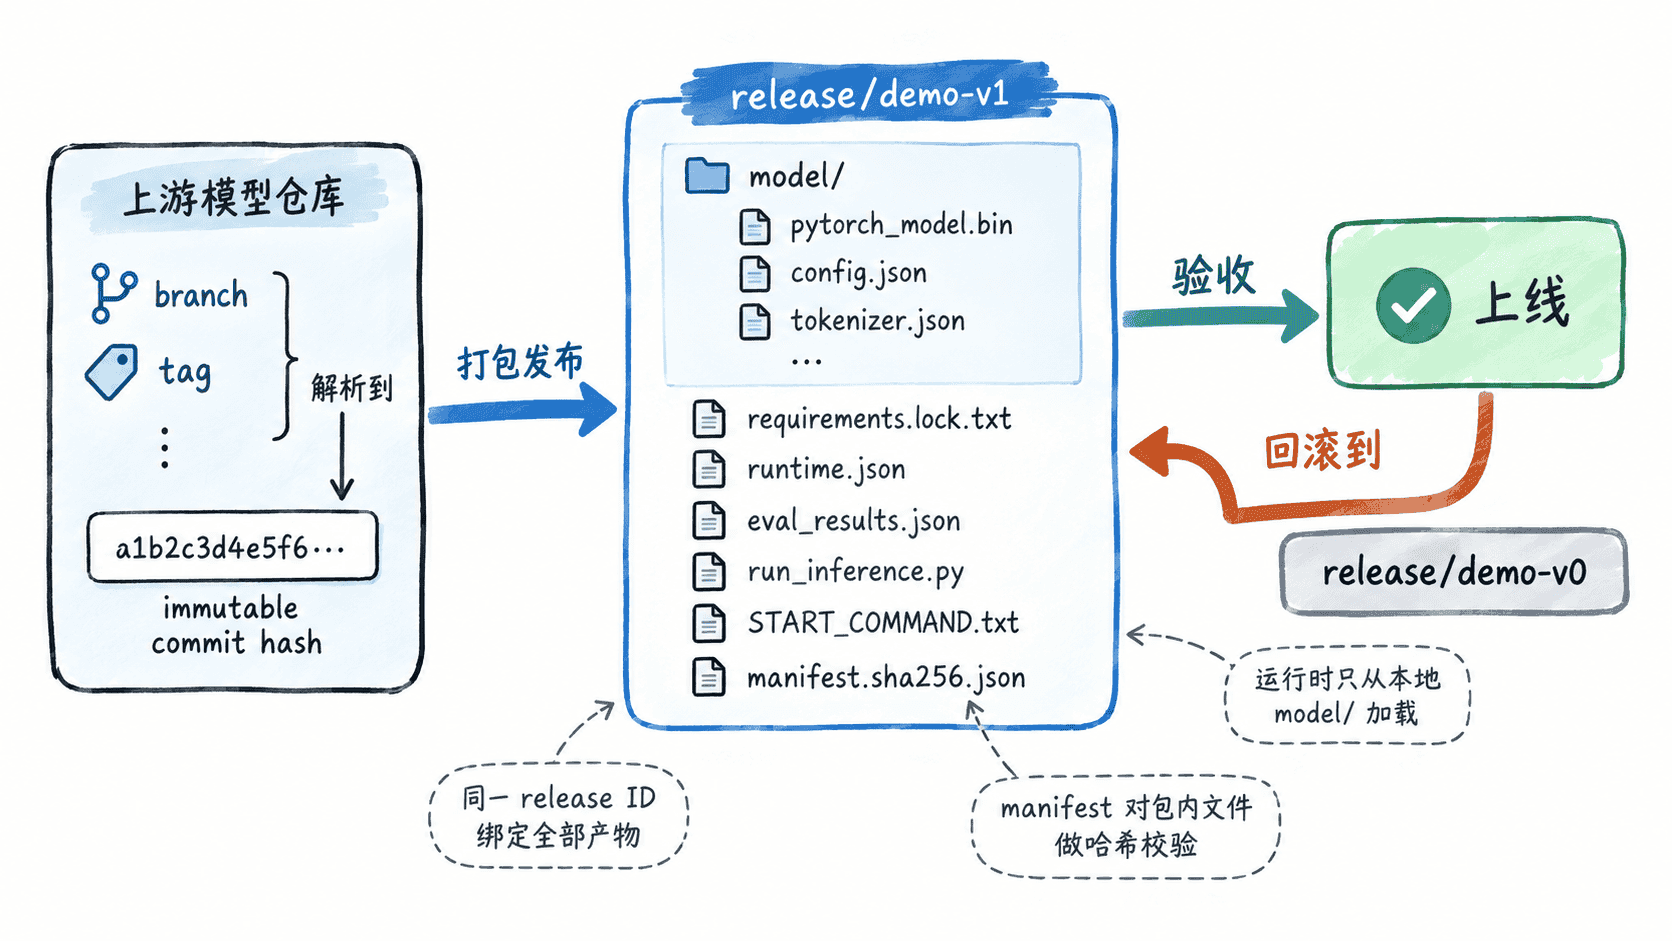
模型“能在我的机器上跑”不等于已经可交付。一个可复现版本必须把权重、Tokenizer、配置、依赖、评估证据和启动方式绑定到同一发布号,并记录不可变的上游修订版本。本篇用一个打包脚本生成可校验、可重建、可回滚的发布目录。
学习目标
- 能定义一个完整的模型交付包及其版本边界
- 能锁定上游模型修订并保存本地可离线加载的产物
- 能用哈希清单、评估结果和启动命令完成交付验收
交付物不是一个权重目录
真正的发布单元至少要回答六个问题:加载哪一份权重、使用哪一套 Tokenizer、配置是什么、运行环境依赖什么、这个版本经过什么评估、用什么命令启动。任意一项留在个人机器或聊天记录里,下一位接手者就无法证明自己重建的是同一个版本。
上游模型也不能只记录 main。分支会继续变化,因此发布时应解析并保存不可变 commit hash;本地保存后,再让运行入口只读取交付目录,不在启动阶段偷偷访问网络。
用脚本生成版本化发布包
下面示例使用一个公开文本分类模型演示完整交付链路。脚本先把 main 解析成具体 commit hash,再保存模型与 Tokenizer,执行两条固定冒烟评估,记录 Python 与关键库版本,冻结当前环境依赖,生成本地推理入口、启动命令和 SHA-256 清单。正式项目应把两条示例样本替换成自己的固定评估集。
import hashlib
import json
import platform
import subprocess
import sys
from pathlib import Path

import torch
from huggingface_hub import HfApi
from transformers import AutoModelForSequenceClassification, AutoTokenizer

MODEL_ID = "distilbert/distilbert-base-uncased-finetuned-sst-2-english"
REQUESTED_REVISION = "main"
RELEASE_ID = "demo-v1"
RELEASE_DIR = Path("releases") / RELEASE_ID
MODEL_DIR = RELEASE_DIR / "model"

def write_json(path: Path, data: object) -> None:
    path.write_text(
        json.dumps(data, ensure_ascii=False, indent=2) + "\n",
        encoding="utf-8",
    )

def sha256(path: Path) -> str:
    digest = hashlib.sha256()
    with path.open("rb") as file:
        for chunk in iter(lambda: file.read(1024 * 1024), b""):
            digest.update(chunk)
    return digest.hexdigest()

def main() -> None:
    if RELEASE_DIR.exists():
        raise FileExistsError(f"release already exists: {RELEASE_DIR}")
    MODEL_DIR.mkdir(parents=True)
    source_revision = HfApi().model_info(
        MODEL_ID,
        revision=REQUESTED_REVISION,
    ).sha
    tokenizer = AutoTokenizer.from_pretrained(
        MODEL_ID,
        revision=source_revision,
    )
    model = AutoModelForSequenceClassification.from_pretrained(
        MODEL_ID,
        revision=source_revision,
    )
    tokenizer.save_pretrained(MODEL_DIR)
    model.save_pretrained(MODEL_DIR)

    cases = [
        {"text": "I loved this movie.", "expected": "POSITIVE"},
        {"text": "I hated this movie.", "expected": "NEGATIVE"},
    ]
    results = []
    model.eval()
    for case in cases:
        encoded = tokenizer(case["text"], return_tensors="pt", truncation=True)
        with torch.inference_mode():
            logits = model(**encoded).logits
        label_id = int(logits.argmax(dim=-1).item())
        predicted = str(model.config.id2label[label_id]).upper()
        results.append({**case, "predicted": predicted})
    accuracy = sum(
        item["predicted"] == item["expected"] for item in results
    ) / len(results)
    write_json(
        RELEASE_DIR / "eval_results.json",
        {"cases": results, "accuracy": accuracy},
    )
    write_json(
        RELEASE_DIR / "runtime.json",
        {
            "python": platform.python_version(),
            "platform": platform.platform(),
            "torch": torch.__version__,
            "model_id": MODEL_ID,
            "source_revision": source_revision,
            "release_id": RELEASE_ID,
        },
    )

    freeze = subprocess.run(
        [sys.executable, "-m", "pip", "freeze"],
        check=True,
        capture_output=True,
        text=True,
    ).stdout
    (RELEASE_DIR / "requirements.lock.txt").write_text(
        freeze,
        encoding="utf-8",
    )

    runner = '''import json
import sys
from pathlib import Path
import torch
from transformers import AutoModelForSequenceClassification, AutoTokenizer

model_dir = Path(__file__).parent / "model"
tokenizer = AutoTokenizer.from_pretrained(model_dir, local_files_only=True)
model = AutoModelForSequenceClassification.from_pretrained(
    model_dir,
    local_files_only=True,
)
text = sys.argv[1]
encoded = tokenizer(text, return_tensors="pt", truncation=True)
with torch.inference_mode():
    logits = model(**encoded).logits
probs = torch.softmax(logits, dim=-1)[0]
label_id = int(probs.argmax().item())
print(json.dumps({
    "label": model.config.id2label[label_id],
    "score": round(float(probs[label_id]), 6),
}))
'''
    (RELEASE_DIR / "run_inference.py").write_text(runner, encoding="utf-8")
    (RELEASE_DIR / "START_COMMAND.txt").write_text(
        'python run_inference.py "I loved this movie."\n',
        encoding="utf-8",
    )

    files = sorted(
        path for path in RELEASE_DIR.rglob("*")
        if path.is_file() and path.name != "manifest.sha256.json"
    )
    manifest = {
        str(path.relative_to(RELEASE_DIR)): sha256(path)
        for path in files
    }
    write_json(RELEASE_DIR / "manifest.sha256.json", manifest)
    print(f"release={RELEASE_DIR}")
    print(f"source_revision={source_revision}")
    print(f"files={len(manifest)}")
    print(f"eval_accuracy={accuracy:.2f}")

if __name__ == "__main__":
    main()
预期输出
release=releases/demo-v1
source_revision=<COMMIT_HASH>
files=<N>
eval_accuracy=<VALUE><COMMIT_HASH>、文件数量和评估值以实际下载到的修订版本与环境为准。脚本如果发现 releases/demo-v1 已存在会直接失败,避免同一个发布号被静默覆盖;要发布新版本,应更换 RELEASE_ID,而不是删除证据后重打同名包。
用清单验证可重建性
打包完成后,先检查 manifest.sha256.json 是否覆盖除清单自身之外的所有文件,再从一个干净环境安装 requirements.lock.txt 中的依赖。启动入口必须只读取 release/model,因此即使 Hub 不可访问,也不应重新下载权重或 Tokenizer;如果离线启动失败,就说明交付包仍依赖了外部状态。
eval_results.json 是发布门槛的一部分,不是装饰文件。生产项目应记录固定数据集版本、指标名称、阈值与评估脚本版本,并在 CI 中拒绝低于阈值的发布。runtime.json 则用来回答“这个包在哪种 Python、操作系统和关键库版本下验证过”。
让发布可回滚而不是可覆盖
发布目录应采用不可变策略:demo-v1 一旦通过验收就不再原地修改,后续变更生成 demo-v2。上线系统只切换“当前激活版本”指针或部署配置;回滚时重新指向上一份已验收目录,而不是临时重新下载旧模型。
回滚还必须同时回退 Tokenizer、配置、依赖和启动入口。只把权重换回旧文件,却继续使用新 Tokenizer 或新依赖,依然可能得到不同结果。把这些内容绑定在同一发布号下,配合不可变上游 commit 与文件哈希,才能让“可重建”和“可回滚”成为可以验证的工程属性。