
大模型原理与训练 / 系统课时
用 pipeline 跑通首个任务
用 pipeline 跑通首个任务
这一节用一个情感分类模型完成从文本输入到标签输出的完整推理,并把 task、模型仓库、分词器和 device 四个关键参数对应到实际执行环节。跑完后,你不只会调用 pipeline,也能判断它替你封装了什么。
学习目标
- 用
pipeline完成一次可复现的文本分类推理 - 解释任务名、模型、分词器与设备在推理链路中的职责
- 根据输出和组件类型判断模型是否按预期加载
pipeline 把哪些步骤包起来
pipeline 是 Transformers 的高层推理入口。对文本分类来说,它把“文本预处理 → 张量送入模型 → 得到 logits → 转成标签和分数”连成一次调用。你仍然在使用具体的 tokenizer 和模型,只是不必手工编排每一步。
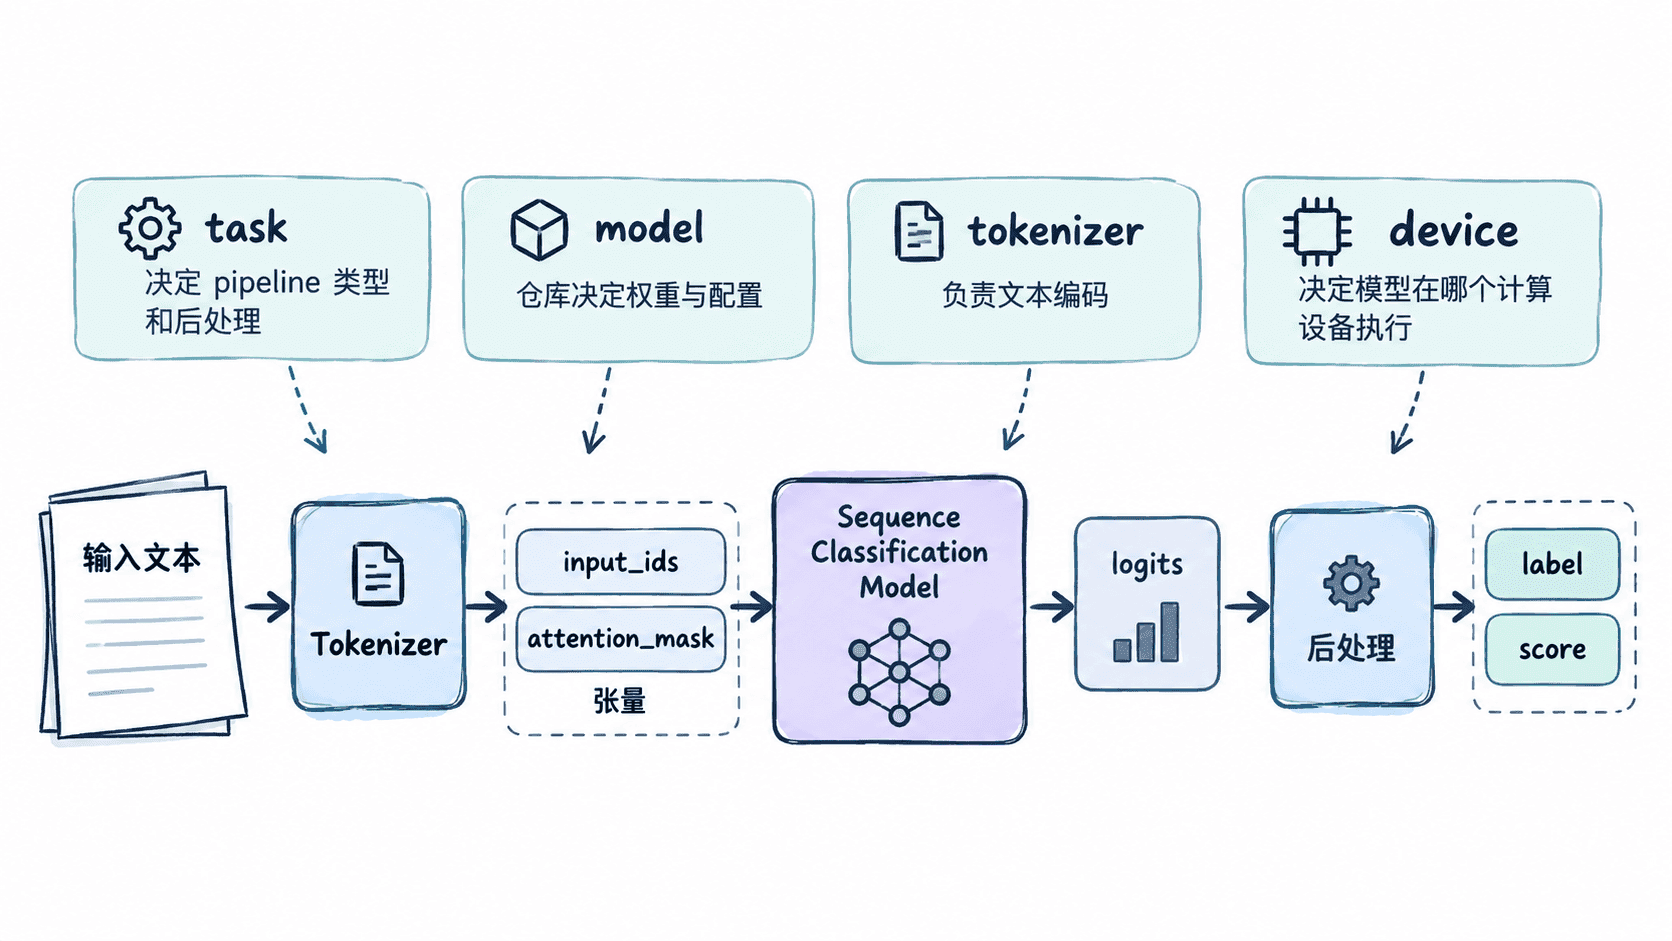
这里显式指定模型,而不是依赖某个任务的默认模型,这样代码更可复现。device="cpu" 则强制在 CPU 推理;有可用 CUDA 环境时,可以根据实际设备改成 device="cuda:0"。
跑通文本分类
下面示例使用已经针对 SST-2 情感分类微调的 DistilBERT。首次运行时,from_pretrained 相关组件会从 Hugging Face Hub 下载并写入本地缓存,之后可直接复用缓存。
from transformers import pipeline

model_id = "distilbert/distilbert-base-uncased-finetuned-sst-2-english"

# 显式固定模型与设备,避免默认选择影响复现。
classifier = pipeline(
    task="text-classification",
    model=model_id,
    device="cpu",
)

text = "I love using Transformers for practical NLP tasks."
prediction = classifier(text)[0]

# 同时检查结果结构和 pipeline 实际装配的组件。
print("label:", prediction["label"])
print("score_is_probability:", 0.0 <= prediction["score"] <= 1.0)
print("tokenizer:", type(classifier.tokenizer).__name__)
print("model:", type(classifier.model).__name__)
print("device:", classifier.device.type)
预期输出:
label: POSITIVE
score_is_probability: True
tokenizer: DistilBertTokenizerFast
model: DistilBertForSequenceClassification
device: cpu
首次下载时可能额外出现进度信息,但上面五行才是本例需要核对的业务输出。分类分数是浮点数,不把它写死,避免不同运行环境中的微小数值差异影响验证。
四个参数怎样共同决定推理
task="text-classification" 告诉 pipeline 采用文本分类所需的输入处理和结果后处理;模型仓库提供配置与权重;匹配的 tokenizer 把字符串转换为模型需要的 token 张量;device 决定这些张量和模型在哪个设备上执行。
如果同时显式传入 tokenizer=,就可以替换自动加载的分词器,但它必须与模型词表和特殊 token 约定兼容。模型与 tokenizer 来自不兼容的仓库时,代码可能仍能运行,却会得到没有意义的输入表示,因此不要把“能执行”当成“组件匹配”。
判断首个任务是否真正跑通
验证时不要只看“程序没有报错”。至少检查标签是否符合输入语义、返回值是否包含合理分数,以及 classifier.model、classifier.tokenizer 与预期架构是否一致。设备切换后还应确认 classifier.device,避免以为在 GPU 推理,实际仍落在 CPU。
pipeline 最适合快速验证模型、做简单批量推理和建立任务基线。需要控制 padding、截断、张量、模型中间输出或自定义后处理时,再下沉到 AutoTokenizer 与 AutoModel 系列会更清楚。