
大模型原理与训练 / 系统课时
保存断点并恢复训练
保存断点并恢复训练
训练中断后,不能只恢复模型权重,还要接回优化器、学习率调度器和训练步数。本节用 Trainer 制造一次中断并从 checkpoint 续训,再用 global step 与学习率验证训练轨迹是否连续。
学习目标
- 说清 checkpoint 中模型、optimizer、scheduler 与训练状态各自负责什么
- 配置按步保存并从指定 checkpoint 恢复
Trainer训练 - 用 global step 和学习率检查恢复前后的训练轨迹是否连续
断点里要保留哪些状态
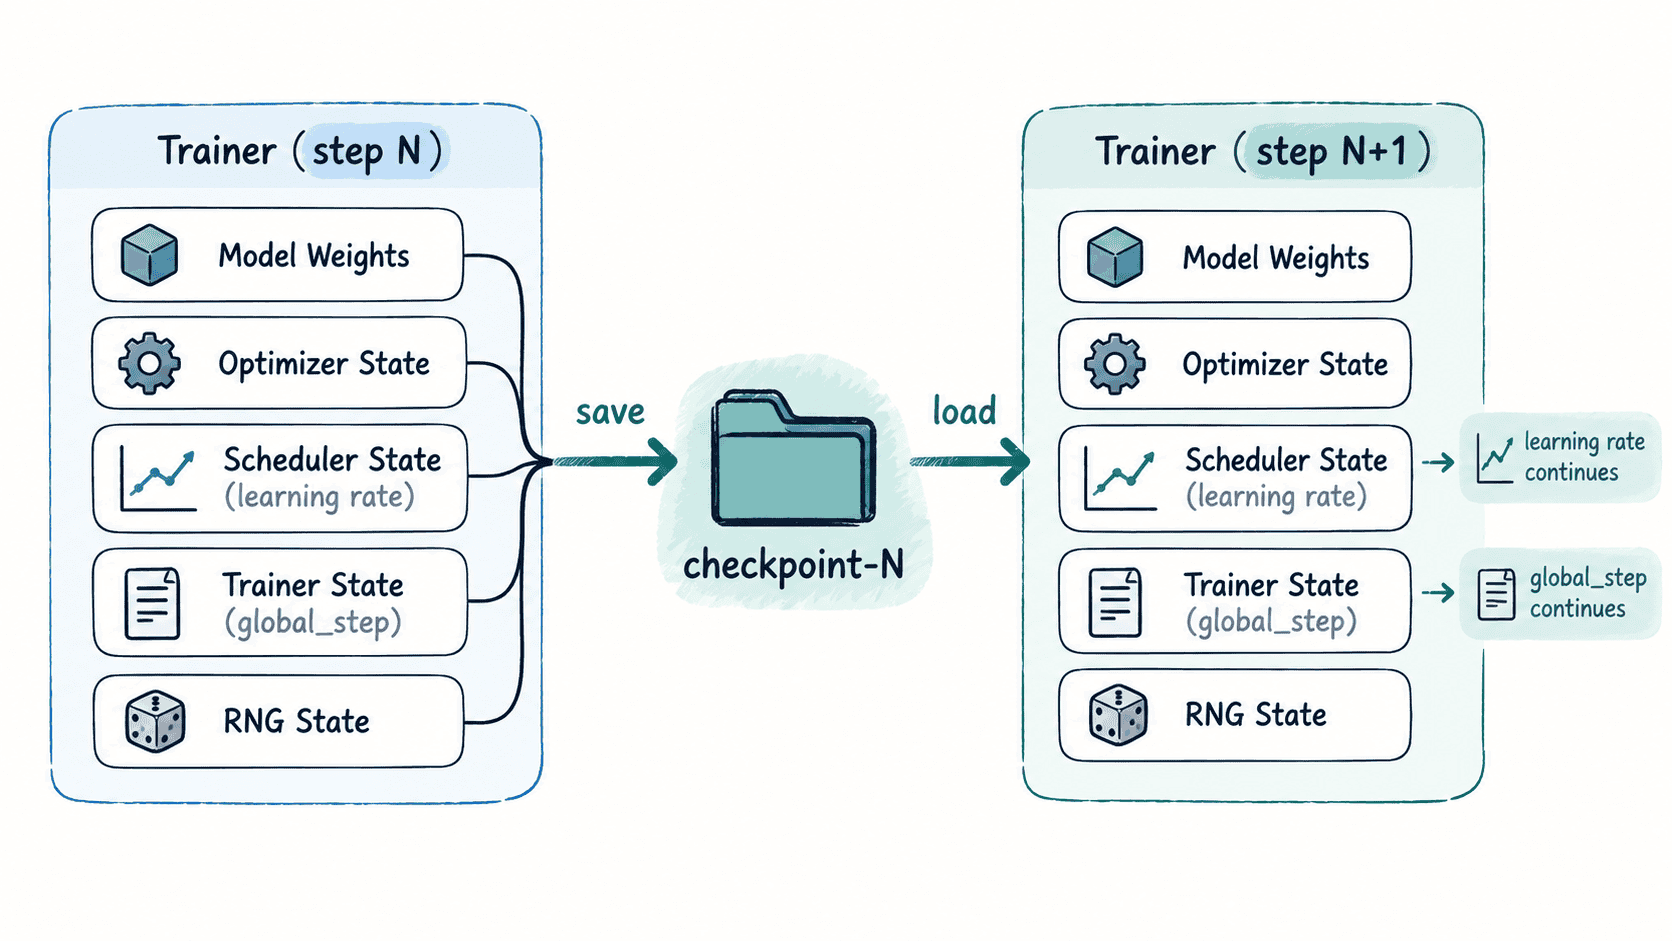
一次可继续训练的 checkpoint 本质上是“某个训练步的完整状态快照”。模型权重决定参数从哪里继续,optimizer 保存动量等内部状态,scheduler 保存学习率进度,trainer_state.json 记录 global step 等控制信息,随机状态则帮助数据采样和随机算子尽量接回原轨迹。
Trainer.train(resume_from_checkpoint=...) 会从 checkpoint 恢复模型、optimizer 和 scheduler。若把 TrainingArguments.save_only_model 设为 True,虽然磁盘占用更小,但 optimizer、scheduler 与随机状态不会保存,这类目录适合推理加载,不适合作为无缝续训断点。
模拟中断并继续到原计划终点
下面的脚本不依赖外部数据集或预训练权重:它创建一个极小的 BERT 分类模型和固定随机数据,计划训练 4 个 optimizer step,在 step 2 保存 checkpoint 后主动停止,再创建新的 Trainer 从 checkpoint-2 继续到 step 4。两个阶段都使用相同的训练参数,因此线性 scheduler 的总步数保持一致。
import json
import shutil
from pathlib import Path

import torch
from torch.utils.data import Dataset
from transformers import (
    BertConfig,
    BertForSequenceClassification,
    Trainer,
    TrainerCallback,
    TrainingArguments,
)

OUTPUT_DIR = Path("checkpoint-demo")
shutil.rmtree(OUTPUT_DIR, ignore_errors=True)

class ToyDataset(Dataset):
    def __init__(self):
        generator = torch.Generator().manual_seed(7)
        self.input_ids = torch.randint(5, 128, (16, 8), generator=generator)
        self.labels = (self.input_ids.sum(dim=1) % 2).long()

    def __len__(self):
        return len(self.input_ids)

    def __getitem__(self, index):
        ids = self.input_ids[index]
        return {
            "input_ids": ids,
            "attention_mask": torch.ones_like(ids),
            "labels": self.labels[index],
        }

def build_model():
    # 小模型只用于验证 checkpoint 行为,不追求任务精度。
    config = BertConfig(
        vocab_size=128,
        hidden_size=32,
        num_hidden_layers=1,
        num_attention_heads=4,
        intermediate_size=64,
        num_labels=2,
    )
    return BertForSequenceClassification(config)

class TraceAndStop(TrainerCallback):
    def __init__(self, stop_after_step_2=False):
        self.stop_after_step_2 = stop_after_step_2

    def on_step_end(self, args, state, control, **kwargs):
        # 每个 optimizer step 后读取 scheduler 已更新的学习率。
        lr = kwargs["lr_scheduler"].get_last_lr()[0]
        print(f"step={state.global_step} lr={lr:.6f}")
        return control

    def on_save(self, args, state, control, **kwargs):
        # 等 checkpoint-2 真正保存后再模拟进程中断。
        if self.stop_after_step_2 and state.global_step == 2:
            control.should_training_stop = True
        return control

args = TrainingArguments(
    output_dir=str(OUTPUT_DIR),
    max_steps=4,
    per_device_train_batch_size=2,
    learning_rate=1e-3,
    lr_scheduler_type="linear",
    warmup_steps=0,
    optim="adamw_torch",
    use_cpu=True,
    save_strategy="steps",
    save_steps=2,
    save_total_limit=2,
    save_only_model=False,
    logging_strategy="no",
    report_to="none",
    disable_tqdm=True,
    seed=7,
    data_seed=7,
)

dataset = ToyDataset()

first = Trainer(
    model=build_model(),
    args=args,
    train_dataset=dataset,
    callbacks=[TraceAndStop(stop_after_step_2=True)],
)
first.train()

checkpoint = OUTPUT_DIR / "checkpoint-2"
trainer_state = json.loads((checkpoint / "trainer_state.json").read_text())
scheduler_state = torch.load(checkpoint / "scheduler.pt", map_location="cpu")
print(f"checkpoint global_step={trainer_state['global_step']}")
print(f"checkpoint lr={scheduler_state['_last_lr'][0]:.6f}")

# 新 Trainer 从同一断点继续;模型、optimizer 和 scheduler 都会被恢复。
resumed = Trainer(
    model=build_model(),
    args=args,
    train_dataset=dataset,
    callbacks=[TraceAndStop()],
)
resumed.train(resume_from_checkpoint=str(checkpoint))
print(f"resumed global_step={resumed.state.global_step}")
print(f"resumed lr={resumed.lr_scheduler.get_last_lr()[0]:.6f}")
预期输出
step=1 lr=0.000750
step=2 lr=0.000500
checkpoint global_step=2
checkpoint lr=0.000500
step=3 lr=0.000250
step=4 lr=0.000000
resumed global_step=4
resumed lr=0.000000
这里最关键的不是最终学习率为 0,而是 checkpoint 记录的 global_step=2 与 lr=0.000500 被续训继承,下一次更新直接进入 step 3,并沿原来的四步线性计划继续下降。
怎样验证状态真的连续
先看 checkpoint-2/trainer_state.json 的 global step,再看恢复后的第一条 step 日志。若恢复正确,步数不会重新从 1 开始。随后比较 checkpoint 中 scheduler 的学习率和续训后的下一步学习率;它们应该沿同一调度曲线推进,而不是回到初始 learning_rate。
还应确认 checkpoint 不是“只有模型权重”的目录。标准 Trainer 断点通常会包含模型文件、optimizer.pt、scheduler.pt、trainer_state.json 和随机状态文件;分布式训练或不同保存后端的文件布局可能不同,但“可恢复 optimizer 与 scheduler 状态”这一条件不变。
恢复训练时守住这些边界
恢复时尽量保持影响训练轨迹的参数不变,包括 optimizer 类型、初始学习率、scheduler 类型、总训练步数、梯度累积与数据处理方式。即使 checkpoint 能成功加载,修改这些条件也可能让后续轨迹不再等价于原计划的连续训练。
如果只写 resume_from_checkpoint=True,Trainer 会尝试从 output_dir 中最近的 checkpoint 恢复;生产任务更适合记录并显式传入确定的 checkpoint 路径。与此同时,不要为了节省磁盘而在需要续训的任务中启用 save_only_model=True,否则只能恢复模型参数,无法恢复完整优化过程。