
大模型原理与训练 / 系统课时
用 LoRA 选择可训练模块
用 LoRA 选择可训练模块
LoRA 的关键不是“把 rank 调大”,而是把低秩更新放到真正影响任务的权重上。本节以因果语言模型为例,先识别 attention 与 MLP 的候选投影层,再配置 r、lora_alpha、lora_dropout,最后用可训练参数比例验证选择是否符合预期。
学习目标
- 能从模型模块名中识别 attention 与 MLP 的 LoRA 候选层
- 能配置
LoraConfig并把适配器挂到指定模块 - 能用可训练参数数量和比例发现目标层选错或覆盖过宽的问题
先决定 LoRA 放在哪里
LoRA 冻结原始权重,只为被选中的投影层增加低秩更新。对常见解码器模型,attention 往往包含 q_proj、k_proj、v_proj、o_proj,MLP 往往包含 gate_proj、up_proj、down_proj。不同架构命名并不统一,因此不要把某组名字当成通用常量。
如果目标是先做低成本实验,可以只选 q_proj 与 v_proj;如果任务需要更强的适应能力,再考虑覆盖 attention 的全部投影,甚至 MLP。覆盖范围越大,可训练参数和优化器状态也越多,不能只看 rank。
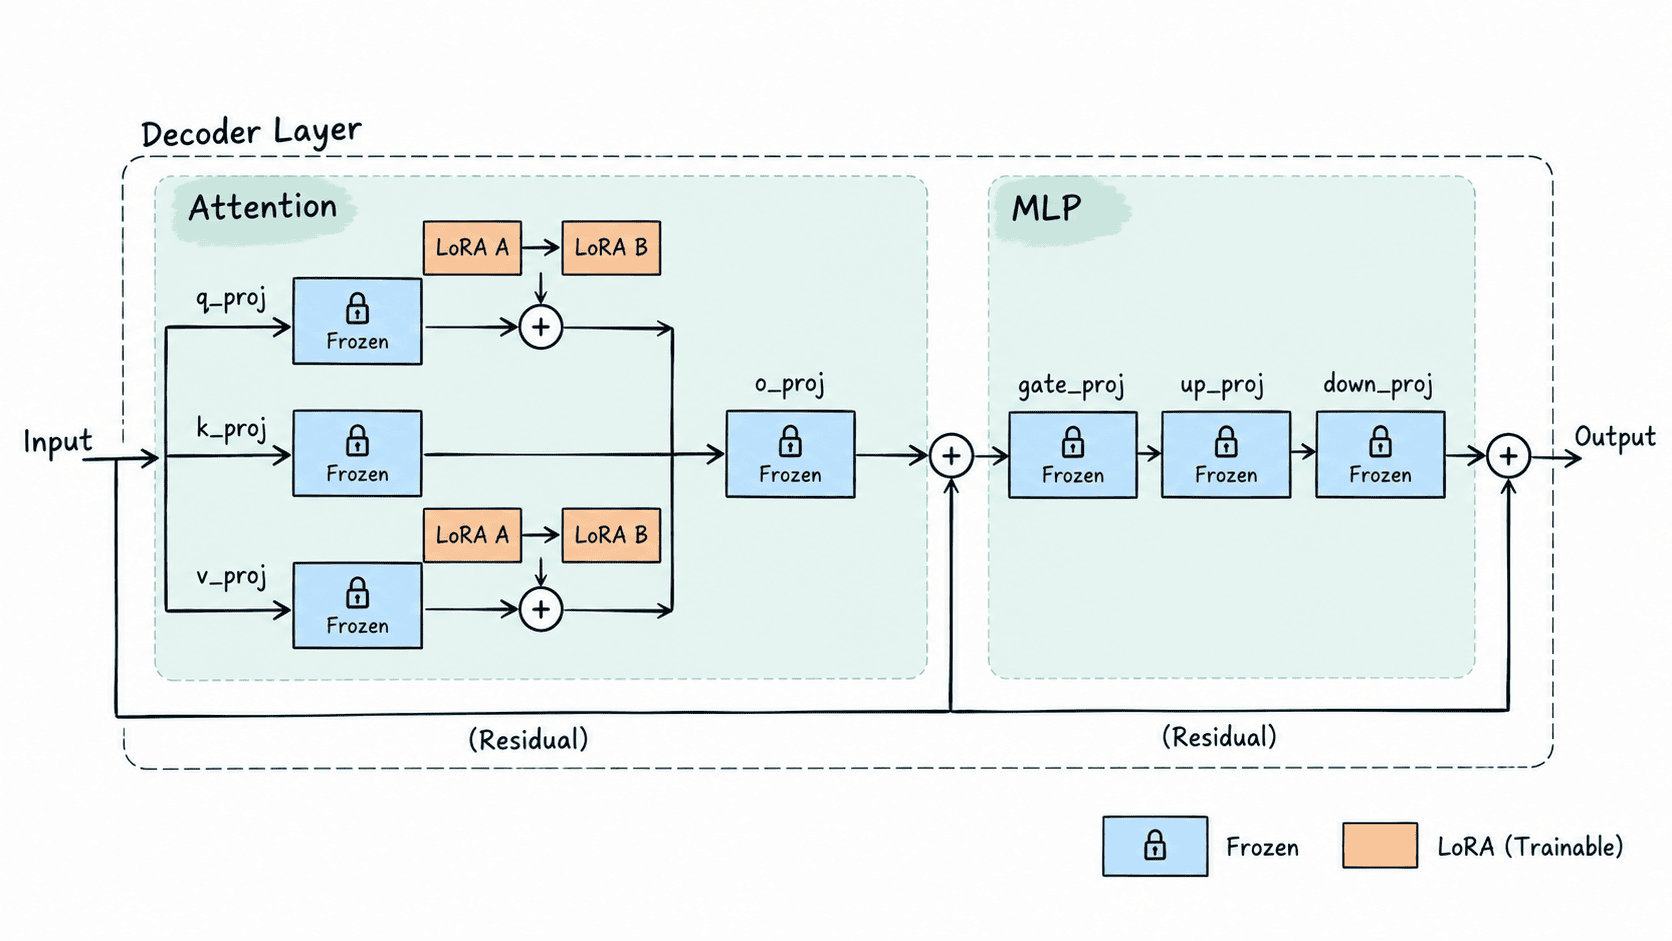
检查模块名再配置
下面示例使用一个小型 Qwen2.5 因果语言模型。先扫描模块名,确认 q_proj 与 v_proj 确实存在,再创建 LoRA。这样比直接复制别人的 target_modules 更稳妥。
from transformers import AutoModelForCausalLM
from peft import LoraConfig, TaskType, get_peft_model

model_id = "Qwen/Qwen2.5-0.5B"
base_model = AutoModelForCausalLM.from_pretrained(model_id)

targets = ["q_proj", "v_proj"]
# 先核对模型真实结构,避免把其他架构的层名直接照搬过来。
module_names = [name for name, _ in base_model.named_modules()]
found = {
    target: any(name.endswith(target) for name in module_names)
    for target in targets
}
print(f"all_targets_found={all(found.values())}")

# rank 控制适配器容量,alpha 控制更新缩放,dropout 只作用于 LoRA 分支。
config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    target_modules=targets,
    r=8,
    lora_alpha=16,
    lora_dropout=0.05,
    bias="none",
)
model = get_peft_model(base_model, config)

# 用参数比例验证基座是否保持冻结且适配器规模足够小。
trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
total = sum(p.numel() for p in model.parameters())
ratio = trainable / total * 100
print(f"base_is_mostly_frozen={trainable < total}")
print(f"trainable_ratio_under_5pct={ratio < 5}")
预期输出
all_targets_found=True
base_is_mostly_frozen=True
trainable_ratio_under_5pct=True
实际参数数量会随模型版本和目标模块变化,但这三个布尔检查应与配置意图一致:目标层存在、基座绝大多数参数被冻结、LoRA 只占较小比例。
理解 rank、alpha 与 dropout
r 决定低秩矩阵的宽度。rank 越大,适配器容量越高,同时参数量和训练成本也会上升。lora_alpha 用于控制 LoRA 更新的缩放强度,常与 r 配合调节;它并不会改变适配器参数个数。
lora_dropout 只作用在 LoRA 分支,常用于缓解小数据集上的过拟合。它不是显存控制参数。若训练数据充足或需要最大化拟合能力,可以从较小值开始,而不是因为“正则化越强越安全”就盲目增大。
用参数比例诊断配置
PEFT 的目标是让可训练参数远少于完整模型,所以参数比例本身就是重要的配置验收信号。比例异常偏高,通常说明目标模块覆盖过宽,或额外模块被设为可训练;比例异常偏低,则应重新检查目标层是否真正命中预期结构。
model.print_trainable_parameters() 可以直接查看 PEFT 统计结果;需要自动化验收时,更适合像示例那样自己计算并设置阈值。阈值没有跨模型的固定答案,应结合模型规模、目标层数量与 rank 判断。
最终要确认的不是“LoRA 已经挂上了”,而是“LoRA 挂在了计划中的层,并且训练预算符合设计”。先检查模块名,再检查参数比例,能在真正开始长时间训练前发现大多数目标层配置错误。