
大模型原理与训练 / 系统课时
用 Trainer 管理训练循环
用 Trainer 管理训练循环
Trainer 的价值不是“少写几行训练代码”,而是把批次读取、前向计算、反向传播、优化器更新、评估与检查点保存放进同一套可配置循环。本节用一个可离线运行的微型分类任务,观察 TrainingArguments 如何真正改变训练节奏。
学习目标
- 用
TrainingArguments配置评估、保存与梯度累积 - 解释一个 micro-batch 从前向计算到参数更新的执行顺序
- 根据
global_step判断评估和检查点何时触发
Trainer 接管了哪些动作
调用 trainer.train() 后,Trainer 会从训练集取出 batch,调用模型完成前向计算并得到 loss,再执行反向传播。达到 gradient_accumulation_steps 指定的累计次数后,才执行一次优化器与学习率调度器更新,并清空本轮累计梯度。
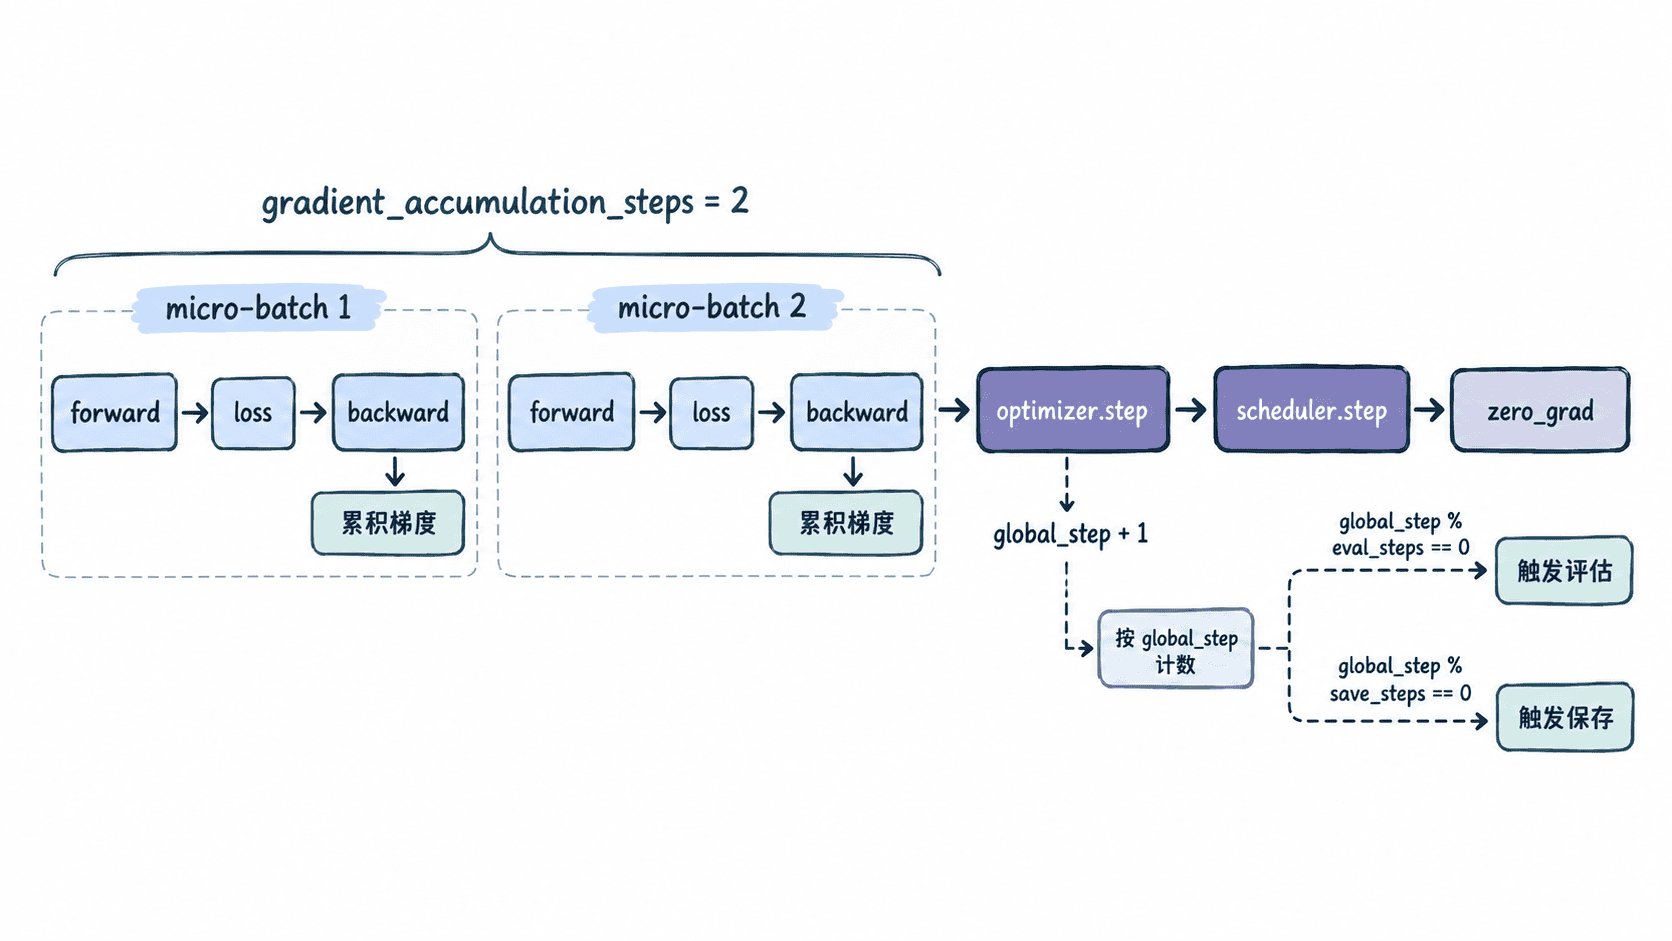
这里最容易混淆的是“前向/反向次数”和“优化器更新次数”。梯度累积不会跳过反向传播,而是让多个 micro-batch 的梯度先累加,再进行一次参数更新。
用 TrainingArguments 定义训练节奏
下面的示例不下载预训练权重,而是用一个很小的 BERT 配置和合成数据演示控制流。运行环境需要已经安装 torch、transformers 与 accelerate。
import shutil
from pathlib import Path

import torch
from torch.utils.data import Dataset
from transformers import (
    BertConfig,
    BertForSequenceClassification,
    PrinterCallback,
    Trainer,
    TrainingArguments,
)

class TinyDataset(Dataset):
    def __init__(self, size: int):
        self.input_ids = torch.randint(0, 100, (size, 8))
        self.attention_mask = torch.ones_like(self.input_ids)
        self.labels = (self.input_ids[:, 0] % 2).long()

    def __len__(self):
        return len(self.labels)

    def __getitem__(self, index):
        return {
            "input_ids": self.input_ids[index],
            "attention_mask": self.attention_mask[index],
            "labels": self.labels[index],
        }

torch.manual_seed(42)
output_dir = Path("./trainer-demo")
shutil.rmtree(output_dir, ignore_errors=True)

model = BertForSequenceClassification(
    BertConfig(
        vocab_size=100,
        hidden_size=32,
        num_hidden_layers=1,
        num_attention_heads=4,
        intermediate_size=64,
        num_labels=2,
    )
)

args = TrainingArguments(
    output_dir=str(output_dir),
    num_train_epochs=2,
    per_device_train_batch_size=4,
    per_device_eval_batch_size=8,
    gradient_accumulation_steps=2,
    learning_rate=5e-4,
    eval_strategy="steps",
    eval_steps=2,
    save_strategy="steps",
    save_steps=2,
    save_total_limit=2,
    logging_strategy="no",
    report_to="none",
    disable_tqdm=True,
)

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=TinyDataset(32),
    eval_dataset=TinyDataset(16),
)
trainer.remove_callback(PrinterCallback)
trainer.train()

checkpoints = sorted(
    (p.name for p in output_dir.glob("checkpoint-*")),
    key=lambda name: int(name.split("-")[-1]),
)
print("global_step:", trainer.state.global_step)
print("checkpoints:", checkpoints)
预期输出
global_step: 8
checkpoints: ['checkpoint-6', 'checkpoint-8']
示例每个 epoch 有 32 / 4 = 8 个 micro-batch,累计 2 个 micro-batch 才更新一次,因此每个 epoch 有 4 个 global_step,两个 epoch 共 8 步。保存曾在第 2、4、6、8 步触发,但 save_total_limit=2 最终只保留最近两个检查点。
评估、保存与有效批量要一起算
eval_steps=2 和 save_steps=2 都按优化器更新后的 global_step 计数,而不是按读取了多少个 micro-batch 计数。梯度累积较大时,如果仍沿用原来的 step 间隔,实际经过的样本数会明显增加。
单设备下,本例每次参数更新等价于处理 4 × 2 = 8 条样本;多设备训练时还要再乘设备数。因此调大 gradient_accumulation_steps 后,应重新检查评估、保存和日志频率是否仍符合预期。
当你只需要“何时评估、何时保存、多久更新一次参数”这类标准控制时,优先配置 TrainingArguments;只有训练步骤本身需要改变,例如自定义 loss、特殊采样或额外优化器逻辑时,才需要进一步覆写 Trainer。