
大模型原理与训练 / 系统课时
微调文本分类模型
微调文本分类模型
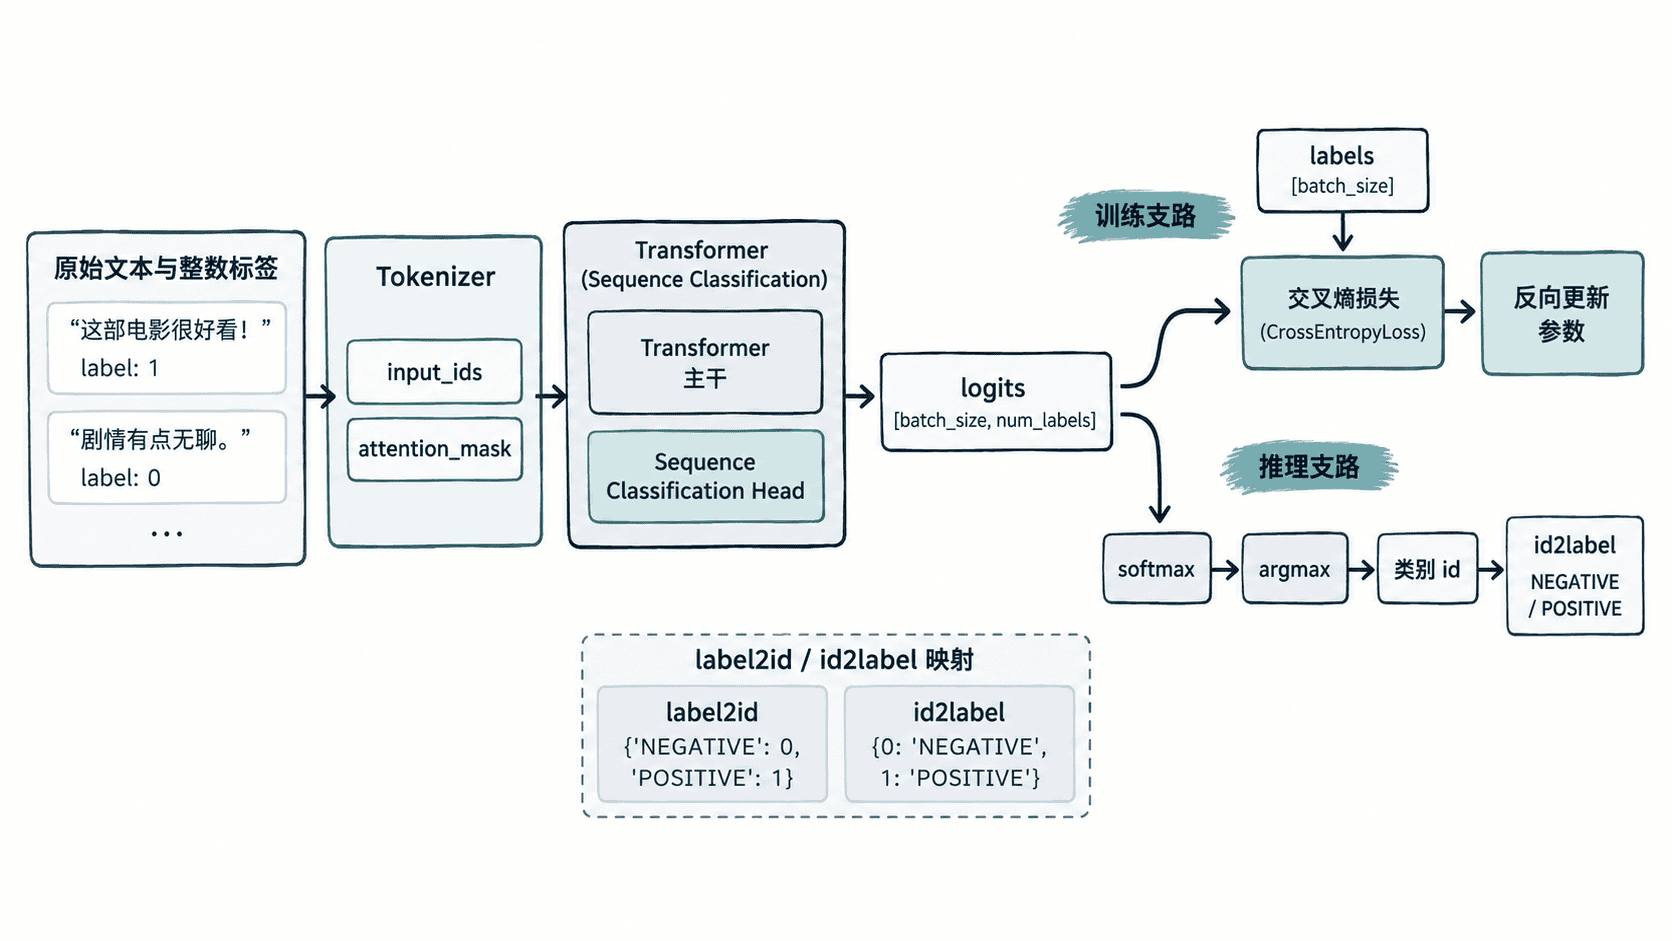
文本分类微调的关键链路是把标签编号、分类头、损失函数和推理概率保持一致。本节从 id2label/label2id 开始,使用 AutoModelForSequenceClassification 完成一个最小可运行训练,并在训练后把 logits 转成类别与概率。
学习目标
- 为分类数据建立稳定的标签编号并写入模型配置
- 理解
AutoModelForSequenceClassification如何在传入labels时产生训练损失 - 将预测 logits 转换为概率,并映射回可读类别名称
先固定标签语义
分类模型内部只处理整数标签,因此必须先决定“哪个整数代表哪个类别”。例如二分类中可以约定 0 -> NEGATIVE、1 -> POSITIVE,再同时构造 id2label 和 label2id。这两个映射会写入模型配置,训练、保存和推理阶段都应保持一致。
如果训练数据把正面样本记为 1,而推理阶段却把 1 解释成负面,即使模型参数完全正确,最终业务结果也会被翻转。标签映射因此不是展示信息,而是训练协议的一部分。
跑通最小分类训练
下面使用少量内存数据演示完整链路。AutoModelForSequenceClassification 会为预训练主干加载序列分类头;当输入同时包含整数 labels 时,单标签分类会得到可反向传播的分类损失。示例只用于验证训练管线,不代表真实任务所需的数据规模。
import torch
from datasets import Dataset
from transformers import (
    AutoModelForSequenceClassification,
    AutoTokenizer,
    DataCollatorWithPadding,
    Trainer,
    TrainingArguments,
)

torch.manual_seed(42)
checkpoint = "distilbert/distilbert-base-uncased"
id2label = {0: "NEGATIVE", 1: "POSITIVE"}
label2id = {label: idx for idx, label in id2label.items()}

train_ds = Dataset.from_dict(
    {
        "text": [
            "I loved this movie.",
            "The story was wonderful.",
            "A delightful and moving film.",
            "I would watch it again.",
            "I hated this movie.",
            "The story was boring.",
            "A dull and disappointing film.",
            "I would not recommend it.",
        ],
        "labels": [1, 1, 1, 1, 0, 0, 0, 0],
    }
)

tokenizer = AutoTokenizer.from_pretrained(checkpoint)

def tokenize(batch):
    return tokenizer(batch["text"], truncation=True)

tokenized = train_ds.map(tokenize, batched=True, remove_columns=["text"])
collator = DataCollatorWithPadding(tokenizer=tokenizer)

model = AutoModelForSequenceClassification.from_pretrained(
    checkpoint,
    num_labels=2,
    id2label=id2label,
    label2id=label2id,
)

# 先直接验证:传入 labels 后模型会返回有限的 loss。
probe = tokenizer(
    ["A delightful film.", "A dull film."],
    return_tensors="pt",
    padding=True,
    truncation=True,
)
probe["labels"] = torch.tensor([1, 0])
with torch.no_grad():
    probe_loss = model(**probe).loss
print("loss_is_finite:", bool(torch.isfinite(probe_loss)))

args = TrainingArguments(
    output_dir="text-cls-output",
    per_device_train_batch_size=4,
    num_train_epochs=1,
    learning_rate=5e-5,
    save_strategy="no",
    logging_strategy="no",
    report_to="none",
    seed=42,
)

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=tokenized,
    processing_class=tokenizer,
    data_collator=collator,
)
trainer.train()

trainer.model.eval()
encoded = tokenizer(
    "I enjoyed every minute of this movie.",
    return_tensors="pt",
    truncation=True,
)
encoded = {name: value.to(trainer.model.device) for name, value in encoded.items()}

with torch.no_grad():
    logits = trainer.model(**encoded).logits[0]
probabilities = torch.softmax(logits, dim=-1).cpu()
predicted_id = int(probabilities.argmax())

print("predicted_label:", trainer.model.config.id2label[predicted_id])
print(
    "probabilities:",
    {
        trainer.model.config.id2label[i]: round(probabilities[i].item(), 4)
        for i in range(len(probabilities))
    },
)
print("probability_sum:", round(probabilities.sum().item(), 4))
预期输出
loss_is_finite: True
predicted_label: <NEGATIVE_OR_POSITIVE>
probabilities: {'NEGATIVE': <P0>, 'POSITIVE': <P1>}
probability_sum: 1.0<NEGATIVE_OR_POSITIVE>、<P0> 与 <P1> 会随实际训练结果变化,两项概率都应位于 0~1 之间且总和约为 1。模型下载与训练框架可能另外打印进度或耗时日志;上面的四行对应脚本显式执行的验证输出。
从 logits 到训练损失
分类头输出的是 logits,它们是未归一化分数,不应直接当成概率。训练时,整数标签与 logits 一起传入模型,模型据此计算分类损失;Trainer 再完成反向传播、梯度更新和训练循环。只要数据列中的 labels 与模型的类别数、标签映射一致,这条损失链路就能闭合。
对于单标签多分类,标签应是 0 到 num_labels - 1 的一个整数。若数据本身使用字符串标签,先统一编码再开始训练,不要在不同数据切分中各自生成一套编号。
用概率验证预测结果
推理时不要传 labels,只取 logits,再沿类别维执行 softmax。最大概率所在位置就是预测类别 id,最后用 id2label 转回业务名称。验证时至少检查三件事:概率维度等于类别数、概率总和约为 1、预测 id 能在 id2label 中找到。
当这条链路稳定后,再扩展到真实训练集、验证集和指标计算会更可靠:标签语义先固定,模型负责产生 loss 与 logits,训练器负责优化参数,推理阶段只把 logits 转成可解释的类别概率。