
大模型原理与训练 / 系统课时
定位加载失败与显存溢出
定位加载失败与显存溢出
模型上线时,加载报错和 CUDA OOM 往往被混在一起处理,结果越改越乱。本篇把故障拆成权重、dtype、设备放置、输入长度和显存五条路径,并用一个最小诊断脚本固定证据,帮助你判断问题发生在“加载前”还是“推理时”。
学习目标
- 能按固定顺序判断权重、dtype 与设备放置问题
- 能区分模型加载 OOM 与前向推理 OOM
- 能通过输入长度和显存证据验证修复是否有效
先把故障分成两个阶段
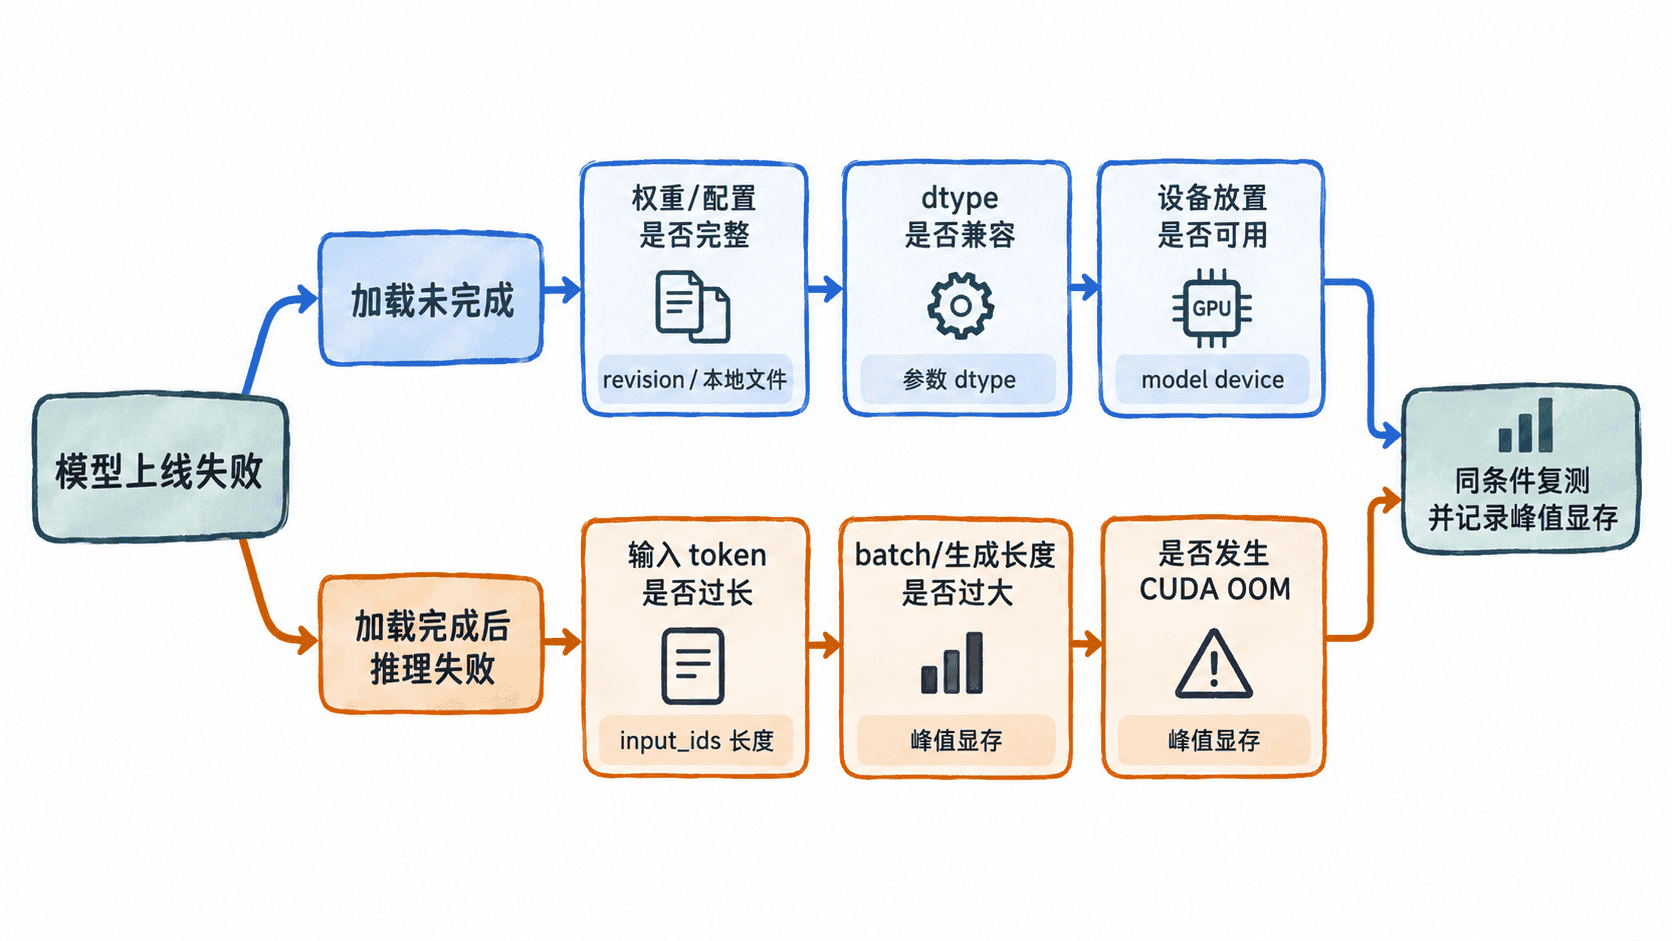
第一刀不是看错误关键词,而是确认故障发生在哪个阶段。若 Tokenizer 或模型权重尚未完整加载,就先查仓库、修订版本、文件完整性和 dtype;若模型已经加载成功,直到编码输入或前向计算才失败,就把重点转向设备、序列长度、批大小和运行时显存。
加载 OOM 与推理 OOM 的处理顺序也不同。前者说明仅权重和加载临时开销就已经超过可用内存;后者则常由激活、长序列、批处理或生成缓存叠加造成。不要一看到 OOM 就先调用缓存清理函数,它无法释放仍被模型或张量引用的显存。
用最小诊断脚本固定证据
下面脚本只做一件事:把“加载 Tokenizer → 加载模型 → 放到目标设备 → 编码 → 前向”分段打印出来。默认模型较小,可先确认环境链路正常;替换 MODEL_ID 后,同一脚本就能定位你的实际模型停在哪个阶段。
import os
import torch
from transformers import AutoModelForSequenceClassification, AutoTokenizer

MODEL_ID = os.getenv(
    "MODEL_ID",
    "distilbert/distilbert-base-uncased-finetuned-sst-2-english",
)
MAX_LENGTH = int(os.getenv("MAX_LENGTH", "128"))

def print_gpu_memory(tag: str) -> None:
    if not torch.cuda.is_available():
        print(f"{tag}: gpu=not_available")
        return
    free, total = torch.cuda.mem_get_info()
    allocated = torch.cuda.memory_allocated()
    print(
        f"{tag}: free_gib={free / 2**30:.2f}, "
        f"total_gib={total / 2**30:.2f}, "
        f"allocated_gib={allocated / 2**30:.2f}"
    )

def main() -> None:
    device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
    print(f"stage=tokenizer model_id={MODEL_ID}")
    tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
    print("stage=model_load")
    print_gpu_memory("before_model")
    model = AutoModelForSequenceClassification.from_pretrained(
        MODEL_ID,
        dtype="auto",
    )
    model.to(device)
    model.eval()
    print_gpu_memory("after_model")
    print("stage=tokenize")
    encoded = tokenizer(
        "A short request used to verify the deployment path.",
        return_tensors="pt",
        truncation=True,
        max_length=MAX_LENGTH,
    )
    encoded = {name: tensor.to(device) for name, tensor in encoded.items()}
    if torch.cuda.is_available():
        torch.cuda.reset_peak_memory_stats()
    print("stage=forward")
    with torch.inference_mode():
        output = model(**encoded)
    first_param = next(model.parameters())
    print(f"model_device={first_param.device}")
    print(f"weight_dtype={first_param.dtype}")
    print(f"input_tokens={encoded['input_ids'].shape[-1]}")
    print(f"logits_shape={tuple(output.logits.shape)}")
    if torch.cuda.is_available():
        peak = torch.cuda.max_memory_allocated() / 2**30
        print(f"forward_peak_gib={peak:.2f}")

if __name__ == "__main__":
    main()
预期输出
stage=tokenizer model_id=distilbert/distilbert-base-uncased-finetuned-sst-2-english
stage=model_load
before_model: <GPU_MEMORY_OR_NOT_AVAILABLE>
after_model: <GPU_MEMORY_OR_NOT_AVAILABLE>
stage=tokenize
stage=forward
model_device=<DEVICE>
weight_dtype=<DTYPE>
input_tokens=<N>
logits_shape=(1, 2)
forward_peak_gib=<PEAK_IF_CUDA><DEVICE>、<DTYPE>、<N> 和显存数字会随机器、依赖版本与输入变化;CPU 环境不会出现最后的峰值显存行。关键不是数值本身,而是最后成功打印到哪个 stage。
按五条路径逐层定位
加载阶段:权重、dtype 与设备
先确认模型标识、本地目录或 revision 指向的是同一套产物。配置、Tokenizer 和权重来自不同版本时,常见表现是文件缺失、张量尺寸不匹配,或出现大量 missing/unexpected keys。不要把 ignore_mismatched_sizes 当成通用修复;只有你明确改变了分类头等结构并接受部分参数重新初始化时才应该使用它。
随后检查 dtype。优先让模型按保存时精度加载,例如 dtype="auto",再根据硬件能力显式切到 FP16、BF16 或 FP32。若某个 dtype 在目标设备上不受支持,修复方向是调整精度或硬件,而不是继续修改权重文件。
最后检查设备放置。单卡脚本要保证模型和输入张量在同一设备;多卡或 CPU/GPU 混合场景可使用自动设备映射与显存上限,但要把它当成明确的部署策略。使用 Pipeline 时,不要同时再传一套互相冲突的 device 与 device_map 设置。
推理阶段:输入长度与显存
模型已经加载成功却在 forward 阶段失败,先打印实际 token 数,而不是按字符数猜长度。Tokenizer 的 truncation=True 与 max_length 可以限制输入,但截断会改变语义;长文任务如果不能直接截断,应改成分块、滑窗或任务专用的长上下文方案。
确认长度后再处理 OOM。优先依次降低 batch、输入长度和生成长度,再评估更低精度、量化、CPU/磁盘 offload 或更小模型。生成式模型还要把 KV cache 算进预算,因为它会随上下文和新增 token 增长。torch.cuda.empty_cache() 只能归还未被活跃张量占用的缓存,不能替代这些结构性调整。
修复后用同条件复测
修复后的验证必须固定模型版本、输入样本、batch 和长度参数,否则“没有再 OOM”可能只是测试条件变轻了。至少连续跑一次冷启动和一次热推理,记录加载是否成功、输入 token 数以及峰值显存;如果启用了自动设备映射,还要核对实际放置结果是否符合预期。
只有当同一组输入在目标机器上稳定通过,并且显存留有可解释的安全余量,故障才算真正关闭。这样得到的是可复现的根因与修复证据,而不是一次偶然成功的运行。