
大模型原理与训练 / 系统课时
处理截断填充与注意力掩码
处理截断填充与注意力掩码
同一批文本经过分词后往往长度不同,直接拼成张量会失败,盲目补齐又可能让模型把填充位置当成正文。本节用一个可运行示例统一处理 truncation、padding、max_length 与 attention_mask,并说明怎样检查批处理结果是否符合预期。
学习目标
- 根据批处理场景选择动态填充或固定长度填充
- 正确组合
truncation、padding与max_length - 通过
attention_mask验证模型会忽略哪些填充位置
四个参数分别控制什么
Tokenizer 先把每条文本转换为 token 序列,再尝试把多条序列组成一个批次。批处理中最常见的问题不是分词本身,而是每条序列的长度不同。
truncation=True 表示超过允许长度时截断;max_length 给出目标上限,并且这个长度通常包含模型自动加入的特殊 token。没有开启截断时,仅设置 max_length 并不意味着长序列一定会被裁短。
padding=True 会把当前批次中的短序列补到该批最长序列;padding="max_length" 则补到 max_length。前者通常减少无效计算,后者适合需要固定形状的导出、静态批处理或特定部署环境。
attention_mask 与 token 序列逐位置对应。通常值 1 表示该位置参与注意力计算,值 0 表示这里是 padding,应被模型忽略。不要自行假设 token ID 为 0 的位置就是 padding,不同 tokenizer 的 pad_token_id 可以不同。
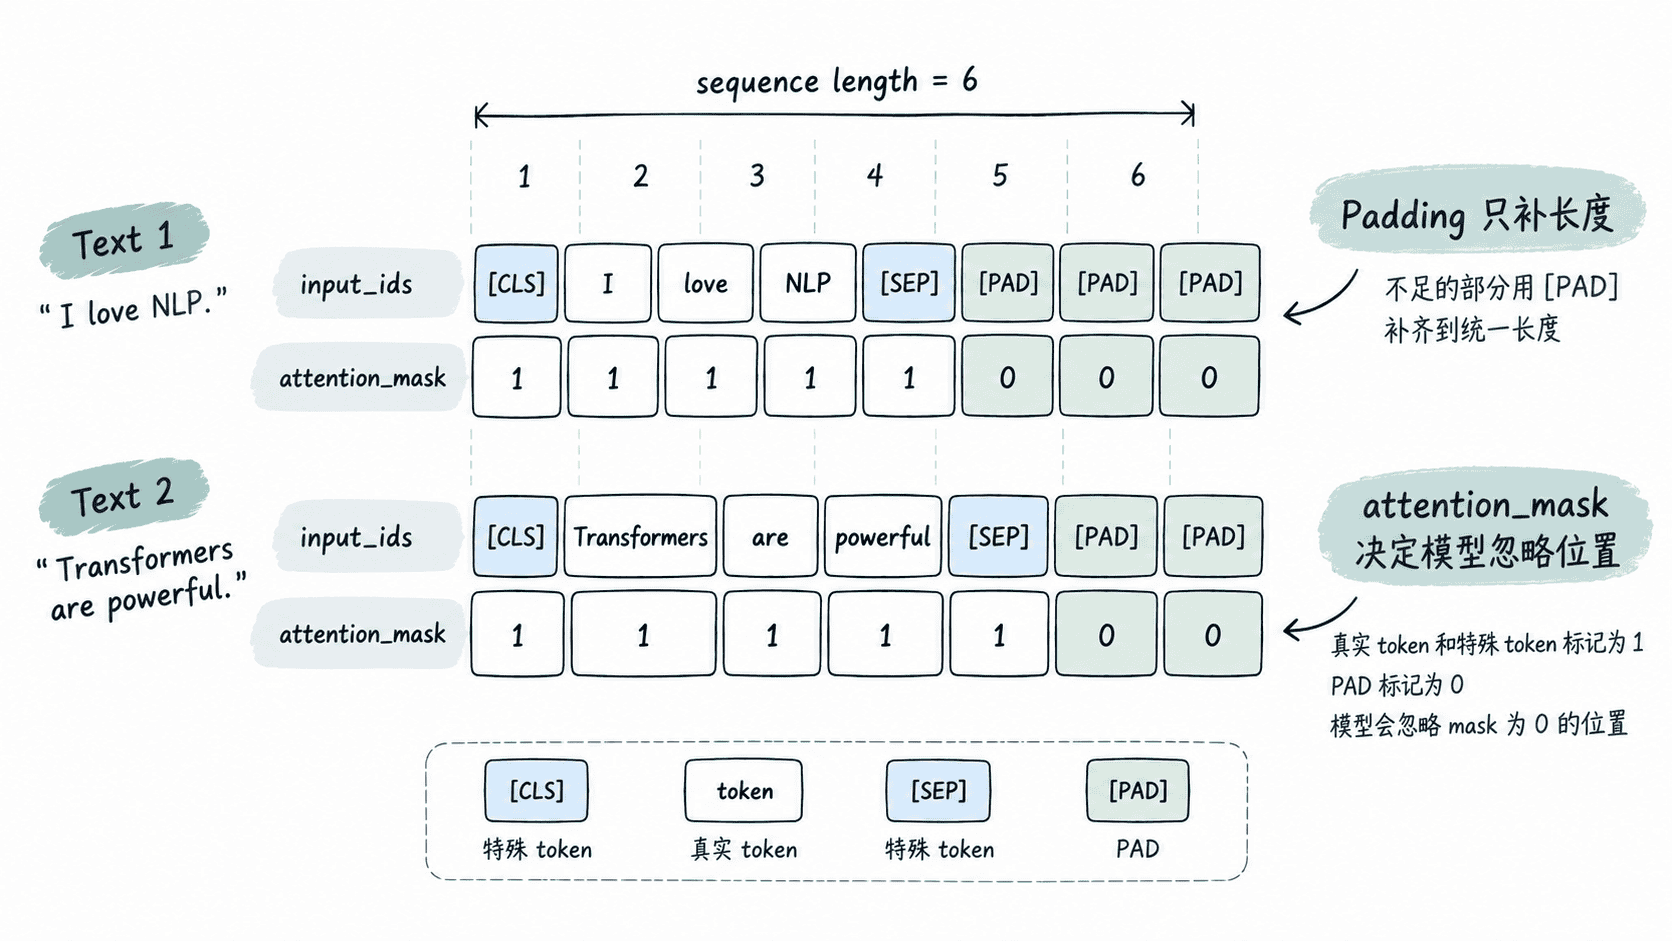
生成一个固定长度批次
下面使用 BERT tokenizer,把两条不同长度的英文文本统一成长度为 6 的张量。示例同时打开截断和固定长度填充,并直接检查掩码。
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")
texts = ["hello", "hello world"]

batch = tokenizer(
    texts,
    truncation=True,
    padding="max_length",
    max_length=6,
    return_tensors="pt",
)

print(batch["input_ids"].shape)
print(batch["attention_mask"].tolist())
print("pad_token_id:", tokenizer.pad_token_id)
预期输出
torch.Size([2, 6])
[[1, 1, 1, 0, 0, 0], [1, 1, 1, 1, 0, 0]]
pad_token_id: 0
这里的第一维 2 是 batch 大小,第二维 6 是统一后的 sequence 长度。第一条文本只有三个有效位置,因此后面三个位置的掩码为 0;第二条文本有四个有效位置,后面两个位置为 0。
动态填充与固定填充怎么选
训练和普通批量推理通常优先考虑 padding=True。它只补到当前 batch 的最长序列,可以减少大量 PAD 带来的无效计算。如果不同 batch 得到不同的 sequence 长度通常没有问题,因为 PyTorch 和 Transformers 可以处理这种动态形状。
需要稳定张量形状时再使用 padding="max_length"。例如导出某些固定输入尺寸的模型,或下游系统明确要求每批都是相同长度。此时 max_length 设得过大会浪费显存和计算,设得过小则可能截掉真正有用的信息。
检查异常结果的顺序
出现维度不一致、模型效果突然下降或批处理报错时,先检查 input_ids.shape 与 attention_mask.shape 是否完全一致,再观察每行掩码中的 0 是否只对应 padding。两者形状不同通常意味着输入在进入模型前被手工修改过。
如果长文本没有被裁短,检查是否真正设置了 truncation=True;如果同一批张量无法堆叠,检查是否启用了 padding;如果所有位置都被当成有效 token,则检查是否丢失或错误构造了 attention_mask。
在实际项目中,最稳妥的做法是让 tokenizer 同时生成 input_ids 和 attention_mask,再把整个返回字典传给模型,而不是自行根据 token ID 推导掩码。这样截断、填充与模型输入约定能够保持一致。