
大模型原理与训练 / 系统课时
保存加载并切换适配器
保存加载并切换适配器
PEFT 的价值不只是减少可训练参数,还在于把任务差异收敛到独立 adapter 中。本节把两个 LoRA adapter 分别保存到磁盘,再挂载到同一个基座模型,并用名称切换当前 adapter,从而让一份基座权重复用于多个任务。
学习目标
- 能只保存 PEFT adapter,而不是重复保存整套基座权重
- 能把多个 adapter 重新加载到同一个基座模型
- 能用 adapter 名称切换当前任务,并理解切换与合并的区别
adapter 与基座模型如何分工
LoRA adapter 只保存新增的低秩参数和对应配置,基座模型参数仍由原模型提供。重新使用时,必须先加载兼容的基座模型,再把 adapter 挂上去;adapter 不是可以脱离基座单独推理的完整模型。
多个 adapter 可以同时注册在同一个 PeftModel 中,但一次推理默认只激活指定 adapter。这样就能把“通用语言能力”留在基座中,把“任务 A / 任务 B 的增量能力”分开放置。
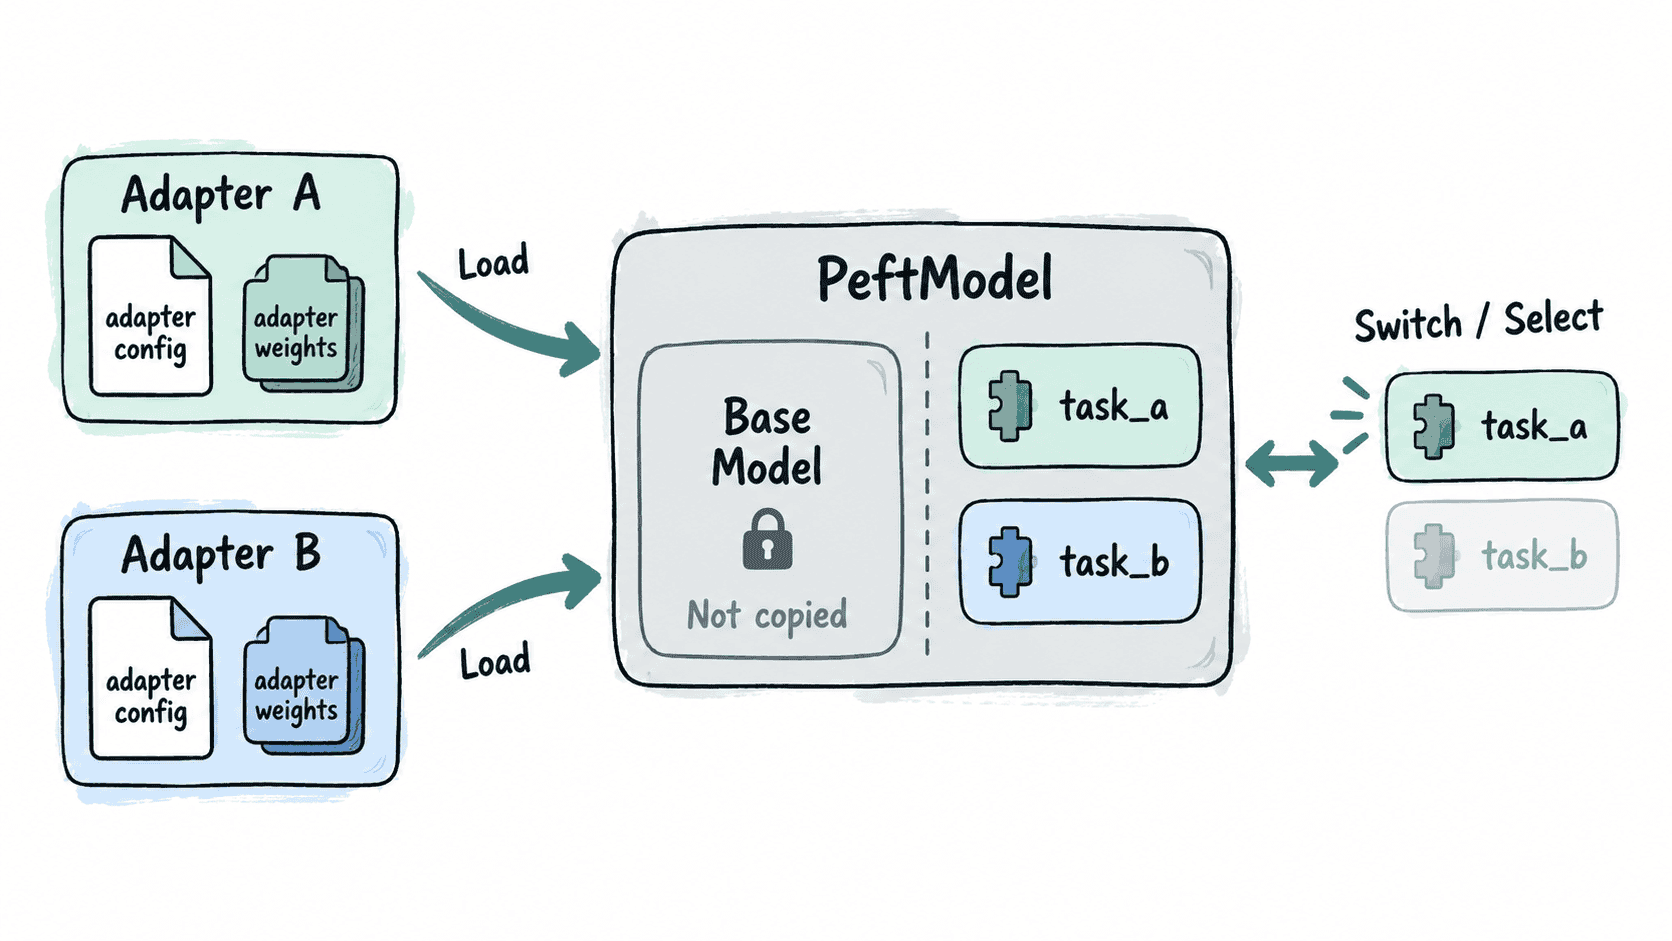
保存两个独立 adapter
下面的脚本用同一个小型 GPT-2 基座创建两个 LoRA adapter,分别保存,再重新加载到一份基座模型中。这里没有训练两个任务,目的是只验证 adapter 的持久化和切换机制。
from transformers import AutoModelForCausalLM
from peft import LoraConfig, PeftModel, TaskType, get_peft_model

model_id = "sshleifer/tiny-gpt2"
config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    r=4,
    lora_alpha=8,
    lora_dropout=0.0,
    target_modules=["c_attn"],
    fan_in_fan_out=True,
)

def create_and_save_adapter(path: str) -> None:
    base = AutoModelForCausalLM.from_pretrained(model_id)
    peft_model = get_peft_model(base, config)
    # save_pretrained 只持久化 PEFT 配置和 adapter 权重。
    peft_model.save_pretrained(path, safe_serialization=True)

create_and_save_adapter("adapter-task-a")
create_and_save_adapter("adapter-task-b")

base = AutoModelForCausalLM.from_pretrained(model_id)
model = PeftModel.from_pretrained(
    base,
    "adapter-task-a",
    adapter_name="task_a",
    is_trainable=False,
)
model.load_adapter(
    "adapter-task-b",
    adapter_name="task_b",
    is_trainable=False,
)

print("adapters=", sorted(model.peft_config.keys()))

model.set_adapter("task_a")
print("active=", model.active_adapter)

model.set_adapter("task_b")
print("active=", model.active_adapter)
预期输出
adapters= ['task_a', 'task_b']
active= task_a
active= task_b
下载进度条或库版本日志可能不同,但这三行应保持相同含义:两个 adapter 已注册,并且活动 adapter 可以按名称切换。is_trainable=False 让重新加载的 adapter 作为推理参数使用;若要继续训练,应显式按训练目标设置可训练状态。
加载时必须保证兼容
adapter 配置记录了 LoRA 的秩、目标模块等信息,但它仍依赖原基座的层结构。最常见的失败是把 adapter 挂到另一个架构或不同模块命名的模型上,随后出现目标层找不到或权重尺寸不匹配。生产环境应把基座模型标识和版本与 adapter 一起登记,而不是只保存一个 adapter 目录。
如果 adapter 需要从本地目录或模型仓库加载,路径来源可以不同,但逻辑不变:先得到基座,再调用 PeftModel.from_pretrained 加载第一个 adapter,之后用 load_adapter 注册更多 adapter,并为它们分配稳定且不重复的名称。
切换不等于合并
set_adapter 只是改变当前激活的增量参数,基座权重仍保持共享,因此适合在线多任务复用。切换前应先结束上一任务的批次,避免在并发请求中由全局状态切换造成任务串扰;高并发服务通常需要按请求路由到独立模型实例,或使用框架提供的多 adapter 推理能力。
merge_and_unload 则是另一类操作:它把 LoRA 增量合并进基座权重,便于得到不再依赖 PEFT 注入层的模型,但也失去了“同一基座快速切换多个 adapter”的优势。需要多任务热切换时,保留独立 adapter;需要单任务独立部署时,再考虑合并。