
大模型原理与训练 / 系统课时
套用聊天模板构造对话输入
套用聊天模板构造对话输入
聊天模型并不直接理解 system、user、assistant 这些 Python 字段;它真正接收的是带控制 token 的序列。本篇用模型自带的 chat template 把多轮消息稳定转换为训练时一致的格式,并说明生成提示、预填充和重复特殊 token 的边界。
学习目标
- 用
apply_chat_template()正确拼接多角色消息 - 区分
add_generation_prompt与continue_final_message的用途 - 避免手工插入控制 token 和重复添加特殊 token
聊天模板解决的是格式一致性
同样一组对话,不同模型可能使用完全不同的控制 token、换行和结束标记。消息列表只描述“谁说了什么”,chat template 才负责把角色和内容渲染成该模型训练时见过的序列。手工写 <|assistant|>、[INST] 一类标记,看起来相似也可能与目标模型的真实模板不一致。
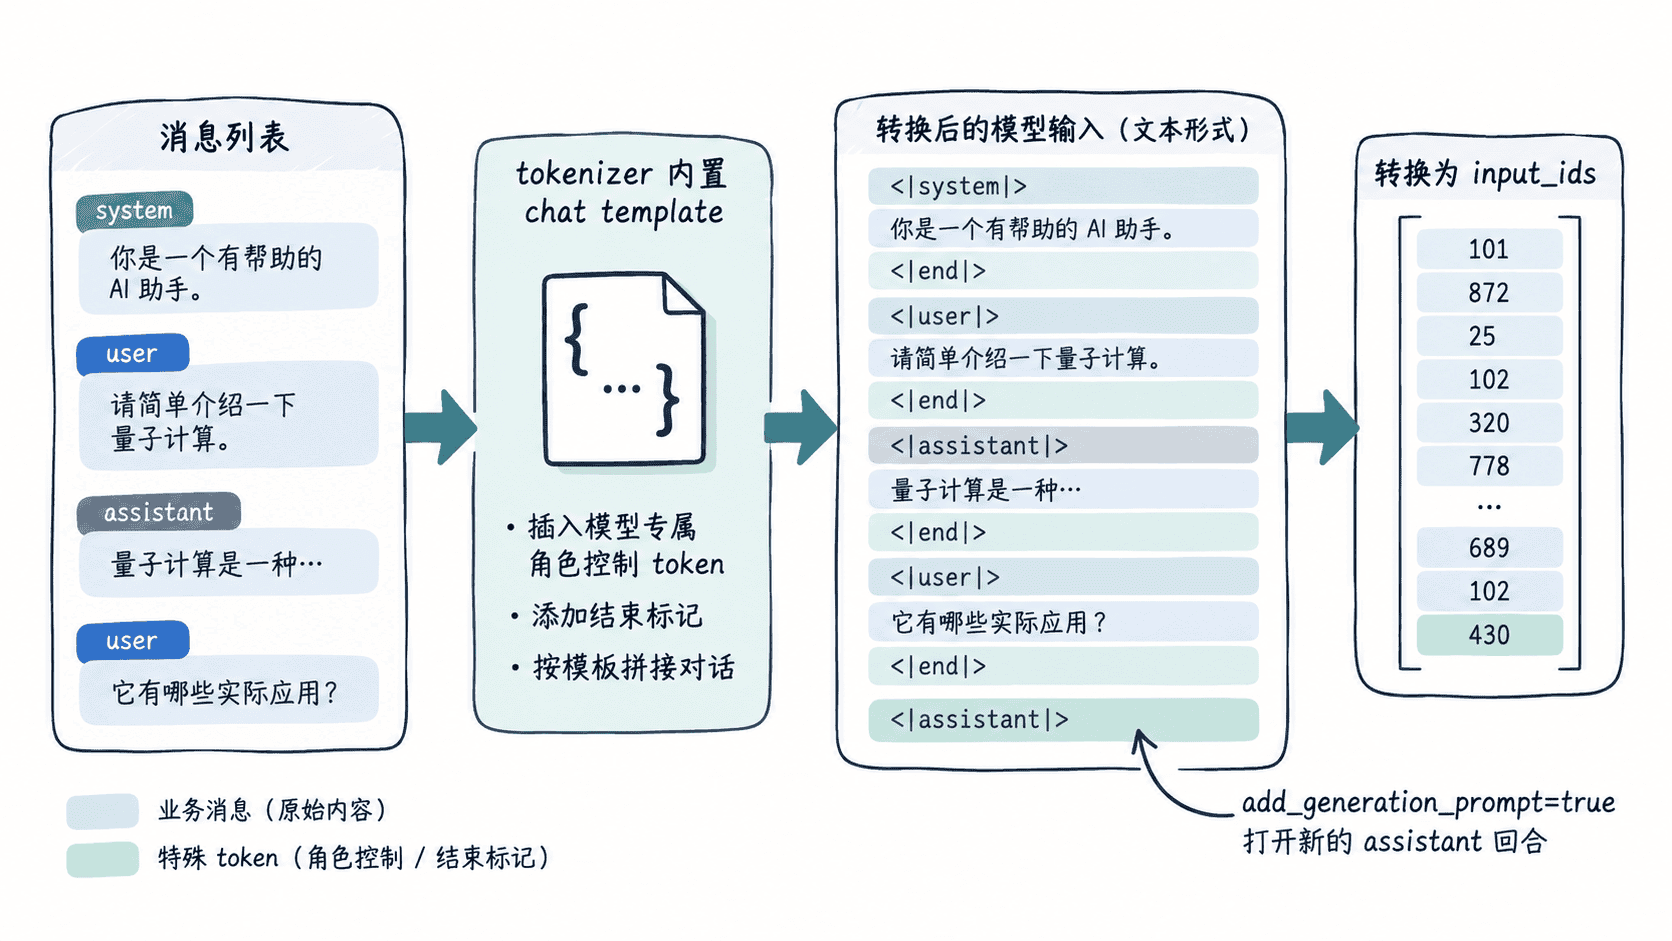
关键点是让 tokenizer 决定格式。只要模型仓库提供了正确模板,应用代码就不必知道它究竟使用 ChatML、[INST] 还是其他协议。
用模型自带模板构造输入
下面使用 HuggingFaceTB/SmolLM2-135M-Instruct。示例只加载 tokenizer,因此可以直接观察模板产物,不需要先运行模型推理。
from transformers import AutoTokenizer

model_id = "HuggingFaceTB/SmolLM2-135M-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_id)

messages = [
    {"role": "system", "content": "只用一句中文回答。"},
    {"role": "user", "content": "2+3 等于多少?"},
    {"role": "assistant", "content": "5。"},
    {"role": "user", "content": "再加 4 呢?"},
]

rendered = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
)

print(rendered, end="")
预期输出
<|im_start|>system
只用一句中文回答。<|im_end|>
<|im_start|>user
2+3 等于多少?<|im_end|>
<|im_start|>assistant
5。<|im_end|>
<|im_start|>user
再加 4 呢?<|im_end|>
<|im_start|>assistant
这里最后只有 assistant 回合的起始标记,没有回答内容,因为 add_generation_prompt=True 的含义就是“下一段由 assistant 生成”。如果改成 False,模板只会封闭已有消息,不主动开启新回复。
直接生成时让模板同时分词
真正传给 model.generate() 时,优先让 apply_chat_template() 一次完成模板渲染和分词:设置 tokenize=True、return_dict=True、return_tensors="pt",得到的 input_ids 和 attention_mask 可直接送入模型。这样不会经历“先拼字符串,再猜特殊 token 应不应该补”的第二套规则。
如果确实需要先取得字符串,再调用 tokenizer(rendered),应显式设置 add_special_tokens=False。聊天模板通常已经放入模型所需的特殊 token,再自动补一次 BOS、EOS 等标记可能造成重复,轻则浪费上下文,重则改变模型对角色边界的判断。
生成新回复与续写最后一条消息
常规聊天通常以用户消息结束,此时使用 add_generation_prompt=True,让模板打开新的 assistant 回合。另一种场景是已经给出 assistant 回复的前缀,希望模型从这个前缀继续写,此时使用 continue_final_message=True,模板会把最后一条消息保持为“未结束”。
这两个参数表达相反意图:一个要开始新消息,一个要继续旧消息,因此不要同时启用。需要预填充结构化答案时,可以把最后一条消息设为 assistant 前缀并选择 continue_final_message=True;普通问答则保持用户消息结尾并使用生成提示。
避免三类格式偏差
不要把某个模型的控制 token 复制到另一个模型;即使角色名称相同,训练格式也未必相同。不要先用模板插入特殊 token,再让 tokenizer 自动补一遍。也不要为了“修正格式”随意改变角色顺序,例如把历史 assistant 回答拼进 user 文本,这会让模板失去角色边界。
判断是否正确最简单的方法,是在调试阶段先用 tokenize=False 打印渲染结果,确认角色、结束标记和最后的生成位置,再切换到 tokenized 输入。这样模板逻辑与业务消息始终分离,后续更换聊天模型时也只需让新 tokenizer 使用自己的模板。