
大模型原理与训练 / 系统课时
用停止条件约束生成边界
用停止条件约束生成边界
生成质量不仅取决于“生成什么”,还取决于“什么时候停”。本节把 max_new_tokens、EOS、停止字符串和自定义 StoppingCriteria 放到同一条生成循环里理解,并用可验证脚本确认每种边界何时触发。
学习目标
- 区分长度上限、EOS、停止字符串和自定义停止条件的职责
- 为生成任务同时设置正常终止条件与兜底上限
- 编写并验证一个符合 Transformers 接口的自定义
StoppingCriteria
停止条件是生成循环的出口
max_new_tokens 限制相对提示词新增的 token 数,适合作为所有请求的兜底上限;EOS 在模型生成结束 token 时停止;stop_strings 在输出匹配指定字符串后停止。当前 Transformers 文档推荐用 max_new_tokens 控制新增长度,并说明使用停止字符串时要把 tokenizer 传给 generate。([Hugging Face][2])
自定义 StoppingCriteria 用于更业务化的条件,例如达到某个结构边界、外部状态满足条件,或在批处理中按样本判断是否应停止。当前 PyTorch 生成接口要求停止条件返回批次维度上的布尔张量,True 表示对应样本应终止。([Hugging Face][3])
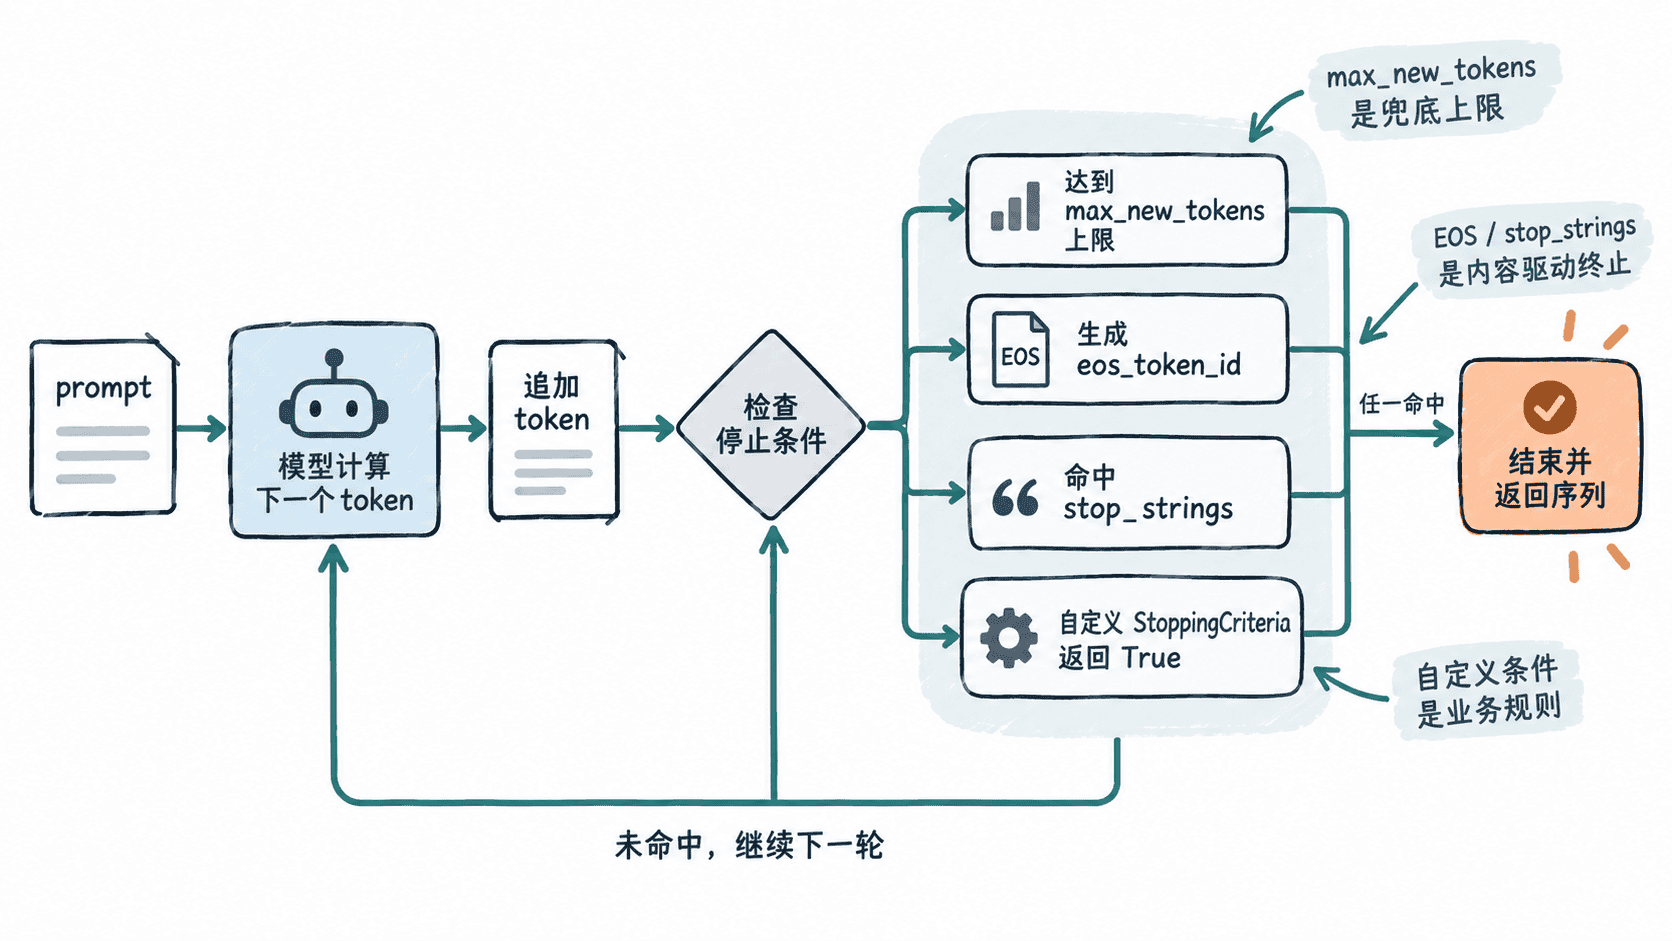
用可控 token 验证四种停止方式
为了不依赖模型“碰巧”生成某个字符,示例用一个 LogitsProcessor 强制下一 token 为句点。这样 EOS 与停止字符串是否生效都能得到确定结果,同时仍然走真实的 model.generate() 生成循环。
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    LogitsProcessor,
    LogitsProcessorList,
    StoppingCriteria,
    StoppingCriteriaList,
)

MODEL_ID = "openai-community/gpt2"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(MODEL_ID)
model.eval()

inputs = tokenizer("Boundary test:", return_tensors="pt")
start_length = inputs["input_ids"].shape[1]
dot_id = tokenizer(".", add_special_tokens=False)["input_ids"][0]
default_eos = tokenizer.eos_token_id

class ForceToken(LogitsProcessor):
    def __init__(self, token_id):
        self.token_id = token_id

    def __call__(self, input_ids, scores):
        # 只保留指定 token,用来构造可重复的停止条件实验。
        forced = torch.full_like(scores, float("-inf"))
        forced[:, self.token_id] = 0
        return forced

class StopAfterNewTokens(StoppingCriteria):
    def __init__(self, start_length, limit):
        self.start_length = start_length
        self.limit = limit

    def __call__(self, input_ids, scores, **kwargs):
        reached = input_ids.shape[1] - self.start_length >= self.limit
        # 新版接口按 batch 返回形状为 (batch_size, 1) 的布尔张量。
        return torch.full(
            (input_ids.shape[0], 1),
            reached,
            dtype=torch.bool,
            device=input_ids.device,
        )

force_dot = LogitsProcessorList([ForceToken(dot_id)])

def new_token_count(output):
    return output.shape[1] - start_length

by_length = model.generate(
    **inputs,
    do_sample=False,
    max_new_tokens=3,
    eos_token_id=default_eos,
    pad_token_id=default_eos,
    logits_processor=force_dot,
)

by_eos = model.generate(
    **inputs,
    do_sample=False,
    max_new_tokens=10,
    eos_token_id=dot_id,
    pad_token_id=default_eos,
    logits_processor=force_dot,
)

by_string = model.generate(
    **inputs,
    do_sample=False,
    max_new_tokens=10,
    eos_token_id=default_eos,
    pad_token_id=default_eos,
    stop_strings=["."],
    tokenizer=tokenizer,
    logits_processor=force_dot,
)

by_custom = model.generate(
    **inputs,
    do_sample=False,
    max_new_tokens=10,
    eos_token_id=default_eos,
    pad_token_id=default_eos,
    logits_processor=force_dot,
    stopping_criteria=StoppingCriteriaList(
        [StopAfterNewTokens(start_length, 2)]
    ),
)

print("max_new_tokens:", new_token_count(by_length))
print("eos_token_id:", new_token_count(by_eos))
print("stop_strings:", new_token_count(by_string))
print("custom criterion:", new_token_count(by_custom))
预期输出
max_new_tokens: 3
eos_token_id: 1
stop_strings: 1
custom criterion: 2
这里把“句点”同时当作可控实验 token。第一组没有把句点设为 EOS,所以一直生成到 3 个新 token;第二组把句点设为 EOS,第一步即结束;第三组由停止字符串截断;第四组忽略句点本身,累计 2 个新 token 后由自定义条件终止。
为真实任务组合正常出口与兜底上限
生产代码不要只依赖单一条件。对开放式文本,通常至少设置 max_new_tokens,防止模型始终不产生正常结束标记;如果协议有明确结束符,再同时配置 EOS 或 stop_strings。这样“内容边界”负责尽早结束,“长度上限”负责最坏情况下收口。
停止字符串按文本匹配,适合 </answer>、双换行或固定分隔符这类协议边界;EOS 更适合模型本身训练出的结束 token。若边界依赖多 token 结构、计数器或外部状态,自定义 StoppingCriteria 更清晰,也更容易单元测试。
避免把停止条件当作内容清洗
停止条件只决定生成循环何时结束,不会自动删除已经生成的分隔符,也不会修复截断后的语法。因此下游仍要明确:是否保留停止字符串、是否需要去除尾部标记,以及 JSON、代码等结构化输出被长度上限截断时如何判错。
最稳妥的验收方式不是“看起来停了”,而是同时检查新增 token 数、结束原因和最终文本结构。只要始终保留 max_new_tokens 这一层兜底,再用 EOS、停止字符串或自定义规则表达正常边界,生成就能从“可能无限续写”变成可预测、可测试的过程。