
大模型原理与训练 / 系统课时
训练 Seq2Seq 生成任务
训练 Seq2Seq 生成任务
摘要和翻译的监督信号不是单个类别,而是一段目标文本。本篇把源文本和目标文本分别编码为模型输入与 labels,再用 AutoModelForSeq2SeqLM、动态 padding 和 Seq2SeqTrainer 完成一条可运行的最小训练链路。
学习目标
- 使用
text_target分别编码源文本与目标文本 - 用
DataCollatorForSeq2Seq处理批次 padding 与标签忽略位置 - 使用
Seq2SeqTrainer完成最小 Seq2Seq 微调并验证训练结束
Seq2Seq 样本怎样进入模型
生成任务的一条样本包含两个方向:源文本负责产生 encoder 输入,目标文本负责产生 decoder 的监督标签。以 T5 摘要为例,源文本通常带任务前缀 summarize:,目标文本则是期望模型生成的摘要。
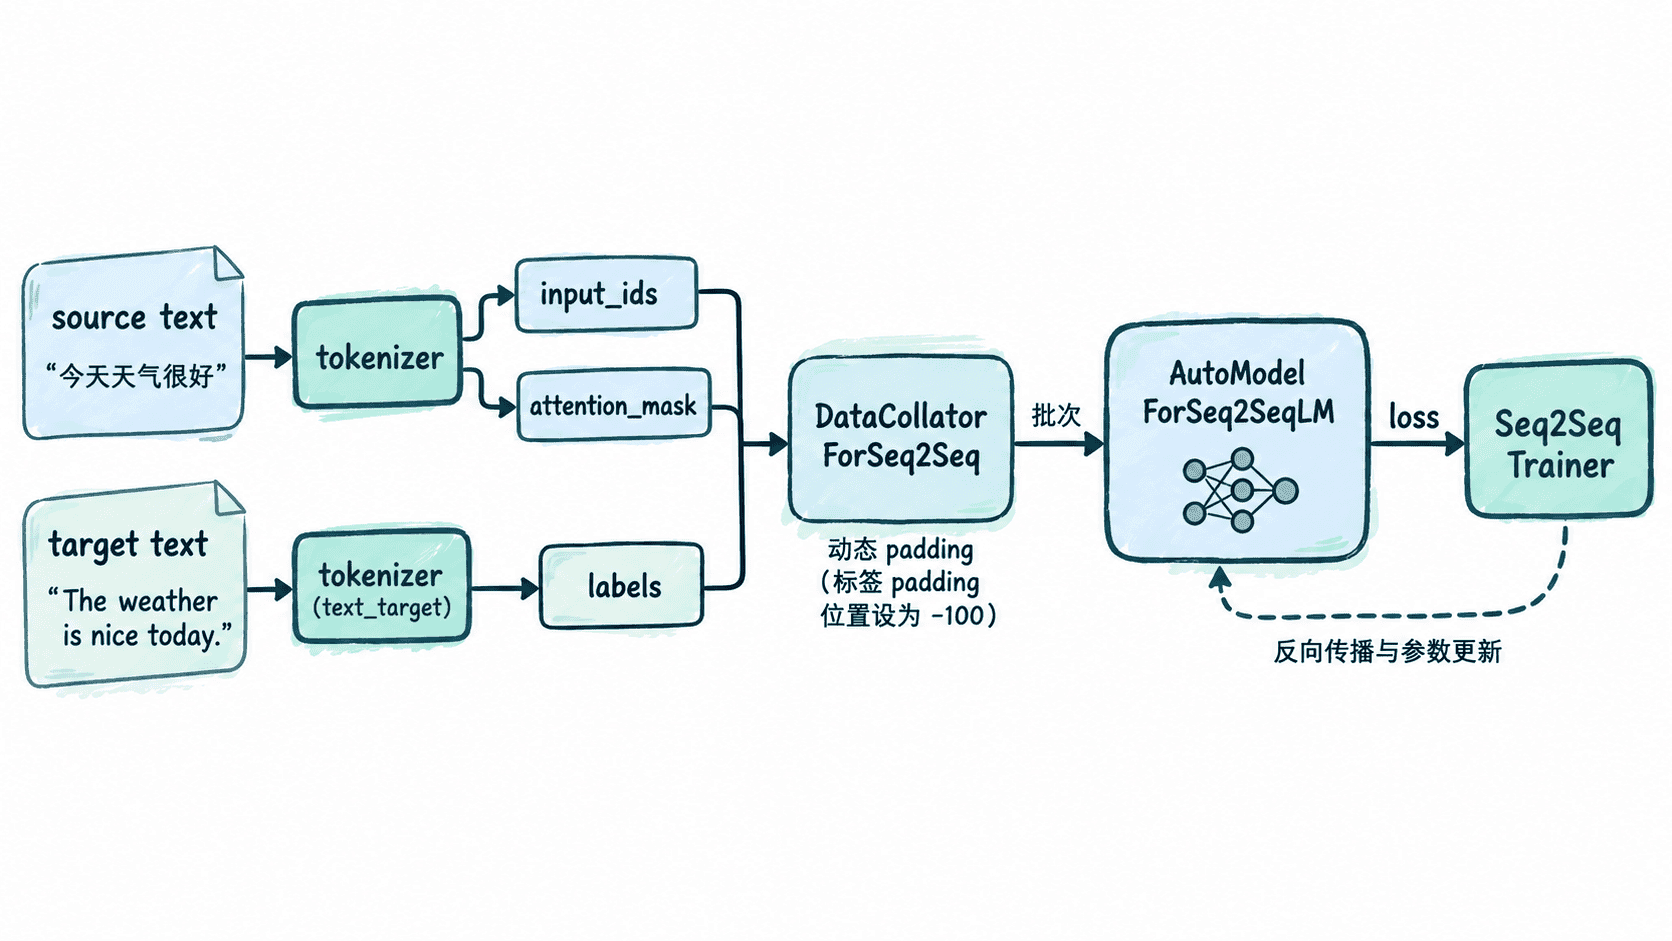
分别编码输入和目标
Transformers tokenizer 可以通过 text_target 明确编码目标文本。这样不需要手工切换 tokenizer 模式,也能让源文本与监督标签保持清晰分工。
下面用两条本地样本运行一次最小训练。首次执行会从 Hugging Face Hub 下载 t5-small 的模型和 tokenizer,需要可联网环境;已经缓存后可以直接复用本地文件。
from datasets import Dataset
from transformers import (
    AutoModelForSeq2SeqLM,
    AutoTokenizer,
    DataCollatorForSeq2Seq,
    Seq2SeqTrainer,
    Seq2SeqTrainingArguments,
)

model_name = "t5-small"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForSeq2SeqLM.from_pretrained(model_name)

dataset = Dataset.from_dict(
    {
        "source": [
            "summarize: The library released a smaller model for edge devices.",
            "summarize: The team reduced latency by caching repeated requests.",
        ],
        "target": [
            "A smaller model targets edge devices.",
            "Caching reduced request latency.",
        ],
    }
)

def preprocess(batch):
    model_inputs = tokenizer(
        batch["source"],
        max_length=64,
        truncation=True,
    )
    target_tokens = tokenizer(
        text_target=batch["target"],
        max_length=32,
        truncation=True,
    )
    model_inputs["labels"] = target_tokens["input_ids"]
    return model_inputs

tokenized = dataset.map(
    preprocess,
    batched=True,
    remove_columns=dataset.column_names,
)

data_collator = DataCollatorForSeq2Seq(
    tokenizer=tokenizer,
    model=model,
    label_pad_token_id=-100,
)

training_args = Seq2SeqTrainingArguments(
    output_dir="./seq2seq-demo",
    per_device_train_batch_size=2,
    num_train_epochs=1,
    learning_rate=5e-5,
    logging_strategy="no",
    save_strategy="no",
    report_to=[],
    disable_tqdm=True,
)

trainer = Seq2SeqTrainer(
    model=model,
    args=training_args,
    train_dataset=tokenized,
    data_collator=data_collator,
)

trainer.train()
print("train_completed=True")
预期输出
train_completed=True不同 Transformers 版本和硬件环境可能另外打印训练耗时、loss 等日志,但代码最后会输出上述固定验收行。输出目录位于当前工作目录下的 <PATH>/seq2seq-demo,实际绝对路径可能不同。
动态 padding 为什么交给 DataCollator
预处理阶段只做截断,不把所有样本提前 padding 到固定长度。DataCollatorForSeq2Seq 会在组 batch 时按当前批次的最长样本补齐 input_ids、attention_mask 和 labels,通常比全局定长 padding 更节省显存和计算量。
标签 padding 位置使用 -100,这些补齐位置便不会参与语言模型损失。如果目标序列用普通 pad token id 补齐却没有忽略,模型会被迫学习无意义的 padding 位置,loss 统计也会受到污染。
训练配置的关键边界
AutoModelForSeq2SeqLM 适用于编码器-解码器生成模型,例如 T5、BART 或 Marian。不要把它直接替换成 AutoModelForCausalLM 来训练标准 encoder-decoder 摘要任务,两类模型的输入结构与生成机制不同。
真实项目还应把数据划分为训练集和验证集,并在验证阶段对生成文本计算 ROUGE、BLEU 等任务指标。Seq2SeqTrainer 不只负责反向传播;配置生成式评估后,它还能配合 model.generate() 评估完整序列,避免只看 token 级 loss 就判断生成质量。
一条可靠的 Seq2Seq 微调链路应满足三个条件:源文本进入模型输入,目标文本只作为 labels;批次 padding 不污染损失;训练完成后再用独立验证集评估真实生成文本。