
大模型原理与训练 / 系统课时
只计算回答区间的训练损失
只计算回答区间的训练损失
监督微调时,提示词和回答通常会一起送入因果语言模型,但不代表每个 token 都应该参与优化。本节用 labels=-100 屏蔽提示词区域,只保留回答 token 的监督信号,并说明批处理、截断和聊天模板下最容易出错的边界。
学习目标
- 理解提示词 token 为什么应当从监督损失中排除
- 能构造只让回答区间参与损失计算的
labels - 能检查 padding、截断和回答起点是否被正确屏蔽
为什么要屏蔽提示词区域
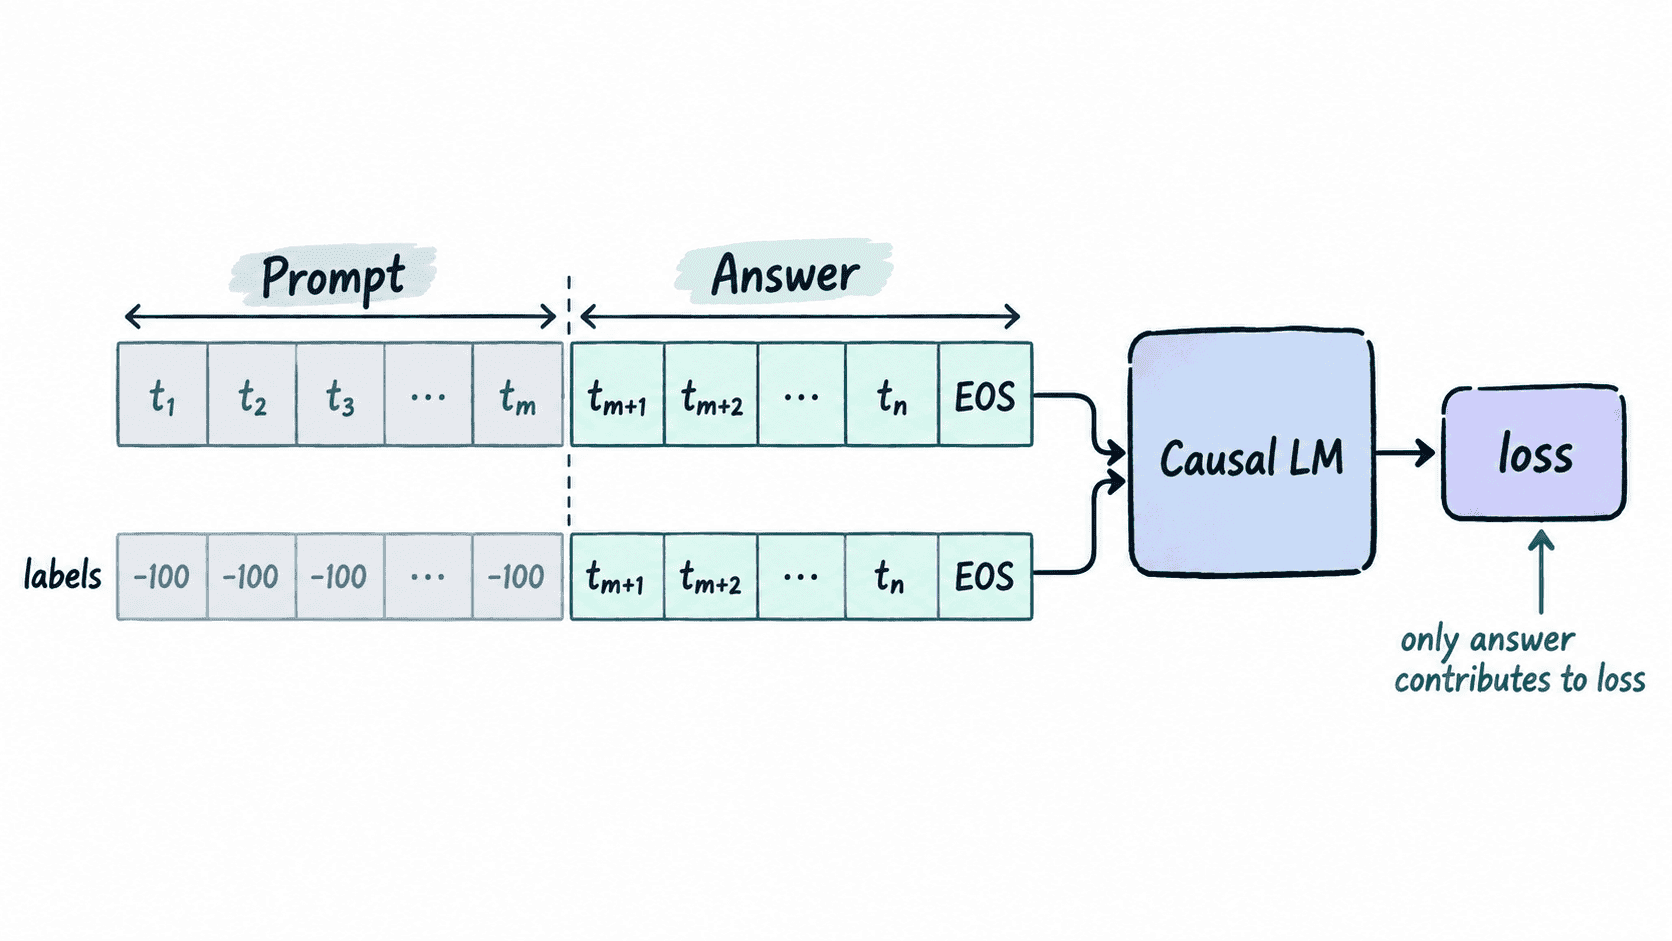
因果语言模型仍然需要看到完整提示词,因为回答必须以提示词为条件生成;需要改变的是监督目标,而不是输入。常见做法是让 input_ids 保留“提示词 + 回答”,再把提示词对应的 labels 设为 -100。PyTorch 的交叉熵会忽略这些位置,因此它们不贡献损失。
这与“删除提示词 token”完全不同。删除后模型失去条件上下文;mask 只是不要求模型复述提示词,却仍允许回答 token 通过自回归注意力读取前面的输入。
构造回答区间的 labels
下面用一个很小的 GPT-2 模型演示核心做法。示例把提示词和回答分别分词后再拼接,因此回答起点直接等于 len(prompt_ids),不会依赖字符长度猜测 token 边界。
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "sshleifer/tiny-gpt2"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id)
model.eval()

prompt = "User: Explain LoRA.\nAssistant:"
answer = " LoRA trains low-rank adapter weights."

# 训练输入保留完整上下文;EOS 也属于需要预测的回答区域。
prompt_ids = tokenizer(prompt, add_special_tokens=False)["input_ids"]
answer_ids = tokenizer(answer, add_special_tokens=False)["input_ids"]
answer_ids = answer_ids + [tokenizer.eos_token_id]

input_ids = prompt_ids + answer_ids
labels = [-100] * len(prompt_ids) + answer_ids

batch = {
    "input_ids": torch.tensor([input_ids]),
    "attention_mask": torch.ones(1, len(input_ids), dtype=torch.long),
    "labels": torch.tensor([labels]),
}

with torch.no_grad():
    outputs = model(**batch)

print("prompt_masked=", all(x == -100 for x in labels[:len(prompt_ids)]))
print("answer_kept=", labels[len(prompt_ids):] == answer_ids)
print("loss=", float(outputs.loss))
预期输出
prompt_masked= True
answer_kept= True
loss= <LOSS>
<LOSS> 是随模型权重、库版本和数值实现变化的浮点数。这里真正要验证的是前两行:提示词标签全部被屏蔽,而回答标签与回答 token 完全一致。因果语言模型通常会在 forward 内部完成 logits 与 labels 的一位移位,因此不需要手工再把标签向左移动。
放进批训练时还要处理什么
单样本成立后,批处理还要再检查 padding。若右侧填充了 pad token,那么 padding 对应的 labels 也必须设为 -100,否则模型会被迫学习预测填充符。数据整理器如果会重新根据 input_ids 生成 labels,也可能覆盖你已经做好的回答区间 mask,应确认它会保留自定义 labels。
聊天模板的另一个风险是边界错位。不要用字符串字符数推算回答起点,因为一个字符不等于一个 token。更稳妥的方式是先按模板得到实际 token 序列,再依据模板定义的 assistant 区间或明确的分段 token 化结果构造 mask。
截断时优先保护回答监督
如果样本超过最大长度,直接从右侧截断可能把回答裁掉,最终只剩一长段全部为 -100 的 labels。这样的样本没有有效监督信号。训练前应统计每条样本中 labels != -100 的 token 数,并丢弃回答为空的样本,或采用能够保留回答主体的截断策略。
检查标准很简单:模型输入仍包含生成所需的提示词上下文,但损失只覆盖你真正希望模型学习的回答 token。只要这条边界保持清晰,优化预算就不会浪费在复述提示格式上。