
大模型原理与训练 / 系统课时
合并适配器并导出模型
合并适配器并导出模型
LoRA 训练结束后,若部署端不想同时管理基座模型和适配器,就需要把增量权重合并回基座模型。本篇完成合并、保存独立模型,并用同一输入比较合并前、合并后和重新加载后的数值结果。
学习目标
- 理解
merge_and_unload()对模型结构和部署方式的影响。 - 将 LoRA 权重合并后保存为可由 Transformers 直接加载的完整模型。
- 用固定输入验证合并与重新加载前后的输出在容差内一致。
合并到底改变了什么
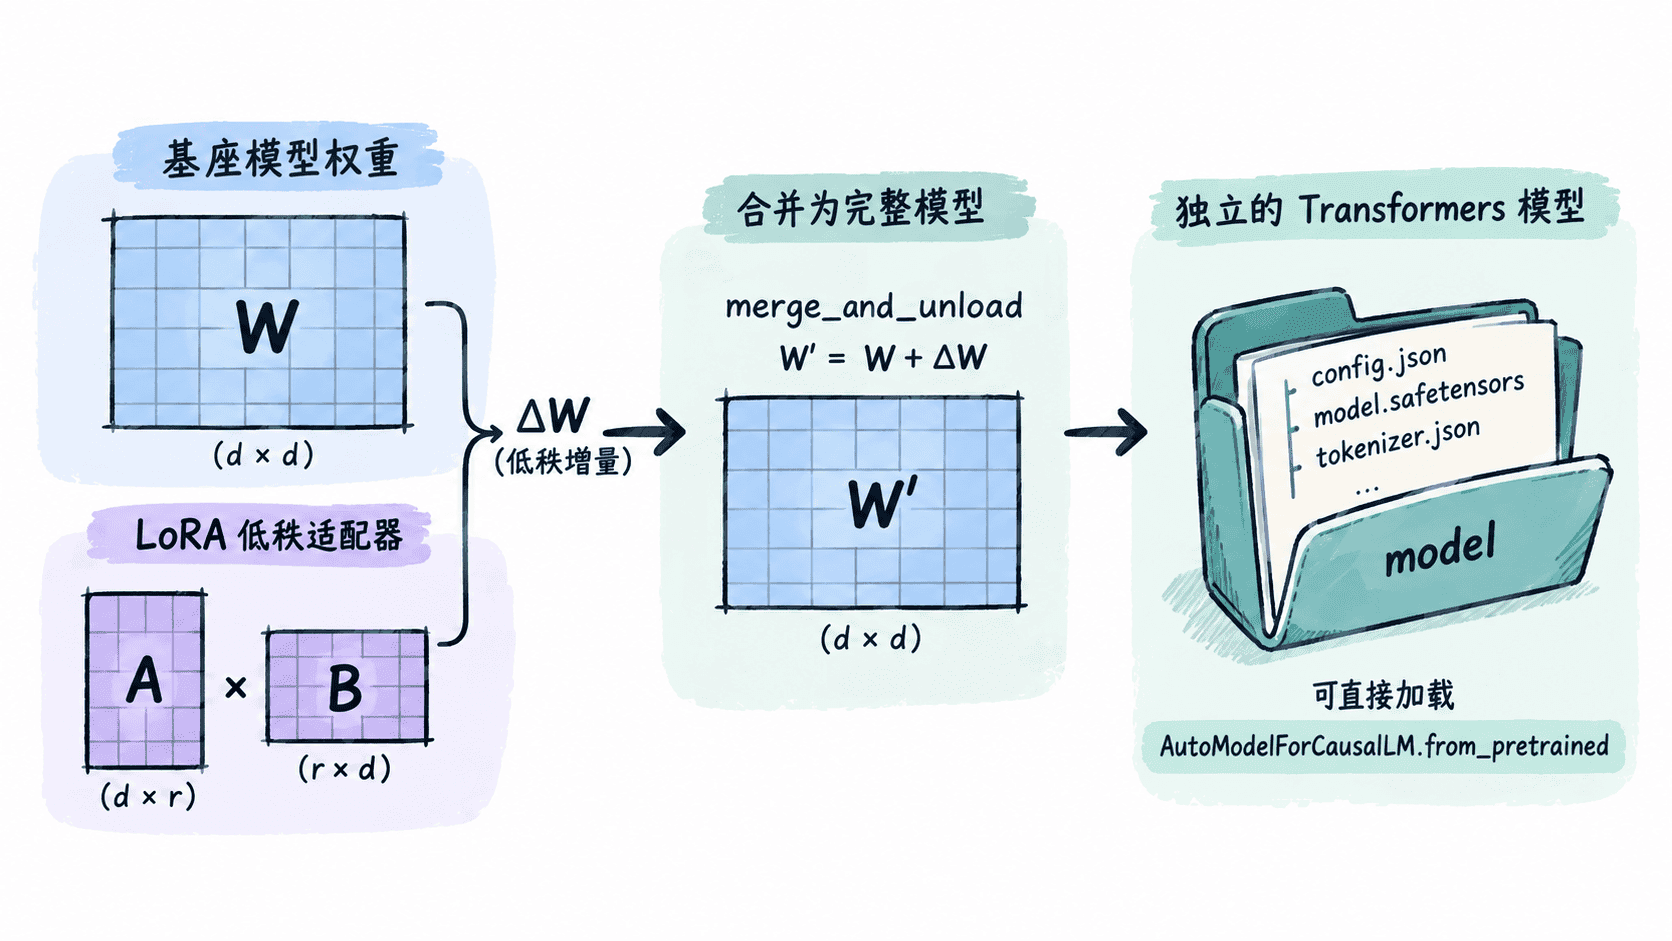
LoRA 并不会在训练时改写全部基座参数,而是在目标线性层旁增加低秩增量。推理时可以把它理解为使用 ;合并就是把这部分增量真正写回权重矩阵,再移除适配器层。
merge_and_unload() 返回的是合并后的基础模型对象,而不是继续保留完整 PEFT 管理能力的 PeftModel。因此,合并产物适合独立部署,但不再适合运行时切换、禁用或卸载 LoRA 适配器。
用同一输入完成合并与验证
下面脚本接收基座模型、LoRA 目录和导出目录。它先记录适配器模型最后一个位置的 logits,再执行安全合并;保存后只用 Transformers 重新加载导出目录,并再次比较 logits。为了让比较更稳定,示例固定使用 float32 和 eval()。
import argparse
import gc
from pathlib import Path

import torch
from peft import PeftModel
from transformers import AutoModelForCausalLM, AutoTokenizer

def last_token_logits(model, inputs):
    with torch.inference_mode():
        return model(**inputs).logits[:, -1, :].float().cpu()

parser = argparse.ArgumentParser()
parser.add_argument("--base-model", required=True)
parser.add_argument("--adapter", required=True)
parser.add_argument("--output", required=True)
parser.add_argument("--prompt", default="Explain LoRA in one sentence.")
args = parser.parse_args()

device = "cuda" if torch.cuda.is_available() else "cpu"
tokenizer = AutoTokenizer.from_pretrained(args.base_model)
base = AutoModelForCausalLM.from_pretrained(
    args.base_model,
    dtype=torch.float32,
).to(device)

peft_model = PeftModel.from_pretrained(base, args.adapter).eval()
inputs = tokenizer(args.prompt, return_tensors="pt").to(device)
before = last_token_logits(peft_model, inputs)

# safe_merge 会在合并过程中检查异常数值;返回值必须接住。
merged = peft_model.merge_and_unload(safe_merge=True).eval()
after = last_token_logits(merged, inputs)
torch.testing.assert_close(before, after, rtol=1e-4, atol=1e-5)
print("merge_check: PASS")
print(f"max_abs_diff: {(before - after).abs().max().item():.8f}")

output_dir = Path(args.output)
merged.save_pretrained(output_dir, safe_serialization=True)
tokenizer.save_pretrained(output_dir)

# 释放旧模型后,仅从导出目录加载,验证产物不再依赖 PEFT。
after_cpu = after
del peft_model, base, merged
gc.collect()
if torch.cuda.is_available():
    torch.cuda.empty_cache()

reloaded = AutoModelForCausalLM.from_pretrained(
    output_dir,
    dtype=torch.float32,
).to(device).eval()
reloaded_inputs = tokenizer(args.prompt, return_tensors="pt").to(device)
reloaded_logits = last_token_logits(reloaded, reloaded_inputs)
torch.testing.assert_close(after_cpu, reloaded_logits, rtol=1e-4, atol=1e-5)

print("reload_check: PASS")
print(f"saved_to: {output_dir}")
预期输出
merge_check: PASS
max_abs_diff: <DIFF>
reload_check: PASS
saved_to: <PATH>
<DIFF> 是浮点计算产生的实际最大差值,<PATH> 是你传入的导出目录;二者会随环境变化。脚本若在两次 assert_close 任一处失败,会直接抛出异常,而不是继续把未经验证的模型当作可发布产物。
判断导出物是否真的独立
最关键的验收不是“目录里文件很多”,而是导出目录能否只通过 AutoModelForCausalLM.from_pretrained() 加载。上面的重新加载步骤没有调用 PeftModel.from_pretrained(),因此它同时验证了模型配置、完整权重和 tokenizer 已能作为一个独立产物使用。
合并后磁盘占用通常会明显大于单独的 LoRA 适配器,因为现在保存的是完整模型权重。若权重被分片,目录中可能出现多个 safetensors 分片和索引文件,这仍然属于正常的 Transformers 模型产物。
处理合并时的边界
merge_and_unload() 适合“部署只要一个模型”的场景;如果仍要切换多个适配器、临时禁用 LoRA 或继续做 PEFT 操作,就应保留原始基座与适配器,不要只留下合并模型。
量化模型需要额外谨慎。某些量化方式或 PEFT 配置并不支持直接合并,或需要先以可合并精度重新加载基座权重。发布前应以目标推理精度重跑验证,而不是把训练阶段能加载等同于合并一定安全。
完成合并后,至少保留原始适配器、基座模型标识、训练配置和一次验证记录。这样既能获得独立部署产物,也保留了重新合并与追溯训练来源的能力。