
大模型原理与训练 / 系统课时
复用 KV Cache 加速自回归生成
复用 KV Cache 加速自回归生成
自回归模型每生成一个 token 都要再次执行注意力计算。KV Cache 的价值是保留历史 token 在各层产生的 Key/Value,只计算新增 token,从而降低长上下文解码的重复工作。本节用 past_key_values 对比完整重算与增量解码,并说明跨轮复用的边界。
学习目标
- 解释 KV Cache 为什么能减少历史 token 的重复计算
- 使用
past_key_values完成一次增量解码并验证结果一致性 - 判断长对话中哪些前缀可以安全复用,哪些变化会让缓存失效
KV Cache 省掉了什么
在因果语言模型里,新 token 的 Query 需要关注此前所有 token,但历史 token 对应的 Key/Value 在模型参数不变时不会因为“又生成了一个 token”而改变。没有缓存时,每一步都会重新计算整段历史的 K/V;启用缓存后,只为新增 token 计算新的 K/V,再把它追加到每一层的缓存中。
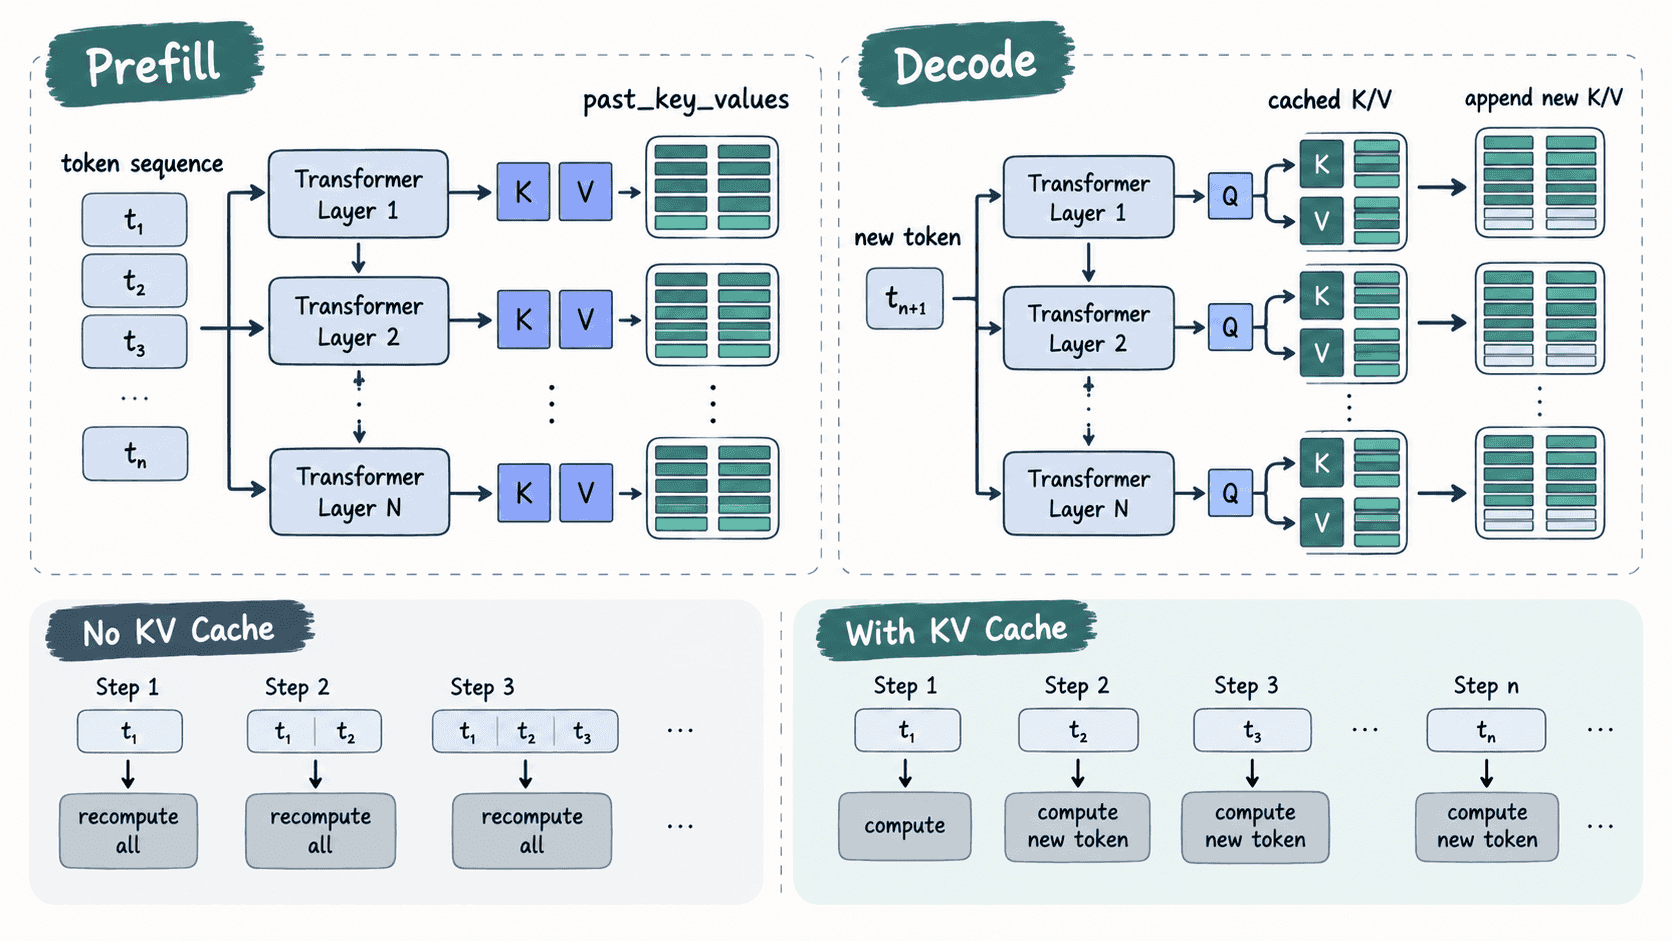
缓存降低的是历史 K/V 的重复投影计算,并不会让长上下文成本消失。序列越长,注意力仍要读取更多历史 K/V,缓存本身也会占用显存;因此它通常用显存换解码时延。
past_key_values 的复用规则
在 Transformers 中,模型以 use_cache=True 前向时会返回 past_key_values。下一次前向把这份缓存传回模型,并只提交尚未处理的新 token,就能延续同一前缀。generate() 通常会在单次生成内部自动管理缓存;需要跨调用保留前缀时,才更常直接管理 past_key_values 或显式 Cache 对象。
一份缓存只对应“某个模型参数状态下的一段精确 token 前缀”。系统提示词、历史消息、分词结果或模型权重发生变化后,旧缓存不能直接套用。多分支生成也不能让多个分支任意共享同一份会继续增长的可变缓存,应为分支保留独立状态。
验证增量解码
下面用 distilgpt2 先对历史前缀做一次 prefill,再预测一个 token。随后分别用“完整前缀 + 新 token”重算,以及用 past_key_values 只处理这个新 token,并比较下一位置的 logits。
import time

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id)
model.eval()

prompt = ("KV cache avoids recomputing old tokens during autoregressive decoding. " * 24).strip()
inputs = tokenizer(prompt, return_tensors="pt")

with torch.inference_mode():
    # Prefill 一次历史前缀,同时得到可复用的缓存。
    prefill = model(**inputs, use_cache=True)
    next_token = prefill.logits[:, -1, :].argmax(dim=-1, keepdim=True)

    extended_ids = torch.cat([inputs["input_ids"], next_token], dim=-1)

    start = time.perf_counter()
    full = model(input_ids=extended_ids, use_cache=False)
    full_ms = (time.perf_counter() - start) * 1000

    start = time.perf_counter()
    cached = model(
        input_ids=next_token,
        past_key_values=prefill.past_key_values,
        use_cache=True,
    )
    cached_ms = (time.perf_counter() - start) * 1000

same = torch.allclose(
    full.logits[:, -1, :],
    cached.logits[:, -1, :],
    atol=1e-4,
    rtol=1e-4,
)

print("history tokens:", inputs["input_ids"].shape[1])
print("full-recompute input tokens:", extended_ids.shape[1])
print("cached-step input tokens:", next_token.shape[1])
print("logits close:", same)
print(f"full-recompute: {full_ms:.2f} ms")
print(f"cached-step: {cached_ms:.2f} ms")
预期输出
history tokens: <N>
full-recompute input tokens: <N_PLUS_1>
cached-step input tokens: 1
logits close: True
full-recompute: <TIME> ms
cached-step: <TIME> ms
<N> 由分词结果决定,<TIME> 由 CPU/GPU、线程数和热身状态决定。关键验证点不是固定毫秒数,而是缓存路径只输入 1 个新 token,且 logits 与完整重算在浮点误差范围内一致。正式测时应先热身并重复多轮取中位数;上下文越长,避免重算的收益通常越明显。
在长对话中持续复用
多轮对话适合把“已经确认且不会再修改的历史”视为稳定前缀。每生成完一轮,就让缓存继续包含这轮新增 token;下一条用户消息到达后,只对新消息对应 token 做增量处理。这样对话越长,越能避免反复 prefill 同一段历史。
如果服务端会裁剪历史、改写 system prompt、插入工具结果到旧位置,或对消息模板重新分词,就要从发生变化的位置之后重建缓存。带 padding 的批处理还要同步维护正确的 attention_mask 与位置关系,不能只保存 K/V 而忽略序列布局。
什么时候缓存反而受限
KV Cache 的主要代价是显存随批大小和有效上下文增长。显存紧张时,可以缩短上下文、减小 batch size,或评估静态、量化、offload 等缓存策略;使用滑动窗口注意力的模型还可能只保留有限窗口。性能判断应同时看 prefill 时延、单 token 解码时延、缓存显存和上下文长度,而不是只看“是否开启 cache”。
当历史前缀稳定、生成 token 较多时,复用缓存通常是最直接的解码优化;当请求短、前缀频繁变化或显存成为瓶颈时,则应把缓存收益与内存成本一起评估。