
大模型原理与训练 / 系统课时
按长度与批大小调优吞吐
按长度与批大小调优吞吐
推理吞吐不是 batch 越大越好。不同长度请求混在同一批次会产生 padding,batch 继续增大又会放大激活与 KV Cache 占用,最终可能触发 OOM。本节用按 token 长度排序组批的基准脚本,同时记录 padding 浪费、请求吞吐和峰值显存,找到更可靠的 batch size。
学习目标
- 计算批内 padding 浪费并理解它为何会吞掉有效算力
- 按 token 长度组批,再对多个 batch size 做可重复基准
- 结合吞吐、峰值显存、GPU 利用率与 OOM 边界选择工作点
吞吐由三股力量共同决定
批处理把多个序列拼成矩形张量,实际计算宽度由批内最长序列决定。若长度分别是 32、35、40、220,前三条都要补到 220;这些 padding 不承载业务信息,却仍可能占用张量计算与内存带宽。把相近长度请求放到同一批次,通常能直接减少浪费。
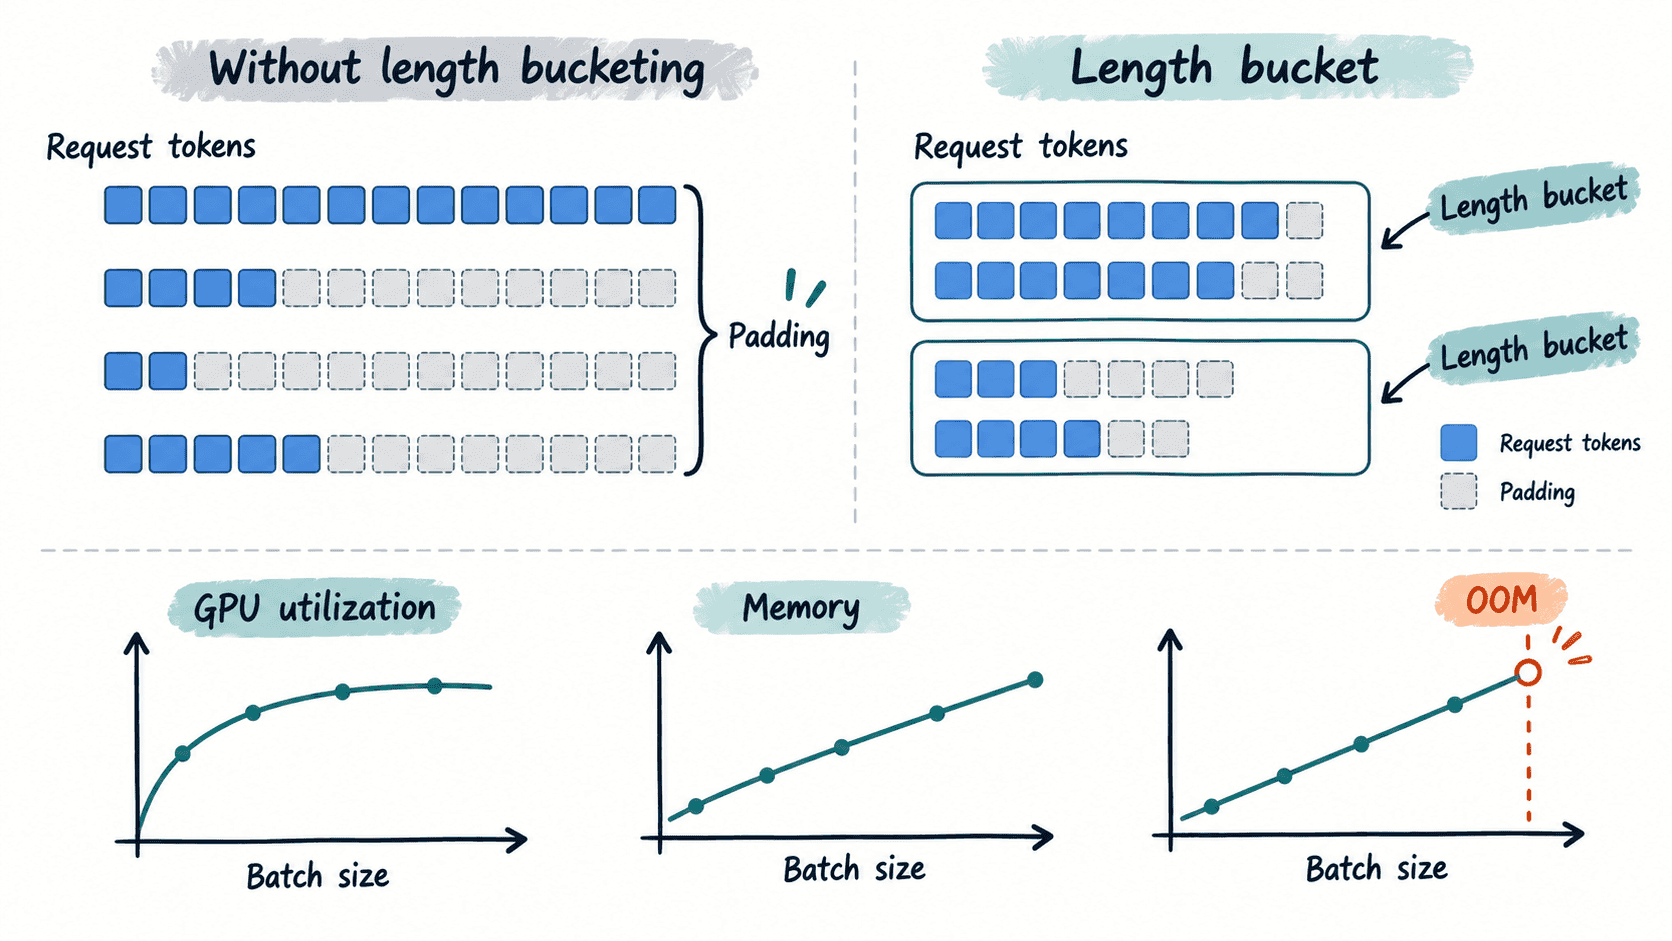
另一方面,小 batch 往往无法把 GPU 并行能力吃满;增加 batch size 后,请求吞吐会先上升,但显存占用同步增加。当吞吐增长趋平、单请求延迟超出目标,或再增大一级就 OOM 时,继续放大 batch 通常没有意义。生成任务还会受输出长度差异影响:已经结束的请求会让批内剩余序列形成“拖尾”。
先按 token 长度组批
长度分桶应基于 tokenizer 后的 token 数,而不是字符数。生产系统常按长度区间建 bucket,例如 1~128、129~256、257~512,再在每个 bucket 内凑批;低流量场景则要设置最长等待时间,避免为了凑满 batch 牺牲尾延迟。
一个直观指标是 padding 比例:1 - 有效 token 数 / 张量 token 槽位数。同样的模型和 batch size 下,这个比例越低,越多算力真正用于请求内容。
跑一组可比较的基准
下面脚本固定生成 16 个新 token,先比较原始顺序与按长度排序后的 batch=4,再在分组后的请求上扫描 batch size。若有 CUDA,会额外记录 PyTorch 看到的峰值显存;如果某档触发 OOM,脚本会清理缓存并继续报告。
import time

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "distilgpt2"
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

tokenizer = AutoTokenizer.from_pretrained(model_id)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "left"

model = AutoModelForCausalLM.from_pretrained(model_id).to(device)
model.generation_config.pad_token_id = tokenizer.pad_token_id
model.eval()

repeat_counts = [1, 12, 2, 24, 4, 16, 8, 20]
prompts = [
    ("Transformers inference should batch requests efficiently. " * n).strip()
    for n in repeat_counts
]
lengths = [len(tokenizer(p, add_special_tokens=False)["input_ids"]) for p in prompts]

original_order = list(range(len(prompts)))
grouped_order = sorted(original_order, key=lambda i: lengths[i])


def sync():
    if device.type == "cuda":
        torch.cuda.synchronize()


def benchmark(order, batch_size):
    if device.type == "cuda":
        torch.cuda.empty_cache()
        torch.cuda.reset_peak_memory_stats()

    elapsed = 0.0
    total_requests = 0
    real_tokens = 0
    tensor_slots = 0

    for start in range(0, len(order), batch_size):
        ids = order[start : start + batch_size]
        batch_prompts = [prompts[i] for i in ids]
        encoded = tokenizer(batch_prompts, return_tensors="pt", padding=True)
        real_tokens += int(encoded["attention_mask"].sum())
        tensor_slots += encoded["input_ids"].numel()
        encoded = {k: v.to(device) for k, v in encoded.items()}

        sync()
        t0 = time.perf_counter()
        with torch.inference_mode():
            model.generate(
                **encoded,
                do_sample=False,
                min_new_tokens=16,
                max_new_tokens=16,
                use_cache=True,
            )
        sync()
        elapsed += time.perf_counter() - t0
        total_requests += len(ids)

    padding_pct = 100 * (1 - real_tokens / tensor_slots)
    throughput = total_requests / elapsed
    peak_mb = (
        torch.cuda.max_memory_allocated() / 1024**2
        if device.type == "cuda"
        else None
    )
    return padding_pct, throughput, peak_mb


def show(label, order, batch_size):
    try:
        padding, throughput, peak = benchmark(order, batch_size)
        peak_text = f"{peak:.0f} MB" if peak is not None else "n/a"
        print(
            f"{label}: bs={batch_size}, padding={padding:.1f}%, "
            f"throughput={throughput:.2f} req/s, peak={peak_text}"
        )
    except torch.OutOfMemoryError:
        if device.type == "cuda":
            torch.cuda.empty_cache()
        print(f"{label}: bs={batch_size}, OOM")


print("device:", device)
print("compare grouping")
show("original", original_order, 4)
show("grouped", grouped_order, 4)

print("sweep grouped batches")
for bs in [1, 2, 4, 8]:
    show("grouped", grouped_order, bs)
预期输出
device: <DEVICE>
compare grouping
original: bs=4, padding=<PADDING>%, throughput=<THROUGHPUT> req/s, peak=<MEMORY>
grouped: bs=4, padding=<PADDING>%, throughput=<THROUGHPUT> req/s, peak=<MEMORY>
sweep grouped batches
grouped: bs=1, padding=<PADDING>%, throughput=<THROUGHPUT> req/s, peak=<MEMORY>
grouped: bs=2, padding=<PADDING>%, throughput=<THROUGHPUT> req/s, peak=<MEMORY>
grouped: bs=4, padding=<PADDING>%, throughput=<THROUGHPUT> req/s, peak=<MEMORY>
grouped: bs=8, padding=<PADDING>%, throughput=<THROUGHPUT> req/s, peak=<MEMORY><DEVICE>、<PADDING>、<THROUGHPUT> 和 <MEMORY> 会随硬件、软件版本与 tokenizer 结果变化;某一档也可能直接显示 OOM。应先做一次热身,再把整组测试重复多轮取中位数。这个脚本展示的是方法,不应把示例机器上的 batch size 直接搬到生产环境。
选最佳 batch size
调参时先固定模型、精度、输入长度分布、最大新 token 数和生成策略,否则不同实验不可比较。然后从小 batch 开始逐级加倍,记录请求吞吐、生成 token 吞吐、峰值显存和端到端延迟。GPU 环境还应同时观察实际利用率:如果利用率仍低而显存富余,可以继续放大 batch;如果利用率已经较高但吞吐几乎不再增长,继续放大通常只会增加排队和内存压力。
| 观察到的信号 | 更可能的动作 |
|---|---|
| padding 高、长度离散 | 先做长度分桶,再谈增大 batch |
| GPU 利用率低、显存富余 | 尝试增大 batch |
| 吞吐增长趋平、延迟明显上升 | 回退到前一档 |
| 峰值显存逼近上限或出现 OOM | 减小 batch,缩短长度或降低缓存占用 |
| 长请求拖慢整批 | 缩小 bucket 范围或限制每批 token 总量 |
生产服务比离线基准多一个约束:请求到达是随机的。最佳策略往往不是固定“每批 N 条”,而是同时设置最大 batch size、每批最大 token 数和最长凑批等待时间。这样既能控制 OOM,也能避免为了追求吞吐让短请求长时间等待。
最终应选择满足延迟目标且留有显存余量的最高稳定吞吐点,而不是测试中勉强跑过的最大 batch。长度分桶先减少无效计算,batch size 再提高并行度,两者结合才是更稳健的吞吐调优方式。