
大模型原理与训练 / 系统课时
排查 NaN 与梯度异常
排查 NaN 与梯度异常
训练一旦出现 loss=NaN、梯度变成 inf 或参数突然发散,继续调超参数只会掩盖根因。本节建立一条可复用的定位顺序:先确认数据与损失输入,再检查学习率、混合精度和梯度范数,最后用故障注入验证诊断脚本确实能抓住异常。
学习目标
- 用有限值检查和梯度范数定位 NaN 首次出现的位置
- 区分数据异常、学习率过高、混合精度溢出与梯度爆炸
- 在修复后用同一套检查确认训练重新稳定
先判断异常发生在哪一层
不要从“换优化器”开始试错。NaN 通常沿着“输入数据 → 前向计算 → loss → 反向梯度 → 参数更新”传播,越早发现第一个非有限值,根因范围越小。
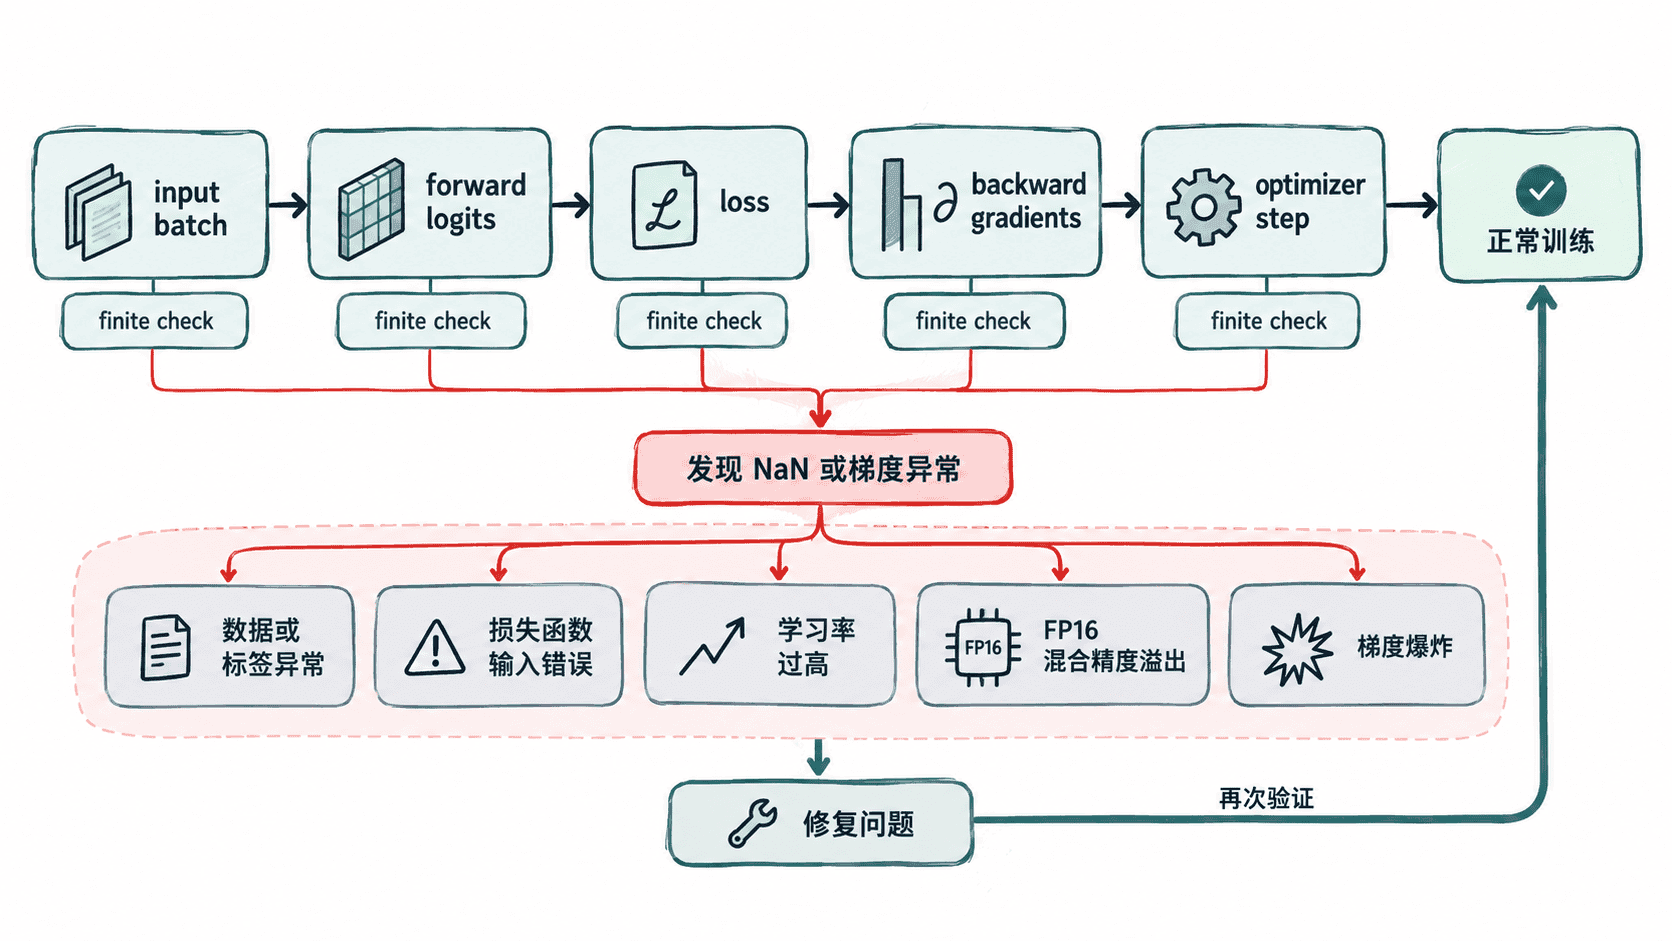
实际排查时先记录“第一个坏掉的量”。如果输入已经含 NaN,就不必研究优化器;如果 loss 有限而 backward 后梯度才变坏,重点转向数值精度、学习率和梯度裁剪。
用最小诊断脚本抓住非有限值
下面的脚本使用一个很小的 BERT 分类模型做单步训练,并在 loss 与每个参数梯度上执行 torch.isfinite 检查。--inject-nan 只用于故障注入,证明检测逻辑真的能拦住非有限值;真实训练中不要保留这段注入代码。
import argparse
import math

import torch
from torch.optim import AdamW
from transformers import AutoModelForSequenceClassification, AutoTokenizer

MODEL_ID = "hf-internal-testing/tiny-random-bert"
TEXTS = ["good example", "bad example"]
LABELS = torch.tensor([1, 0])

def check_gradients(model):
    bad = []
    total_sq = 0.0
    for name, param in model.named_parameters():
        if param.grad is None:
            continue
        grad = param.grad.detach()
        if not torch.isfinite(grad).all():
            bad.append(name)
        total_sq += grad.float().pow(2).sum().item()
    return bad, math.sqrt(total_sq)

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--inject-nan", action="store_true")
    args = parser.parse_args()

    torch.manual_seed(7)
    tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
    model = AutoModelForSequenceClassification.from_pretrained(
        MODEL_ID,
        num_labels=2,
    )
    optimizer = AdamW(model.parameters(), lr=5e-5)

    batch = tokenizer(TEXTS, padding=True, truncation=True, return_tensors="pt")
    batch["labels"] = LABELS

    optimizer.zero_grad(set_to_none=True)
    outputs = model(**batch)
    loss = outputs.loss

    # 故障注入只用于验证监控链路,模拟 forward/loss 阶段出现非有限值。
    if args.inject_nan:
        loss = loss * torch.tensor(float("nan"))

    if not torch.isfinite(loss):
        print("non-finite loss detected before backward")
        return

    loss.backward()
    bad_grads, grad_norm = check_gradients(model)
    print(f"loss={loss.item():.6f} grad_norm={grad_norm:.6f}")

    if bad_grads:
        print("non-finite gradients:", bad_grads[:5])
        return

    torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
    optimizer.step()
    print("optimizer step completed")

if __name__ == "__main__":
    main()
先运行故障注入模式:
python debug_nan.py --inject-nan预期输出:
non-finite loss detected before backward这说明监控能在 backward() 之前截住异常,而不是等参数被污染后才发现。
按顺序排除常见根因
第一优先级是数据与标签。检查输入张量是否包含 NaN 或 inf,分类标签是否落在合法类别范围,回归目标是否有极端离群值。自定义损失函数还要确认没有对零取对数、除以接近零的值,或把已经归一化后的概率再次当成 logits 使用。
第二优先级是学习率和梯度范数。如果 loss 在数步内快速放大,同时梯度范数持续飙升,先把学习率降低一个数量级,再观察曲线,而不是仅靠更强的梯度裁剪掩盖问题。梯度裁剪适合限制偶发尖峰,但不能修复错误数据或错误损失。
第三优先级是混合精度。仅在 FP16 下出现异常时,可先暂时关闭自动混合精度做对照;硬件支持时也可尝试 BF16,因为它的指数范围通常更宽。若 FP32 稳定而 FP16 不稳定,重点检查 loss scaling、极端激活值和自定义算子的数值范围。
修复后用同一检查验收
去掉故障注入参数再次运行同一脚本:
python debug_nan.py预期输出:
loss=<LOSS> grad_norm=<GRAD_NORM>
optimizer step completed
<LOSS> 和 <GRAD_NORM> 会随模型版本和运行环境略有差异,但两者都应是有限数。真实训练中还应连续观察若干 step:loss 不出现非有限值、梯度范数没有持续失控、参数更新能够继续完成,才算真正修复,而不是只让报错暂时消失。