
大模型原理与训练 / 系统课时
接入自定义指标与回调
接入自定义指标与回调
训练 loss 只能说明优化目标是否下降,不能替代任务指标,也不能告诉你何时应该记录、告警或停止训练。本节把 compute_metrics 与 TrainerCallback 接到同一条评估链路中,并用一个可重复的早停实验验证回调如何影响训练控制。
学习目标
- 用
compute_metrics把模型输出转换为任务指标 - 在
TrainerCallback的评估事件中读取指标与训练状态 - 配置早停所需的评估、保存和最佳指标条件
指标与回调处在不同位置
compute_metrics 负责“算出什么”:评估完成后,它接收预测结果和标签,返回如 accuracy、f1 等字典。回调负责“指标出现后做什么”:例如打印日志、写入外部系统,或修改训练控制状态。
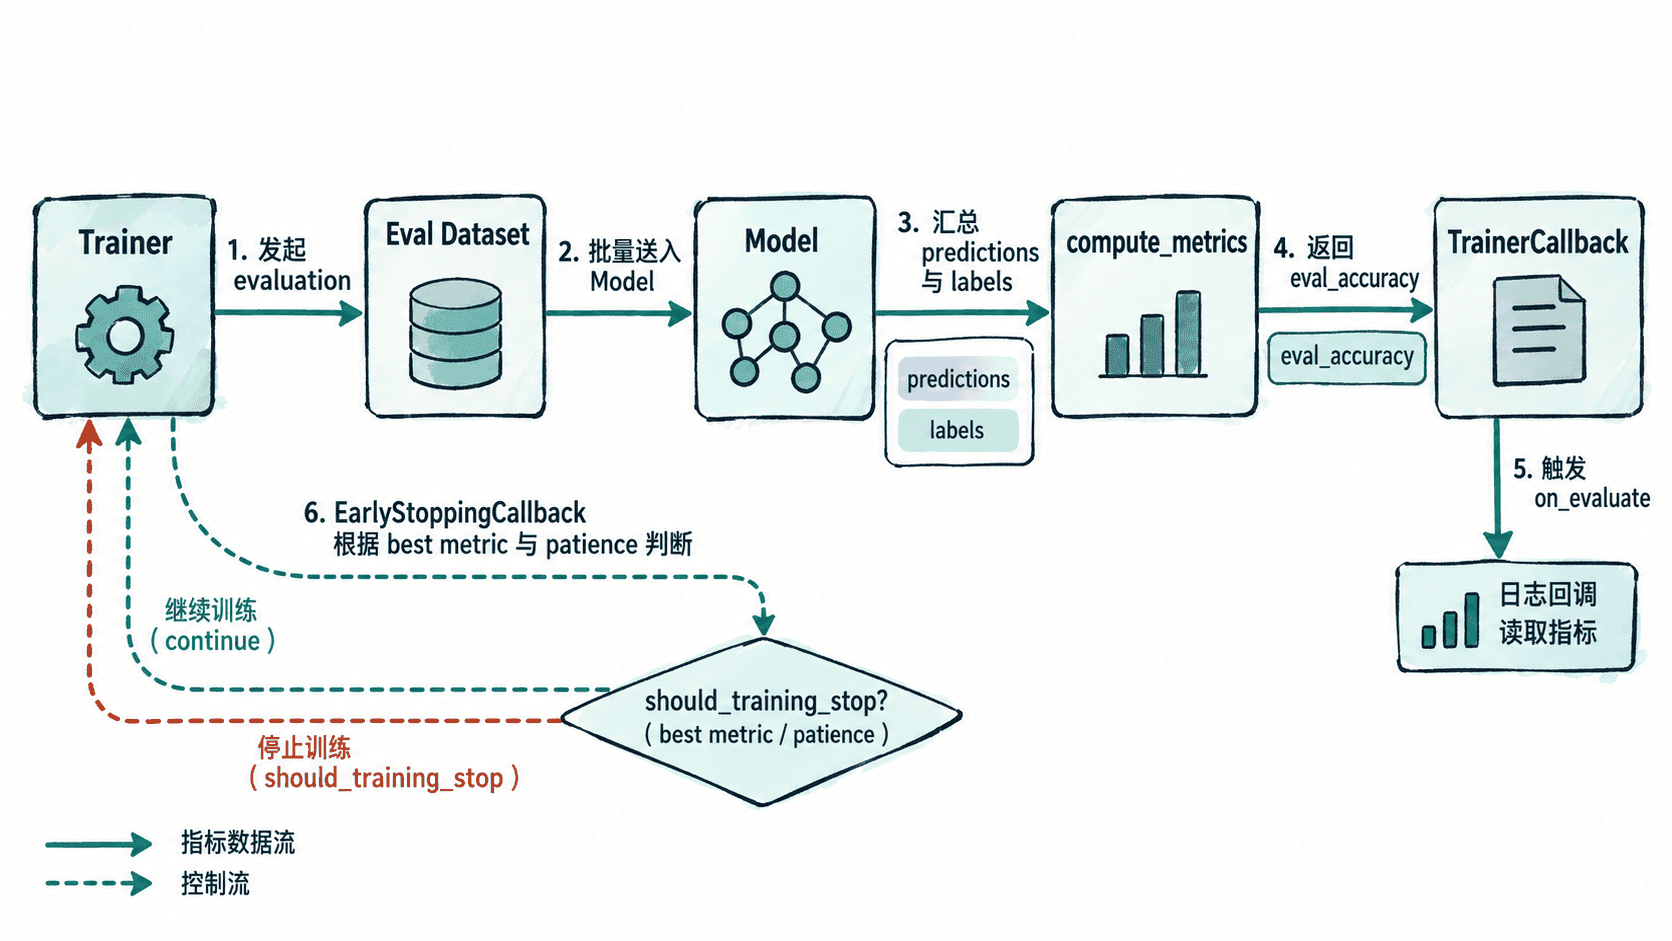
这两者不要混在一起:指标函数应尽量保持纯计算,避免写文件或修改训练状态;副作用和流程控制放进回调,更容易测试,也更容易在不同训练任务中复用。
同时接入 accuracy、日志与早停
下面仍使用小型随机模型和合成数据。为了让早停现象稳定复现,示例故意把学习率设为 0.0,使评估指标保持不变;真实微调时应换回正常学习率。
import shutil
from pathlib import Path

import torch
from torch.utils.data import Dataset
from transformers import (
    BertConfig,
    BertForSequenceClassification,
    EarlyStoppingCallback,
    PrinterCallback,
    Trainer,
    TrainerCallback,
    TrainingArguments,
)

class TinyDataset(Dataset):
    def __init__(self, size: int):
        self.input_ids = torch.randint(0, 100, (size, 8))
        self.attention_mask = torch.ones_like(self.input_ids)
        self.labels = (self.input_ids[:, 0] % 2).long()

    def __len__(self):
        return len(self.labels)

    def __getitem__(self, index):
        return {
            "input_ids": self.input_ids[index],
            "attention_mask": self.attention_mask[index],
            "labels": self.labels[index],
        }

def compute_metrics(eval_pred):
    predictions = eval_pred.predictions.argmax(axis=-1)
    labels = eval_pred.label_ids
    accuracy = (predictions == labels).mean()
    return {"accuracy": float(accuracy)}

class AccuracyTraceCallback(TrainerCallback):
    def on_evaluate(self, args, state, control, metrics=None, **kwargs):
        if metrics and "eval_accuracy" in metrics:
            value = metrics["eval_accuracy"]
            print(f"[metric] step={state.global_step} accuracy={value:.3f}")
        return control

torch.manual_seed(42)
output_dir = Path("./callback-demo")
shutil.rmtree(output_dir, ignore_errors=True)

model = BertForSequenceClassification(
    BertConfig(
        vocab_size=100,
        hidden_size=32,
        num_hidden_layers=1,
        num_attention_heads=4,
        intermediate_size=64,
        num_labels=2,
    )
)

args = TrainingArguments(
    output_dir=str(output_dir),
    num_train_epochs=5,
    per_device_train_batch_size=4,
    per_device_eval_batch_size=8,
    learning_rate=0.0,
    eval_strategy="epoch",
    save_strategy="epoch",
    load_best_model_at_end=True,
    metric_for_best_model="accuracy",
    greater_is_better=True,
    save_total_limit=2,
    logging_strategy="no",
    report_to="none",
    disable_tqdm=True,
)

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=TinyDataset(16),
    eval_dataset=TinyDataset(8),
    compute_metrics=compute_metrics,
    callbacks=[
        AccuracyTraceCallback(),
        EarlyStoppingCallback(early_stopping_patience=1),
    ],
)
trainer.remove_callback(PrinterCallback)
trainer.train()

print("stopped_epoch:", int(trainer.state.epoch))
print("has_best_metric:", trainer.state.best_metric is not None)
预期输出
[metric] step=4 accuracy=<VALUE>
[metric] step=8 accuracy=<VALUE>
stopped_epoch: 2
has_best_metric: True
<VALUE> 取决于随机初始化后的固定预测,但两次评估值应相同。第一次评估建立最佳指标,第二次没有改善;early_stopping_patience=1 因而在第二个 epoch 后停止,而不是跑满配置的 5 个 epoch。
让指标名和最佳模型策略一致
compute_metrics 返回 {"accuracy": ...} 后,评估日志中的键会带上 eval_ 前缀,因此回调读取 eval_accuracy;而 metric_for_best_model 可以直接写 accuracy。对于越小越好的指标,例如错误率或某些 loss,应把 greater_is_better 设为 False。
使用早停时,评估必须实际发生;同时让 eval_strategy 与 save_strategy 保持相同节奏,才能让“当前评估结果、最佳检查点、最终加载的模型”对应起来。若按 step 评估,还应让保存点覆盖评估点,避免已经判断出更优指标却没有对应检查点。
回调适合做副作用,不适合重写训练数学
日志、告警、早停和定期检查属于事件响应,适合放进 TrainerCallback。如果需求是修改 loss、改变优化器更新方式或插入新的前向计算,应该覆写 Trainer 的相应方法,而不是在回调中偷偷改模型参数。
把指标计算保持为纯函数、把流程副作用集中到回调,再用 TrainingArguments 约束评估和保存节奏,训练过程就同时具备可比较的任务指标、可观察事件和明确的停止条件。