
大模型原理与训练 / 系统课时
测量吞吐延迟与显存
测量吞吐延迟与显存
推理优化前先建立可信基线。本节用固定长度输入、预热和多轮测量,把首 token 延迟、总延迟、生成吞吐与峰值显存分开记录,避免把模型加载、CUDA 异步执行或偶然抖动误算成优化收益。
学习目标
- 设计可重复的预热、固定输入长度和多轮测量流程
- 正确测量 TTFT、总延迟、生成 tokens/s 与峰值显存
- 识别同步、缓存和统计口径造成的基准测试偏差
先固定测量口径
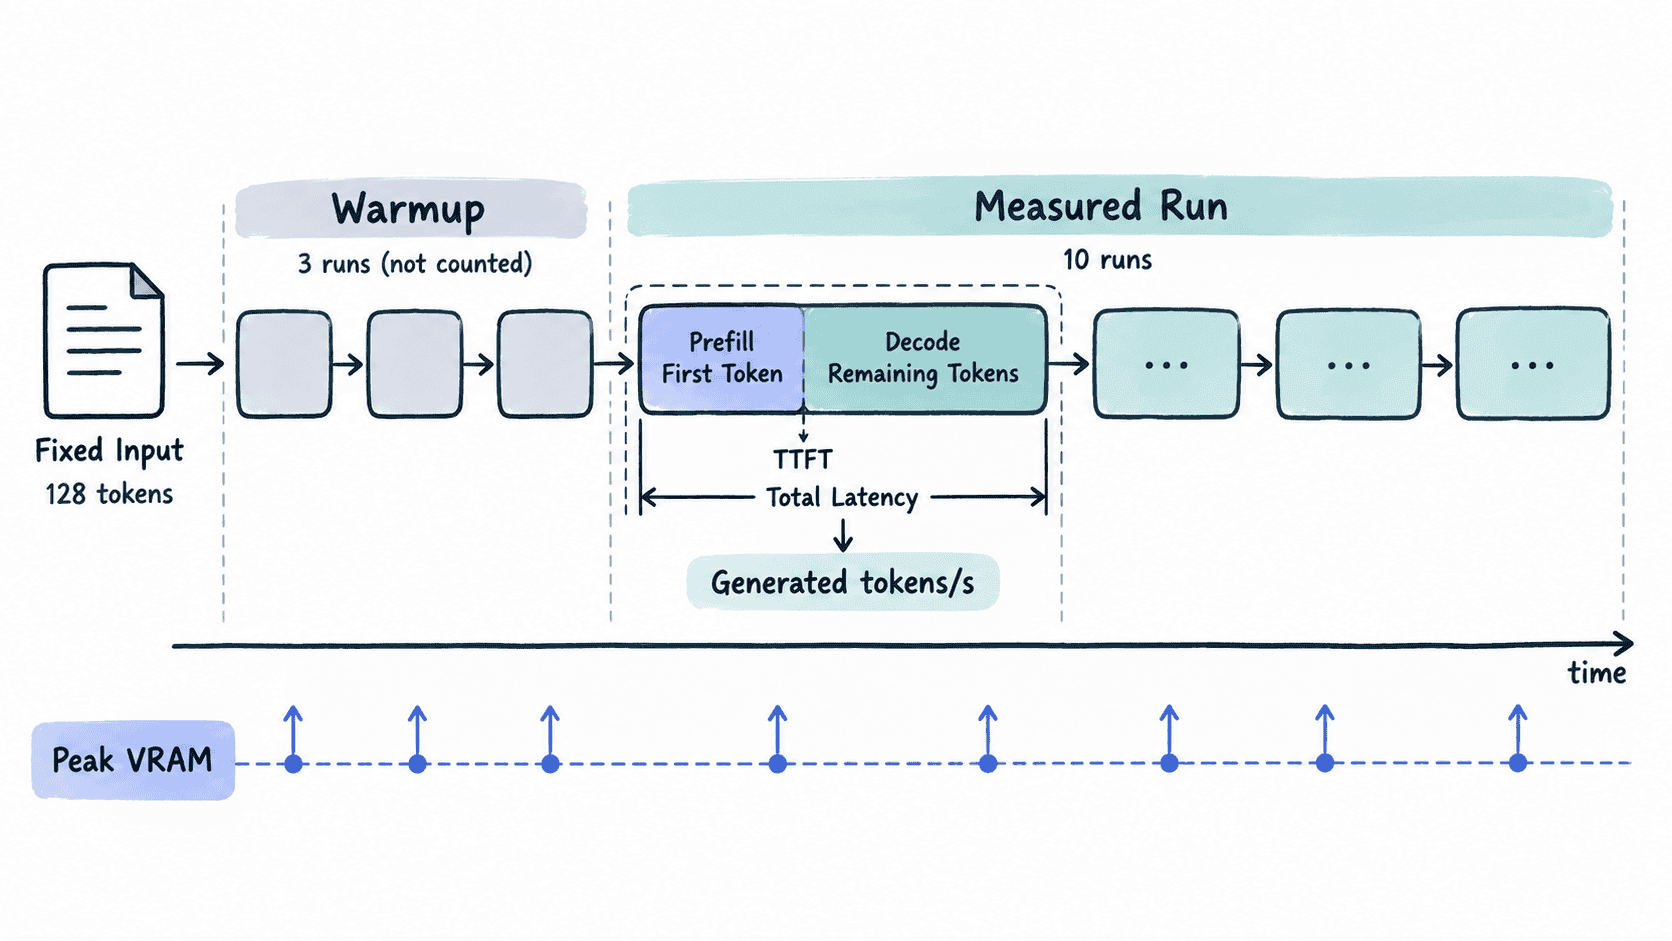
比较两个方案时,模型、输入 token 数、max_new_tokens、batch size、解码策略和硬件必须保持一致。首 token 延迟(TTFT)主要覆盖 prompt 的 prefill 与第一次选 token;总延迟覆盖整次生成;单请求生成吞吐可用“生成 token 数 ÷ 总延迟”表示。
预热轮次只用于触发 CUDA 上下文、内核选择和缓存,不进入统计。正式测量至少跑多轮,并优先比较中位数;峰值显存则取各轮最大值。GPU 运算是异步的,计时边界必须调用 torch.cuda.synchronize(),否则 CPU 计时器可能提前结束。本示例从输入已在 GPU 上就绪后开始计时,不包含模型加载、分词和主机到 GPU 的传输。
用同一脚本测四个指标
下面示例使用 gpt2,固定 128 个输入 token、生成 32 个 token,先预热 3 轮,再测量 10 轮。示例要求 CUDA GPU,并假设已经安装兼容版本的 PyTorch 与 Transformers。
import statistics
import time

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = "gpt2"
INPUT_TOKENS = 128
NEW_TOKENS = 32
WARMUP_ROUNDS = 3
MEASURE_ROUNDS = 10

if not torch.cuda.is_available():
    raise SystemExit("This benchmark requires a CUDA GPU.")

device = torch.device("cuda")
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(MODEL_ID).to(device).eval()

prompt = "Hugging Face Transformers inference benchmark. " * 64
input_ids = tokenizer(
    prompt,
    return_tensors="pt",
    truncation=True,
    max_length=INPUT_TOKENS,
)["input_ids"].to(device)

if input_ids.shape[1] != INPUT_TOKENS:
    raise RuntimeError(f"expected {INPUT_TOKENS} tokens, got {input_ids.shape[1]}")

@torch.inference_mode()
def run_once():
    torch.cuda.reset_peak_memory_stats()
    torch.cuda.synchronize()
    started = time.perf_counter()

    outputs = model(input_ids=input_ids, use_cache=True)
    next_token = outputs.logits[:, -1, :].argmax(dim=-1, keepdim=True)
    past_key_values = outputs.past_key_values

    torch.cuda.synchronize()
    ttft = time.perf_counter() - started

    for _ in range(NEW_TOKENS - 1):
        outputs = model(
            input_ids=next_token,
            past_key_values=past_key_values,
            use_cache=True,
        )
        next_token = outputs.logits[:, -1, :].argmax(dim=-1, keepdim=True)
        past_key_values = outputs.past_key_values

    torch.cuda.synchronize()
    total = time.perf_counter() - started
    peak_mib = torch.cuda.max_memory_allocated() / 1024**2
    return ttft, total, NEW_TOKENS / total, peak_mib

for _ in range(WARMUP_ROUNDS):
    run_once()

rows = [run_once() for _ in range(MEASURE_ROUNDS)]
ttft_ms = [row[0] * 1000 for row in rows]
total_ms = [row[1] * 1000 for row in rows]
tokens_per_s = [row[2] for row in rows]
peak_mib = [row[3] for row in rows]

print(f"input_tokens={INPUT_TOKENS} new_tokens={NEW_TOKENS} rounds={MEASURE_ROUNDS}")
print(f"ttft_ms median={statistics.median(ttft_ms):.2f}")
print(f"total_ms median={statistics.median(total_ms):.2f}")
print(f"tokens_per_s median={statistics.median(tokens_per_s):.2f}")
print(f"peak_vram_mib max={max(peak_mib):.2f}")
预期输出
input_tokens=128 new_tokens=32 rounds=10
ttft_ms median=<TIME>
total_ms median=<TIME>
tokens_per_s median=<THROUGHPUT>
peak_vram_mib max=<MEMORY><TIME>、<THROUGHPUT> 与 <MEMORY> 会随 GPU、驱动、PyTorch/Transformers 版本和后台负载变化。这里的峰值显存是当前进程中张量的峰值分配量,不等同于 nvidia-smi 看到的整卡占用;比较前后方案时应始终使用同一种口径。
读懂结果而不是只看最快一轮
TTFT 变小适合交互式聊天,tokens/s 变大更能反映连续解码速度,总延迟则体现用户完成一次请求要等多久。吞吐还会被 batch 和并发显著改变,因此单请求 tokens/s 不能直接代表服务端总体吞吐。
当基线稳定后,再对半精度、量化、批处理或编译逐项做 A/B 测试,才能确认收益来自哪里,而不是来自预热、随机输入或计时误差。