
大模型原理与训练 / 系统课时
封装稳定的推理接口
封装稳定的推理接口
线上调用不应该直接碰 Tokenizer、模型对象或设备细节。本节用文本情感分类把这些步骤收进一个稳定的 predict 接口:调用方只提交业务输入和少量受控参数,服务内部负责预处理、设备搬运、推理与后处理。
学习目标
- 用单一
predict方法封装 Tokenizer、模型推理和后处理。 - 把设备选择、模型路径等运行参数与业务请求参数隔离。
- 为输入边界和返回结构建立稳定契约,避免底层实现泄漏到调用方。
先确定业务接口
稳定接口的关键不是“把代码包进函数”,而是先限制调用方能控制什么。这个分类接口只接受 text 与 max_length,返回 label 和 score;模型 ID、CPU/GPU 选择、张量类型都属于运行时实现,不进入业务请求。
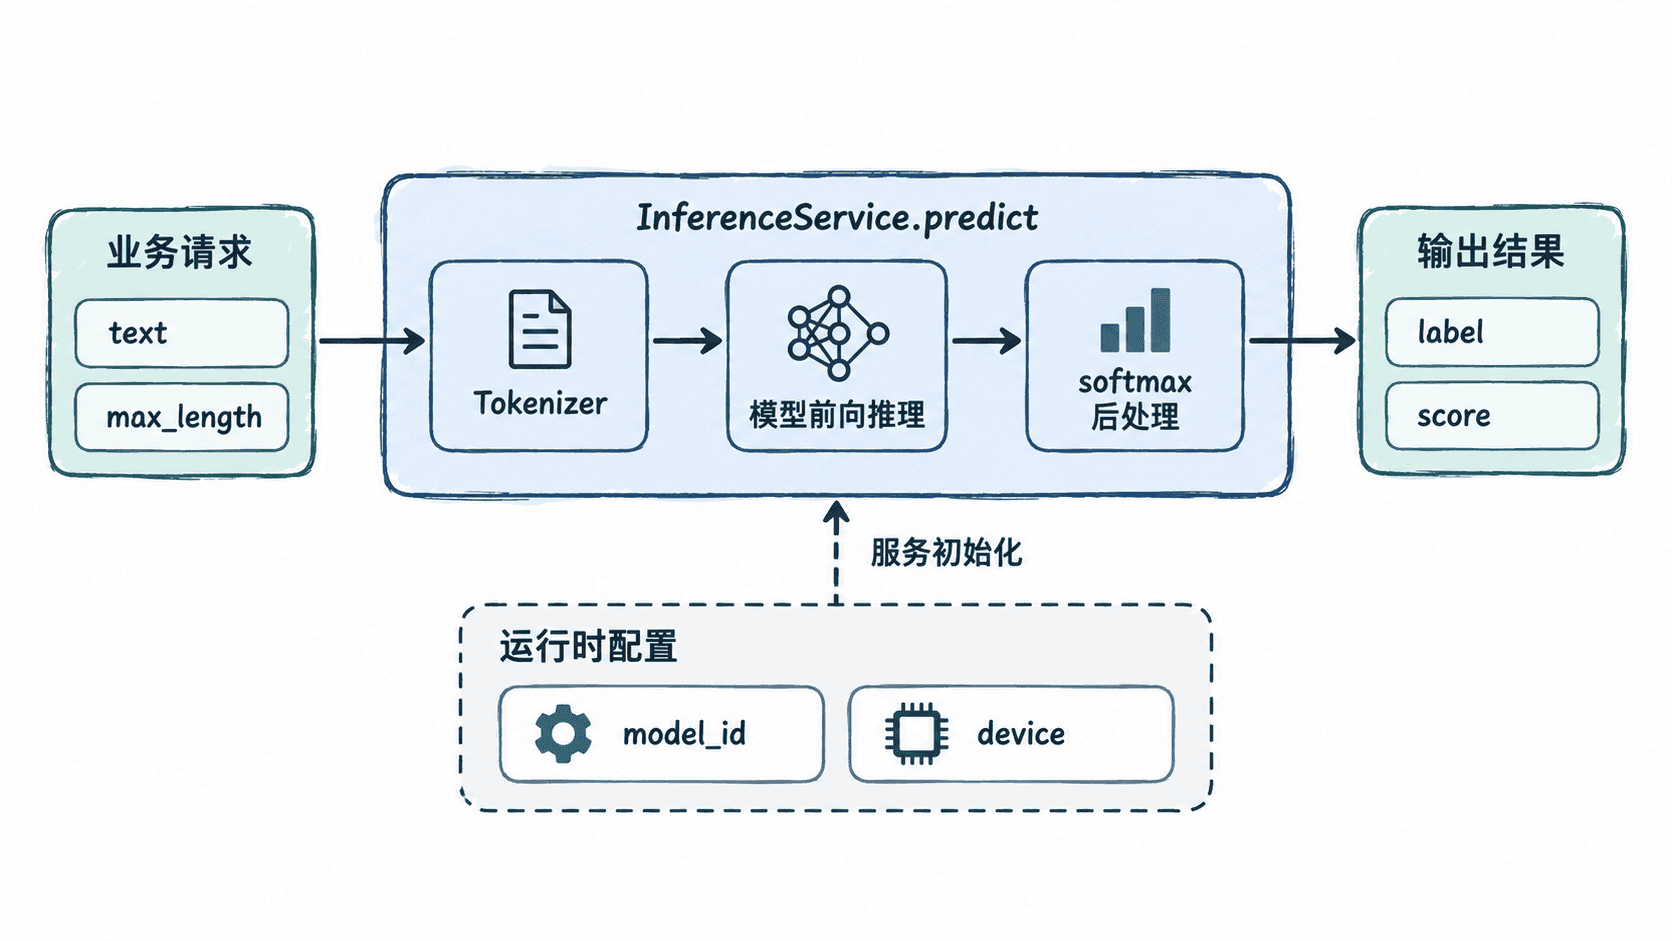
这样做以后,即使后续从 PyTorch 切换到其他推理后端,或把模型换成本地目录,业务层仍然可以继续调用同一个方法。
封装 Tokenizer、模型与后处理
下面示例使用一个序列分类模型。运行环境需要已安装 torch 与 transformers,首次加载远端模型时还需要能够访问模型仓库。
import torch
from transformers import AutoModelForSequenceClassification, AutoTokenizer

MODEL_ID = "distilbert/distilbert-base-uncased-finetuned-sst-2-english"

class InferenceService:
    def __init__(self, model_id: str = MODEL_ID) -> None:
        self.device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
        self.tokenizer = AutoTokenizer.from_pretrained(model_id)
        self.model = AutoModelForSequenceClassification.from_pretrained(model_id)
        self.model.to(self.device)
        self.model.eval()

    def predict(self, text: str, max_length: int = 256) -> dict[str, float | str]:
        text = text.strip()
        if not text:
            raise ValueError("text must not be empty")
        if not 8 <= max_length <= 512:
            raise ValueError("max_length must be between 8 and 512")

        # 请求只描述业务输入;张量设备迁移由服务内部统一处理。
        encoded = self.tokenizer(
            text,
            return_tensors="pt",
            truncation=True,
            max_length=max_length,
        )
        encoded = {name: tensor.to(self.device) for name, tensor in encoded.items()}

        with torch.inference_mode():
            logits = self.model(**encoded).logits
            probabilities = torch.softmax(logits, dim=-1)

        class_id = int(probabilities.argmax(dim=-1).item())
        score = float(probabilities[0, class_id].item())
        label = self.model.config.id2label[class_id]

        # 只返回可序列化的业务字段,不泄漏 Tensor 或设备对象。
        return {"label": label, "score": round(score, 4)}

if __name__ == "__main__":
    service = InferenceService()
    result = service.predict("I really enjoyed this movie.")
    print(result["label"])
预期输出:
POSITIVEscore 也会包含在返回对象中,但具体浮点值可能因依赖版本、硬件和模型实现细节略有差异,因此验证接口契约时不应依赖某个固定小数。
隔离运行参数与请求参数
设备选择应该在服务初始化时完成,而不是让每个请求携带 device="cuda:0"。同理,模型路径、精度类型、量化方式和批处理策略通常由部署配置决定;把这些参数暴露给业务请求,会让调用方与部署拓扑耦合,也容易造成不可控的资源切换。
真正适合作为请求参数的,是会改变本次业务结果且能够安全设限的值。例如生成任务里的 max_new_tokens、分类任务里的最大输入长度。即使允许传入,也应设置服务端上下界,不能把底层 generate(**kwargs) 或模型调用参数原样透传。
固定后处理和错误边界
模型输出常常是 Tensor、logits 或 token ID,这些都不应该直接成为对外契约。后处理层要把它们转换成稳定、可序列化的业务结构,并明确空文本、超长输入和非法参数如何失败。
如果以后把分类模型换成生成模型,可以保留同样的封装原则:generate 内部完成编码、设备管理、model.generate 与解码,对外只返回生成文本和业务需要的元数据。稳定接口的价值就在于让模型实现可以替换,而调用方不必跟着修改。