
大模型原理与训练 / 系统课时
用 device_map 切分大模型
用 device_map 切分大模型
当单张 GPU 放不下模型时,可以让 Transformers 按设备容量把不同模块分配到多张 GPU,并把剩余权重卸载到 CPU。这里会实际限制两张 GPU 的可用显存、检查 hf_device_map,再观察跨设备与 CPU 卸载为何会牺牲推理速度。
学习目标
- 使用
device_map="auto"和max_memory控制模型在多设备间的分配 - 通过
hf_device_map验证每个模块实际落在哪个设备 - 解释 GPU 间激活传输和 CPU 权重搬运为何会增加延迟
device_map 解决的是容量问题
device_map 描述模型模块放在哪个设备。使用 "auto" 时,加载逻辑会优先利用更快的设备,在 GPU 容量不足后再使用 CPU;如果仍不足,还可以进一步使用磁盘卸载。max_memory 则给每个设备设置上限,避免自动分配把显存或内存吃满。
这类切分属于大模型推理的容量扩展,不是高效的数据并行。一次前向传播仍要按层顺序执行:前一段层算完后,激活才能交给下一段设备;若某些权重驻留在 CPU,还会发生主机与 GPU 之间的权重搬运。设备越慢、边界越多,等待越明显。
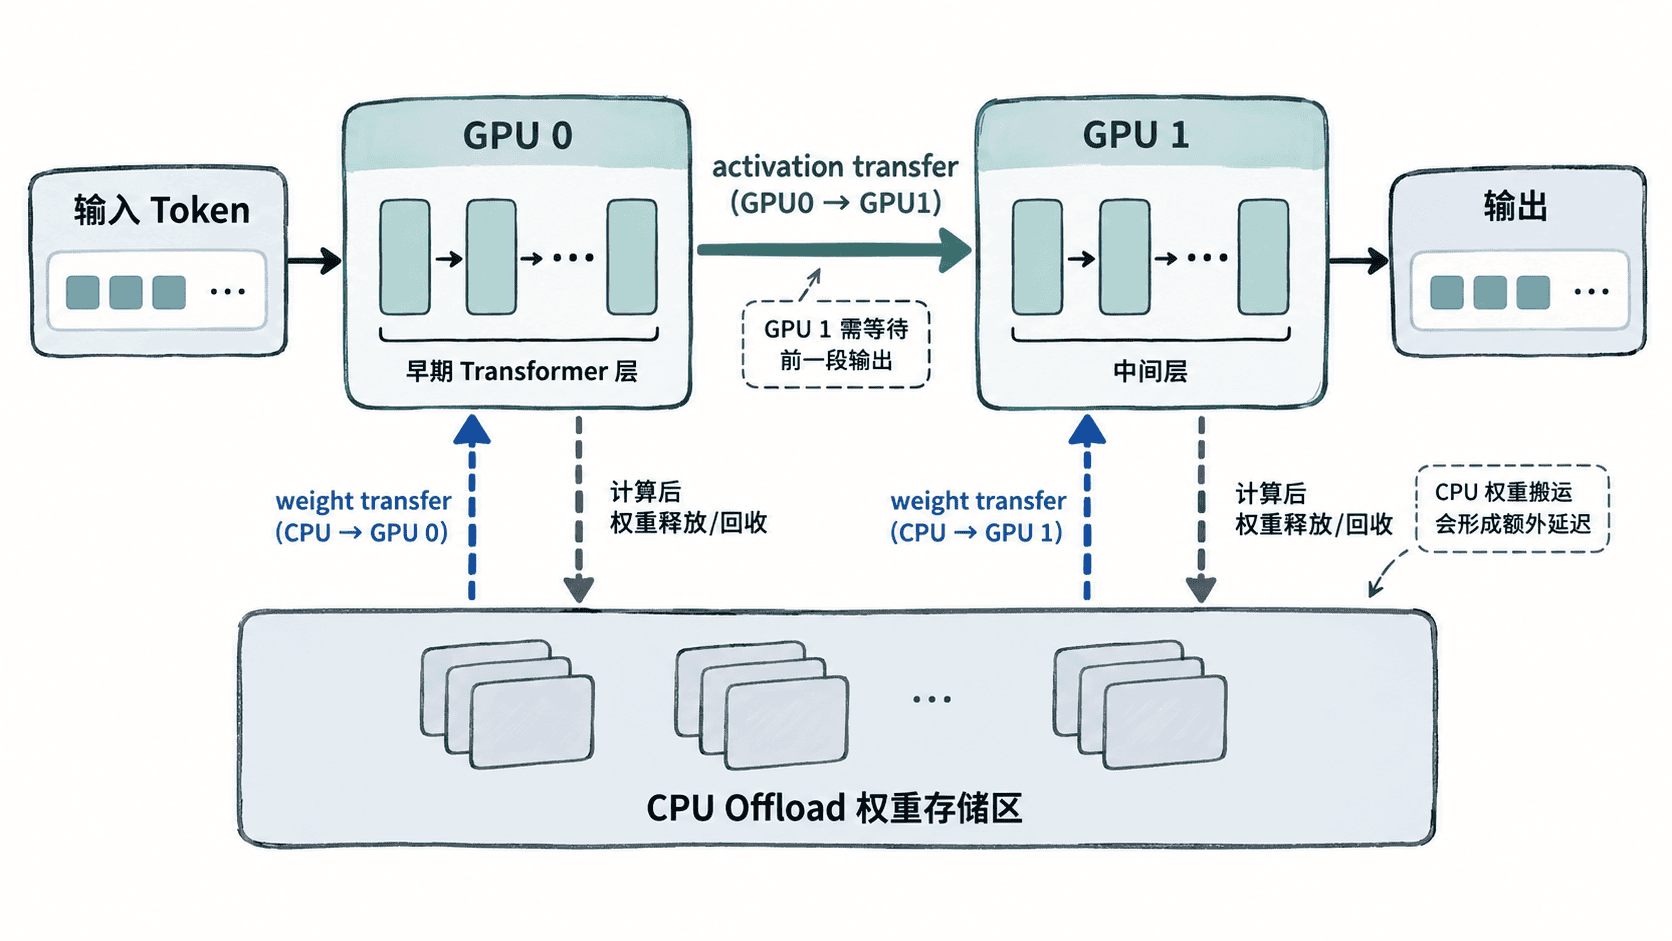
限制显存并自动切分
下面示例要求至少两张 CUDA GPU。为了稳定演示 CPU 卸载,它把两张 GPU 的模型权重预算都限制为 4 GiB,并给 CPU 24 GiB;实际部署应按你的设备容量留出 KV Cache、激活和运行时开销后重新设置,而不是照抄这个数字。
import time
from collections import Counter

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = "Qwen/Qwen2.5-7B-Instruct"

if torch.cuda.device_count() < 2:
    raise SystemExit("This example requires at least two CUDA GPUs.")

max_memory = {
    0: "4GiB",
    1: "4GiB",
    "cpu": "24GiB",
}

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    dtype=torch.float16,
    device_map="auto",
    max_memory=max_memory,
)

placement = Counter(str(device) for device in model.hf_device_map.values())
print(f"devices={sorted(placement)}")
print(f"modules_per_device={dict(placement)}")

prompt = "列出降低大模型推理显存占用的三种方法。"
input_device = next(model.parameters()).device
inputs = tokenizer(prompt, return_tensors="pt").to(input_device)

for device_index in (0, 1):
    torch.cuda.synchronize(device_index)
start = time.perf_counter()
with torch.inference_mode():
    output_ids = model.generate(
        **inputs,
        max_new_tokens=48,
        do_sample=False,
    )
for device_index in (0, 1):
    torch.cuda.synchronize(device_index)

print(f"generation_seconds={time.perf_counter() - start:.3f}")
print(tokenizer.decode(output_ids[0], skip_special_tokens=True))
预期输出
devices=['0', '1', 'cpu']
modules_per_device={'0': <COUNT>, '1': <COUNT>, 'cpu': <COUNT>}
generation_seconds=<TIME>
<GENERATED_TEXT><COUNT>、<TIME> 和 <GENERATED_TEXT> 是动态值,具体结果取决于模型版本、GPU 数量与显存、CPU 内存和互连速度。若输出中没有 cpu,说明模型在给定 GPU 预算内已经放得下;若加载阶段直接失败,则应先检查 CPU 内存是否足够或调低模型规模。
用 hf_device_map 检查实际边界
不要只因为传了 device_map="auto" 就假设切分符合预期。model.hf_device_map 才是加载后的事实来源:它会显示嵌入层、Transformer 层、归一化层和输出头等模块实际落在哪个设备。
排查时重点看两个问题。第一,相邻层是否被分成了过多设备段;边界越多,激活跨设备复制越频繁。第二,是否有大量层落到 cpu;CPU 卸载能让模型“装得下”,但权重在需要时搬到 GPU 会增加传输等待,因此通常是容量兜底而非低延迟方案。
容量够了仍然慢时怎么处理
先做一个基线:在能完整容纳模型的单卡或单设备配置上测相同提示词和解码长度,再与多设备切分版本比较。如果加入第二张 GPU 后显存问题消失但单请求延迟反而上升,通常不是 device_map 失效,而是模型并行中的等待与传输成本超过了单卡收益。
当 CPU 卸载成为主要瓶颈时,优先顺序通常是减少 CPU 上的层、结合 8bit/4bit 降低权重占用、提高 GPU 显存预算,最后才考虑继续增加更慢的卸载层级。若目标是多请求吞吐而不是“让单个模型装得下”,还应评估专门的并行或批处理方案,而不是把 device_map 当成通用加速开关。
device_map 最适合解决“模型容量超过单设备”的问题。只要 hf_device_map 与资源预算一致、没有意外落盘,并且真实负载下的延迟仍满足服务目标,这种切分就是有效方案;否则应把量化或更合适的并行策略纳入下一轮优化。