
大模型原理与训练 / 系统课时
掌握分词编码与解码
掌握分词编码与解码
模型真正接收的不是原始字符串,而是一串 token ID。要判断为什么一句话突然变长、批量输入为什么需要补齐,必须把“文本→子词→ID→特殊符号与掩码”这条链路看清。本篇用 BERT Tokenizer 逐步观察 tokenize、encode、decode 与批量编码结果。
学习目标
- 能区分
tokenize()、encode()、decode()各自处理的阶段 - 能观察子词切分与词表 ID 映射如何改变序列长度
- 能正确使用批量编码的 padding、truncation 与
attention_mask
一段文本如何变成模型输入
Tokenizer 通常先做规范化和预切分,再按模型自己的子词算法查词表,把每个 token 映射为整数 ID。随后还可能加入 [CLS]、[SEP] 等特殊 token,并在批量输入中补齐或截断长度,最终生成模型需要的字段。
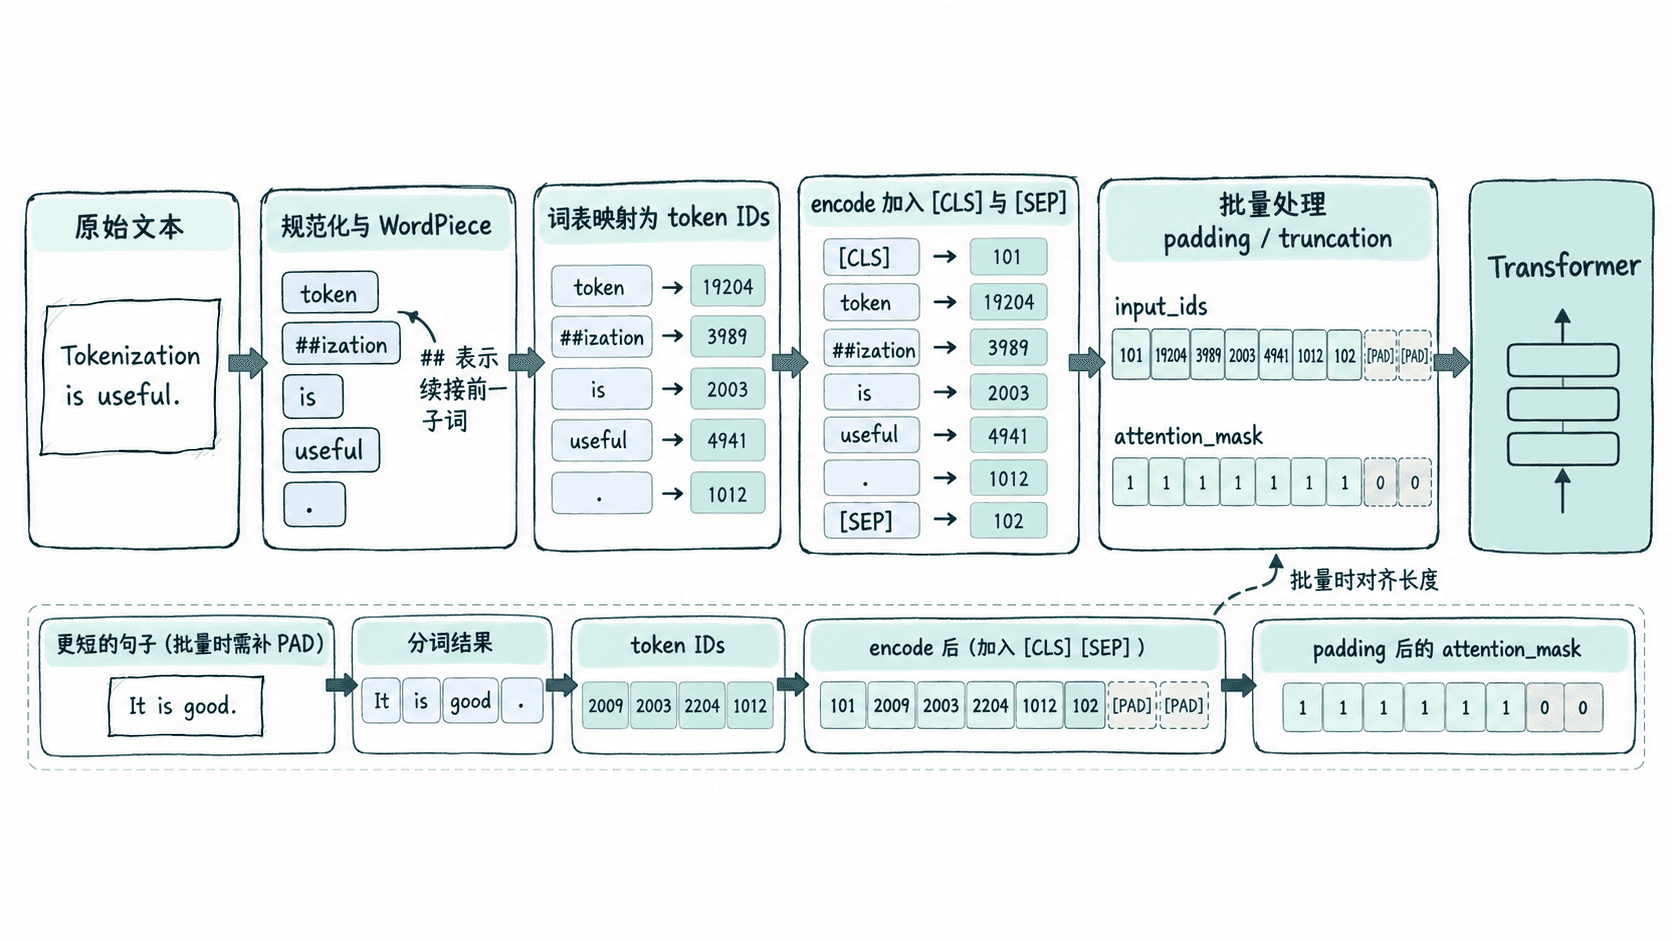
tokenize() 主要让你看“切成了什么 token”;encode() 会继续把 token 映射为 ID,并默认加入该模型需要的特殊 token;decode() 则把 ID 序列转换回可读文本。解码后的大小写、空格或标点形式不保证与原字符串逐字一致,因为规范化已经发生过。
用一个脚本观察编码与解码
下面使用 google-bert/bert-base-uncased。这个 Tokenizer 使用 WordPiece,因此较长词可能被拆成多个词表内子词;第二个及后续片段常带 ## 前缀。
from transformers import AutoTokenizer

MODEL_ID = "google-bert/bert-base-uncased"

def main():
    tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
    text = "Tokenization is useful."

    tokens = tokenizer.tokenize(text)
    encoded = tokenizer.encode(text)
    print("tokens:", tokens)
    print("token ->", tokenizer.convert_tokens_to_ids(tokens[0]))
    print("##ization ->", tokenizer.convert_tokens_to_ids(tokens[1]))
    print("encoded_length:", len(encoded))
    print("decoded:", tokenizer.decode(encoded))

    # 批量编码会把较短序列补到本批最长长度,并生成注意力掩码。
    batch = tokenizer(
        ["Hello world!", text],
        padding=True,
        truncation=True,
    )
    print("batch_lengths:", [len(ids) for ids in batch["input_ids"]])
    print("visible_tokens:", [sum(mask) for mask in batch["attention_mask"]])

if __name__ == "__main__":
    main()
预期输出:
tokens: ['token', '##ization', 'is', 'useful', '.']
token -> 19204
##ization -> 3989
encoded_length: 7
decoded: [CLS] tokenization is useful. [SEP]
batch_lengths: [7, 7]
visible_tokens: [5, 7]
原文本有 4 个按空格观察的词,但 WordPiece 把 Tokenization 拆成两个子词,因此普通 token 已有 5 个;encode() 再加入 [CLS] 和 [SEP],长度变为 7。模型的输入长度取决于 token 数,而不是字符数或肉眼看到的单词数。
批量编码为什么需要 padding 和 mask
神经网络批量计算通常要求同一批序列形成规则矩阵。padding=True 会把当前批次较短的序列补到本批最长序列;BERT 的补齐位置使用 [PAD],同时 attention_mask 用 1 标记有效 token、用 0 标记补齐位置。
上例第一句编码后只有 5 个有效 token,但被补到长度 7,所以它的掩码中只有 5 个 1;第二句本身就是 7 个有效 token,不需要补齐。truncation=True 则允许 Tokenizer 在输入超过模型允许范围时执行截断;若业务有固定窗口,还应显式设置 max_length,避免长度策略依赖默认值。
选择 API 时抓住输入输出边界
只想分析切词行为时用 tokenize();要把单条文本直接送进模型时,通常使用 Tokenizer 的调用接口或 encode();处理训练与推理批次时,优先使用 tokenizer([...], padding=..., truncation=...),因为它会一次返回 input_ids、attention_mask 等模型字段。
decode() 适合把生成结果或调试用 ID 转回文本,但不要把它当成原文的无损反序列化。真正需要定位字符级位置时,应使用 Fast Tokenizer 提供的 offset mapping,而不是先 decode 再猜原始字符位置。