
大模型原理与训练 / 系统课时
用 map 构造预处理流水线
用 map 构造预处理流水线
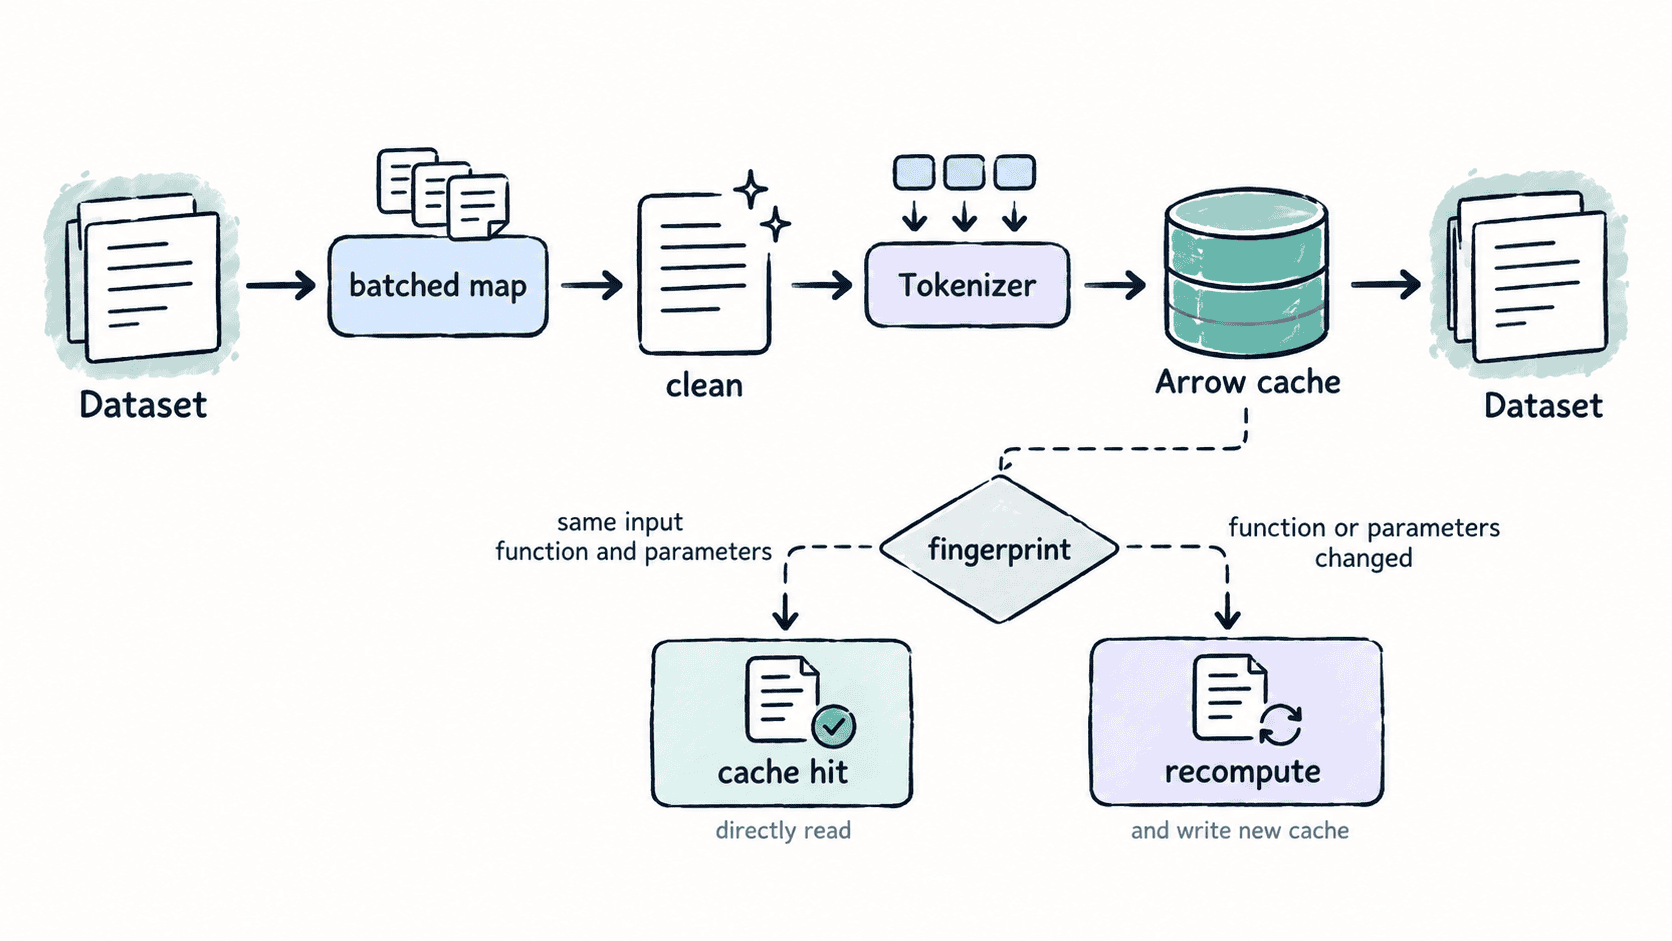
预处理如果散落在训练循环里,很难复用、缓存和验证。本节把文本清洗、字段变换与 Tokenizer 编码集中到 Dataset.map,再利用批处理与缓存让同一套变换既高效又可重复检查。
学习目标
- 用
map把清洗、字段变换和 Tokenizer 编码串成单一流水线 - 使用
batched=True减少逐条调用开销并控制批大小 - 理解 map 指纹、缓存命中与强制重算的边界
把预处理写成纯变换
map 的核心约束是:输入一批样本,返回要新增或替换的列。把清洗和编码放在同一个函数里,可以让最终数据集明确记录这一轮变换的结果,也便于复用缓存。
batched=True 只是让预处理函数一次接收多条样本,输出数据集本身仍然按样本组织。Tokenizer 天然支持列表输入,因此批量 map 通常比逐条调用更合适。remove_columns 可以在变换结束后删除原始字段,减少后续训练阶段携带的无用列。
完成可缓存的批量编码
下面用本地 JSONL 保证输入固定,再连续执行两次完全相同的 map。预处理函数先压缩多余空白并转成小写,然后一次性调用 Tokenizer;第二次调用应复用第一次生成的缓存结果。
from pathlib import Path
import json
from datasets import load_dataset
from transformers import AutoTokenizer

rows = [
    {"text": "  Great   movie!  ", "label": 1},
    {"text": "Bad   ending.", "label": 0},
]
source = Path("map_demo.jsonl")
with source.open("w", encoding="utf-8") as f:
    for row in rows:
        f.write(json.dumps(row, ensure_ascii=False) + "\n")

dataset = load_dataset("json", data_files={"train": str(source)}, split="train")
tokenizer = AutoTokenizer.from_pretrained("distilbert/distilbert-base-uncased")

def preprocess(batch):
    clean_text = [" ".join(text.split()).lower() for text in batch["text"]]
    encoded = tokenizer(
        clean_text,
        truncation=True,
        max_length=16,
        padding="max_length",
    )
    encoded["clean_text"] = clean_text
    return encoded

map_args = {
    "batched": True,
    "batch_size": 2,
    "remove_columns": ["text"],
}
first = dataset.map(preprocess, **map_args)
second = dataset.map(preprocess, **map_args)

print("columns:", sorted(first.column_names))
print("clean_text:", list(first["clean_text"]))
print("token_lengths:", sorted({len(ids) for ids in first["input_ids"]}))
print("cache_reused:", first.cache_files == second.cache_files)
预期输出
columns: ['attention_mask', 'clean_text', 'input_ids', 'label']
clean_text: ['great movie!', 'bad ending.']
token_lengths: [16]
cache_reused: True
首次运行还会出现数据准备、模型下载和 map 进度;这些日志可能因环境不同而变化。示例通过固定 max_length=16 与 padding="max_length",让两条样本都得到长度为 16 的编码。
缓存为什么能复用
Datasets 会为数据和变换生成指纹,并把 map 的结果写入缓存。相同输入、相同变换函数与相同参数再次执行时,可以直接读取已经计算好的结果,而不必重新 Tokenize。变换逻辑或关键参数变化后,应得到新的结果,而不是把旧缓存当成训练数据继续使用。
调试时如果怀疑缓存掩盖了代码变化,可以在 map 中临时设置 load_from_cache_file=False 强制重新执行。这个开关适合定位问题,不宜长期作为默认值,否则每次运行都会放弃可复用的处理结果。
缓存也不等于完整的实验可复现。预处理函数应避免依赖当前时间、随机网络响应等不稳定外部状态;正式训练还应固定依赖版本、Tokenizer 来源及其修订版本,使“函数看起来没变”时实际编码规则也保持一致。
控制性能与字段边界
batch_size 决定每次传给预处理函数的样本数。较大的批次通常能提升 Tokenizer 吞吐,但会占用更多内存,因此应根据平均文本长度和机器内存调整。CPU 预处理成为瓶颈时,还可以评估 num_proc,但传给 map 的函数必须适合多进程序列化。
不要为了省空间过早删除仍要用于排查的数据。训练只需要模型输入时,可以删除原始文本;仍在验证清洗质量时,像示例一样保留 clean_text 更容易抽样检查。稳定的数据管线应让每一列为什么存在、何时删除都能被明确解释。
当清洗、Tokenizer 参数或标签变换发生变化时,把它视为数据版本变化并重新验收输出 schema。这样 map 不只是一个便利函数,而是训练前可检查、可缓存、可复现的数据构建边界。