
大模型原理与训练 / 系统课时
处理大数据集与流式读取
处理大数据集与流式读取
当数据集大到无法一次下载或装入内存时,关键不是“再加内存”,而是改变读取方式。本节用 Hugging Face Datasets 演示普通 Dataset 与 IterableDataset 的边界,并把 select、流式读取、shuffle buffer、分片和训练循环放进同一条可验证的数据管线。
学习目标
- 判断何时使用普通
Dataset,何时开启streaming=True - 使用
select、shuffle、shard与take控制样本范围和内存占用 - 识别流式数据在随机访问、全局打乱和训练步数上的限制
在随机访问与流式读取之间做选择
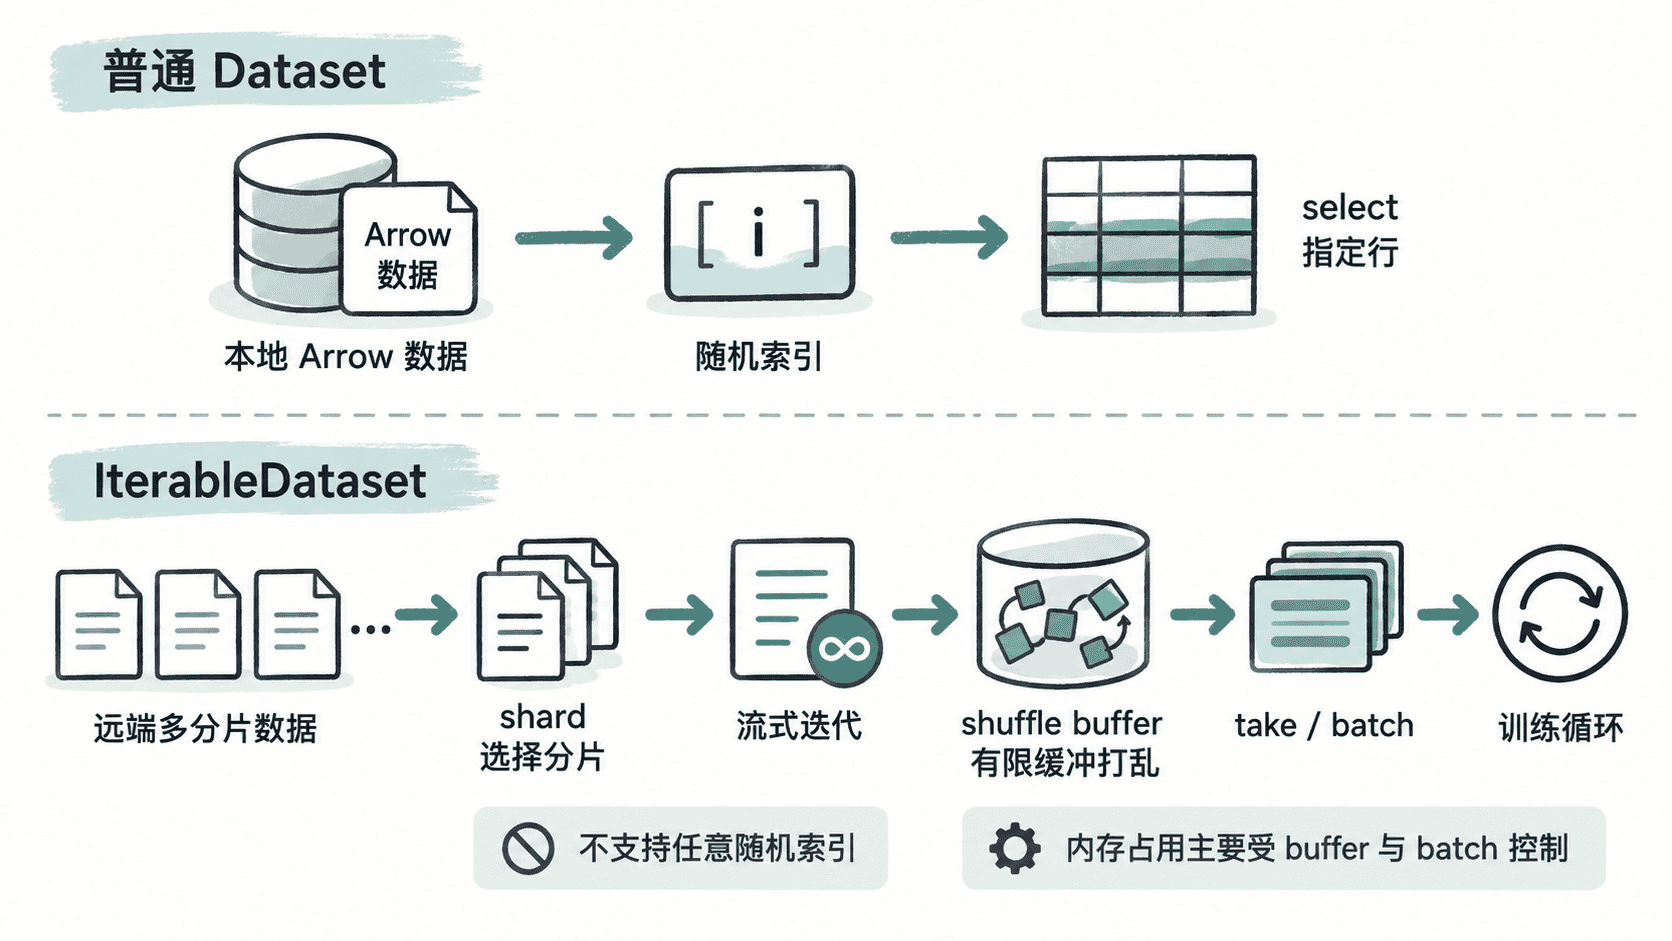
普通 Dataset 适合需要按索引取样、反复访问固定样本或执行 select(indices) 的场景。它通常基于本地 Arrow 数据进行随机访问,因此“第 1000 行”是明确可定位的。
设置 streaming=True 后得到的是 IterableDataset。数据随迭代逐步读取,不要求先把完整数据集下载到本地,但代价是不能把它当成可随机索引的数组使用。要抽取流式数据的一段,应优先使用 take、skip、filter 或分片,而不是依赖任意索引。
| 需求 | Dataset |
IterableDataset |
|---|---|---|
| 按索引随机访问 | 适合 | 不适合 |
select([0, 10, 20]) |
支持 | 不作为随机取样手段 |
| 超大数据逐条消费 | 会受本地存储约束 | 适合 |
| 打乱 | 可做全量打乱 | 使用有限 shuffle buffer 近似打乱 |
用一条管线控制样本规模
下面的脚本先用内存中的小 Dataset 展示 select,再流式读取公开数据集,对源数据分片、使用有限缓冲区打乱,并只消费 3 条样本。示例假设已安装 datasets 且运行环境可以访问 Hugging Face Hub。
from datasets import Dataset, load_dataset

# select 依赖可随机访问的 Dataset。
small = Dataset.from_dict(
    {"text": ["alpha", "beta", "gamma", "delta"], "label": [0, 1, 0, 1]}
)
picked = small.select([0, 2])
print("select rows:", len(picked), list(picked["text"]))

# 流式数据先分片,再用固定大小的缓冲区做近似打乱。
stream = load_dataset(
    "fancyzhx/amazon_polarity",
    split="train",
    streaming=True,
)
stream = stream.shard(num_shards=2, index=0)
stream = stream.shuffle(seed=42, buffer_size=1000)

samples = list(stream.take(3))
print("stream sample count:", len(samples))
print("columns:", sorted(samples[0].keys()))
预期输出
select rows: 2 ['alpha', 'gamma']
stream sample count: 3
columns: ['content', 'label', 'title']
样本文本本身会随数据版本和打乱结果变化,因此示例只验证条数与字段结构。这里不会把全部训练集读进 Python 列表,真正被物化的只有 take(3) 得到的三条记录以及 shuffle buffer 中的一小段数据。
理解 shuffle buffer 与分片
流式 shuffle(buffer_size=N) 不是先收集全部样本再做完全随机排列。它维护最多约 N 条记录,从缓冲区抽取样本并用后续记录补入;N 越大,随机性通常越好,但占用的内存也越多。对于已经由多个文件构成的数据集,打乱还会影响分片的消费顺序。
shard(num_shards, index) 更适合把大数据源拆给多个进程、机器或独立任务。核心目标是让每个消费者只处理自己的那一份,而不是让所有 worker 重复遍历完整数据。分片之后再为各自的数据流设置相同策略,通常比先把所有样本收集起来再切分更节省内存。
让训练循环适配未知长度
IterableDataset 的本质是“不断产生下一个样本”,因此很多依赖总长度的逻辑不能照搬。随机采样器无法任意跳到某个索引;按 epoch 计算总步数也可能失去依据。使用 Trainer 处理没有 __len__ 的流式训练集时,应显式给出正的 max_steps,用训练步数而不是数据集长度约束训练。
如果需要每个 epoch 改变流式打乱顺序,可在迭代前设置新的 epoch 种子;如果需要精确复现实验,则同时固定随机种子、分片规则、buffer 大小和训练步数。这样内存占用主要由 shuffle buffer、预处理批次和训练 batch 决定,而不会随着数据集总规模线性增长。