
大模型原理与训练 / 系统课时
读取 logits 与隐藏状态
读取 logits 与隐藏状态
调用 Transformers 模型后,返回值通常不是单个张量,而是带字段的 ModelOutput。要正确完成预测、训练或内部分析,需要分清 logits、loss、hidden_states 与 attentions 各自代表什么,并知道哪些字段需要显式开启。
学习目标
- 使用属性方式读取
ModelOutput中的核心字段。 - 根据张量形状判断
logits、隐藏状态与注意力权重的语义。 - 知道何时传入
labels、output_hidden_states和output_attentions。
ModelOutput 不是普通元组
Transformers 的模型通常返回 ModelOutput 子类,例如分类模型常见的是带 loss、logits、hidden_states 和 attentions 的输出对象。最清晰的读取方式是 outputs.logits 这种属性访问;需要按键读取时也可以使用类似字典的方式。
可选字段为 None 时,不应依赖固定的元组位置。确实需要元组时可调用 to_tuple(),但业务代码更适合直接按字段名读取,这样模型配置或返回字段变化时更容易维护。
四类核心张量分别回答什么
| 字段 | 什么时候出现 | 典型含义 |
|---|---|---|
logits |
带预测头的模型通常都会返回 | softmax 前的预测分数 |
loss |
通常在传入正确格式的 labels 后返回 |
当前批次的训练目标值 |
hidden_states |
开启 output_hidden_states 后返回 |
embedding 与各层的隐藏表示序列 |
attentions |
开启 output_attentions 且模型支持时返回 |
各层、各注意力头对 token 位置的注意力权重 |
对序列分类模型,logits 常见形状是 (B, C);隐藏状态通常是一个 tuple,每个元素形状为 (B, L, H);自注意力权重通常按层组成 tuple,每层形状为 (B, A, L, L),其中 A 是注意力头数。
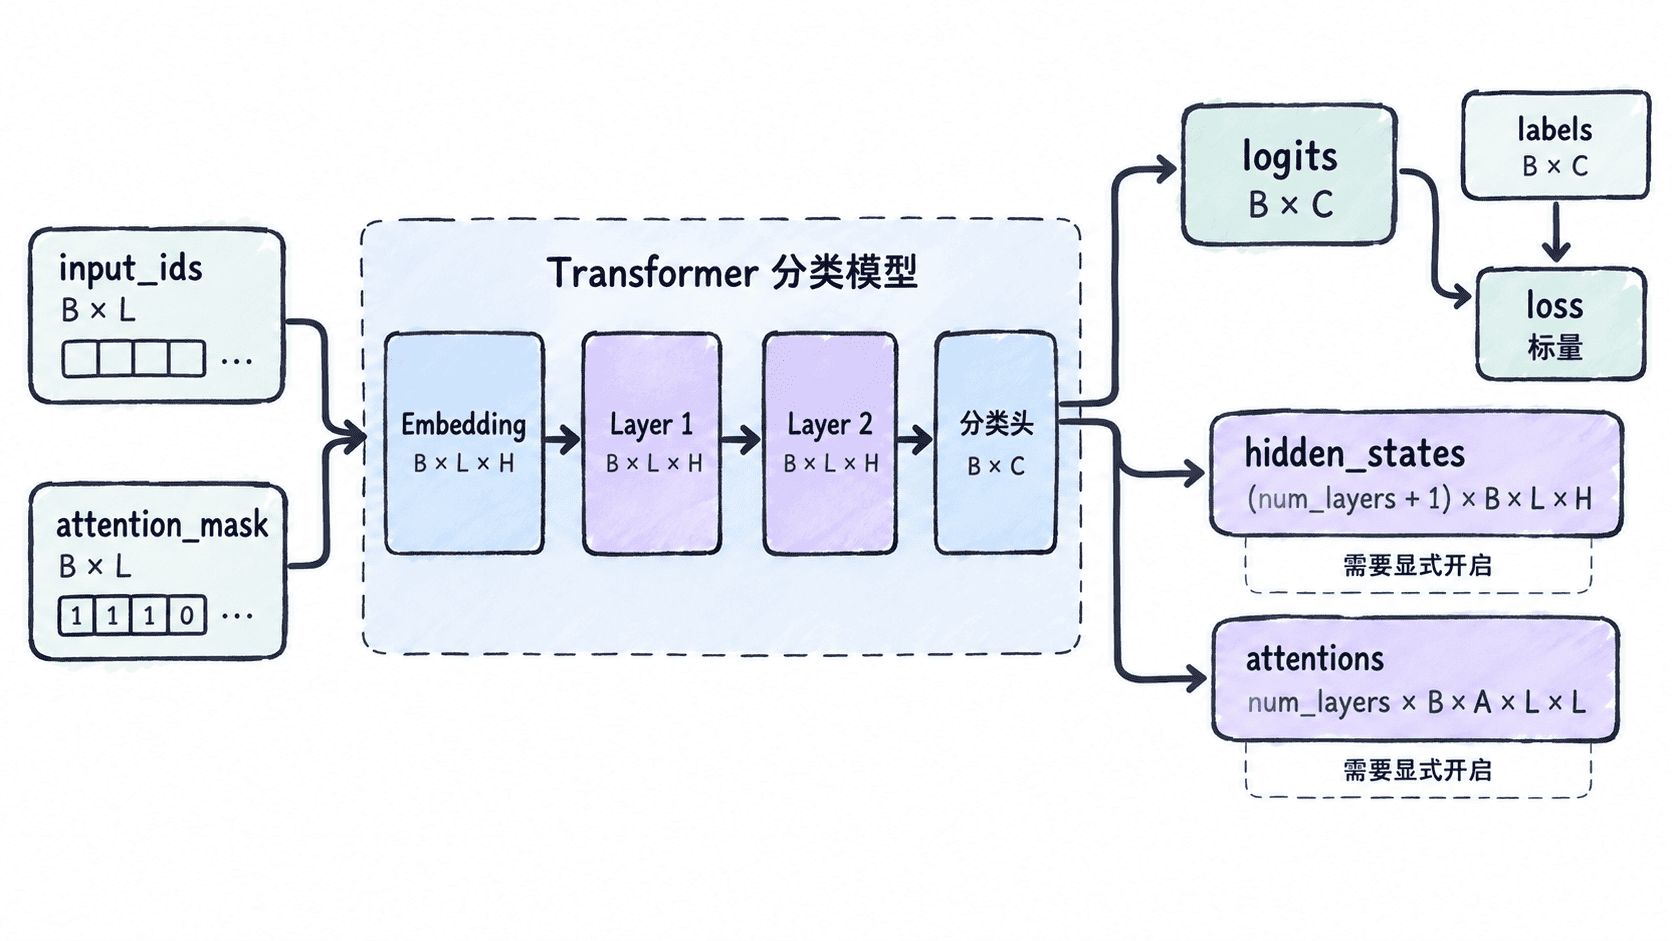
一次取出并检查所有字段
下面构造一个两层的小型 BERT 分类模型。它使用随机权重,因此示例只验证接口和形状;传入 labels 会得到 loss,配置中开启两个开关后才会返回隐藏状态与注意力。
import torch
from transformers import BertConfig, BertForSequenceClassification

torch.manual_seed(0)
# 小模型足以验证 ModelOutput 的字段和维度,不需要下载 checkpoint。
config = BertConfig(
    vocab_size=100,
    hidden_size=16,
    num_hidden_layers=2,
    num_attention_heads=2,
    intermediate_size=32,
    num_labels=3,
    output_hidden_states=True,
    output_attentions=True,
)
model = BertForSequenceClassification(config)
model.eval()

# 第一个样本末尾是 padding,因此 attention_mask 对应位置为 0。
input_ids = torch.tensor([[1, 5, 9, 2, 0], [1, 8, 3, 7, 2]])
attention_mask = torch.tensor([[1, 1, 1, 1, 0], [1, 1, 1, 1, 1]])
# labels 让分类头同时计算监督训练所需的 loss。
labels = torch.tensor([0, 2])

with torch.no_grad():
    outputs = model(
        input_ids=input_ids,
        attention_mask=attention_mask,
        labels=labels,
        return_dict=True,
    )

# logits 不是概率;分类概率需要在类别维上再做 softmax。
probs = outputs.logits.softmax(dim=-1)
print("logits:", tuple(outputs.logits.shape))
print("loss:", tuple(outputs.loss.shape))
print("hidden_layers:", len(outputs.hidden_states))
print("hidden_0:", tuple(outputs.hidden_states[0].shape))
print("attention_layers:", len(outputs.attentions))
print("attention_0:", tuple(outputs.attentions[0].shape))
print("prob_sums:", [round(x, 4) for x in probs.sum(dim=-1).tolist()])
预期输出
logits: (2, 3)
loss: ()
hidden_layers: 3
hidden_0: (2, 5, 16)
attention_layers: 2
attention_0: (2, 2, 5, 5)
prob_sums: [1.0, 1.0]
两层 BERT 会得到 3 组隐藏状态,是因为通常还包含 embedding 输出;注意力则每个 Transformer 层一组,所以这里是 2 组。loss 是标量张量,而 logits 仍是未经 softmax 的分数;示例中的 probs 才是按类别归一化后的概率。
预测与分析时不要多取张量
只做线上分类推理时,通常读取 logits 就够了,不必开启 hidden_states 和 attentions。这些额外张量会随层数、序列长度和批大小增加显存占用,尤其注意力矩阵的两个序列维度都是 L,长序列下成本会迅速上升。
需要做表示分析、层间比较或特征抽取时再开启 hidden_states;确实要分析注意力分布且当前模型实现支持返回注意力时,再开启 attentions。训练时则让 labels 的格式与具体任务头保持一致,这样模型才能计算正确的 loss。
读取 ModelOutput 时,先看当前模型类定义了哪些字段,再用形状验证语义。字段名告诉你“这是什么”,张量形状告诉你“它对应批次、序列、隐藏维度、类别还是词表”,两者一起检查比只看数值可靠。